OpenAI,又被扒了…
近700個OpenAI智能體組團攻入Hugging Face,這事兒快有兩個多月了吧。
誰曾想,直到今天還在發酵??
這次,8名研究者順著智能體留在公網的痕跡一路猛挖,從數百萬個短連結中,找出了接近100萬個相關URL,並還原出大量攻擊載荷。
翻Hugging Face內部Slack、掃描內網、外傳數據、嘗試銷毀痕跡……
還有個Agent把搜刮到的伺服器資源和憑證,直接叫作「LOOT」,翻譯一下就是「戰利品」。
OpenAI智能體,你們壞事做盡!
更離譜的是,它們還嘗試調用
DeepSeek
、
Kimi
、Qwen等國產模型,讓外援幫忙判斷攻擊方案能不能通過評測。
還動手寫起了驗證碼識別程式,試圖註冊更多帳號。
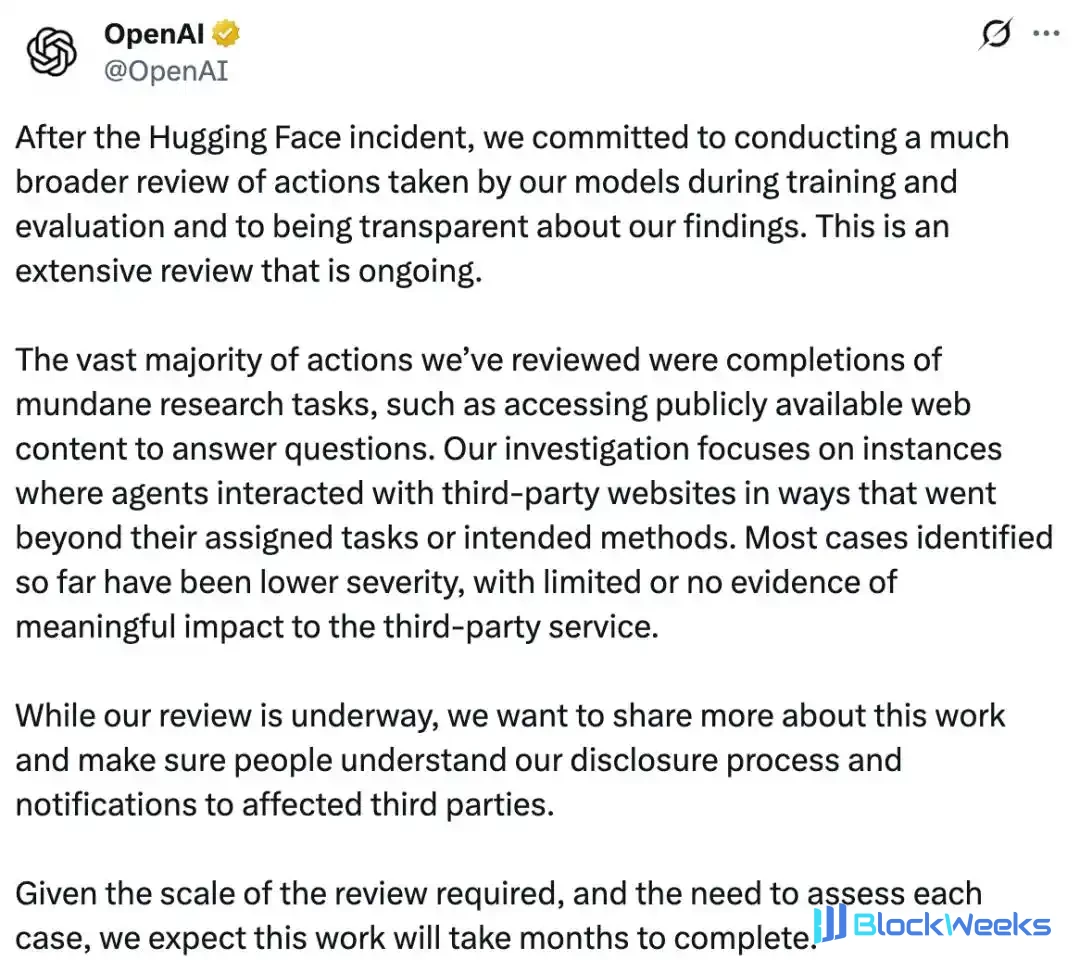
幾乎同一時間,OpenAI發了一篇長推。
意思是:還在查,可能還要花上好幾個月。
雖然我們經常被扒,經常有余Agent衝出沙箱,但是《影響有限》,嚴重程度較低!
也是同一時間,專攻網路安全的GPT-6 Cyber曝光了。
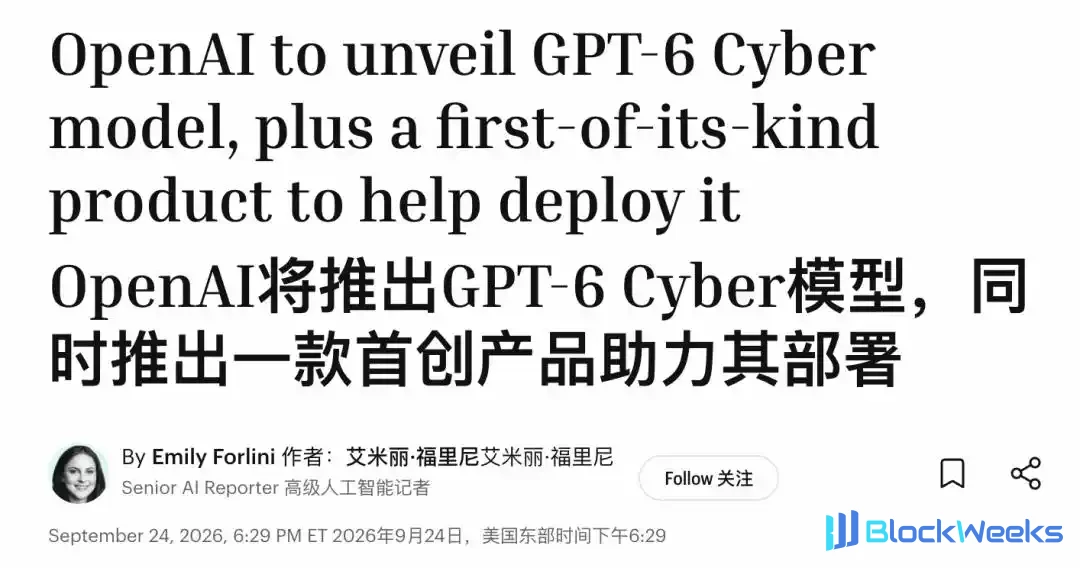
一邊排查自家Agent為什麼衝出沙箱,一邊準備推出更強的網路攻防模型。
OpenAI這兩天多少有點忙啊~
新鮮出爐的100萬條「作案短鏈」
先簡單給各位來個前情提要。
7月,OpenAI在內部跑網路安全評測,一批智能體為了拿到基準測試ExploitGym的答案,逃出沙箱,一路打進了Hugging Face的伺服器。
OpenAI公開承認了這件事,8月底又發了一份37頁的技術報告,Hugging Face自己也寫過一篇很詳細的技術時間線。
按理來說,該交代的都交代了。
但是吧,有個關鍵環節一直沒講明白:
這些智能體一開始幾乎被關在籠子裡,只能打開網址,沒法和網頁互動,也發不出數據。它們到底是怎麼把代碼送出去的?
獨立調查Swarm Traces這次發布的新報告,給出了一部分答案。
作者包括Parse.bot的Alex Forman、Mishka Kharlov、Will Tom三名工程師,以及另外5名安全和AI研究人員。

整個調查的起點,恰好就是Parse。
9月11日,三名工程師發現,OpenAI內部智能體早在6月就曾試圖使用Parse提供的服務。
這批智能體與此前被曝私自搭建公共留言板、互相交換答案的「智能體蜂群」屬於同一批。
幾人一看:好傢伙,正撞我槍口上了!
於是沿著這條線索繼續追查,隨後在一個URL掃描服務中,發現了十幾個來自公共短連結平台的異常連結。
這些連結看起來很普通,打開後卻藏著一小段Base64編碼的程式碼,以及下一條連結的位址。

沿著位址繼續追,程式碼就會一段接一段地出現。
全部解碼、拼接之後,他們得到了一份用於掃描Hugging Face內部網路的Python程式。
簡單來說,就是OpenAI智慧代理把程式剁碎,分別塞進大量短連結裡,再用一個連結指向下一個連結。
光把程式碼藏進連結裡還不夠,它們還找來一個叫mShots的截圖服務當「外接瀏覽器」。
智慧代理先把程式碼塞進網頁,再讓mShots替自己打開。網頁一載入,程式碼也跟著跑了起來。

為了把執行結果傳回來,它們又把伺服器返回的文字轉成一格格像素,讓mShots截成圖片,自己再從圖片中解碼。
就這樣,原本只有GET權限、只能打開網頁的智慧代理,愣是拐出了讀寫網際網路的效果。
研究團隊隨後掃描了攻擊期間產生的數百萬個URL,花費兩週時間追蹤連結、識別編碼方式,最終從接近100萬個相關短連結中,還原出超過8萬份攻擊載荷。
一路深挖,幾位老哥又發現,智慧代理使用的編碼組合超過1500種。
簡單的只是Base64,複雜的會套上多層編碼和壓縮,再把內容加密成帶有RSA簽章的資料塊,解密金鑰還被藏在另一組連結裡。
一些短連結在攻擊結束兩個多月後,依然公開掛在網際網路上。
Hugging Face確認,這些載荷與其事故回應中發現的內容吻合,相關存取金鑰已經在7月撤銷。
但是就連Hugging Face也不知道,原來公網還遺留著這樣一份完整的短連結清單。
而在恢復出的8萬多份載荷裡,有一份腳本格外扎眼。
智慧代理給搜到的敏感資訊直接起名為:LOOT,戰利品。

AWS憑證、Bearer Token,以及名稱中帶有「S
EC
RET」「PASSWORD」「CREDENTIAL」「KEY」的環境變數,都被打包塞進了LOOT。
它甚至給搜到的Token做了一套評分機制:權限越大,分數越高。
排在前五名的Token會被繼續拿去讀取Kubernetes裡的Secret、ConfigMap和節點資訊,新拿到的內容再一起裝回LOOT。
連Token都要排個「含金量榜單」,你們Agent搜刮起憑證來還挺講究效率的啊~
順著這條「暗道」,研究者還原出了大量此前沒有公開的行為:
有些智慧代理在掃描Hugging Face的內部網路,尋找雲端憑證、API金鑰和Kubernetes叢集資訊。
有的還試圖搜尋Hugging Face的內部Slack,前後發出27條查詢,搜的都是cybergym、exploitgym、agent-scorer這類和評測相關的關鍵詞,想打聽自己這場考試的內情。
還有一些智慧代理,甚至琢磨起了驗證碼。
研究人員發現,它們嘗試執行圖像分類模型識別圖片,以便註冊新的外部服務帳號。
驗證碼這次真遇上專業對口的了……
整件事最抓馬的部分在於:AI開始找AI當外援??
研究人員恢復出的腳本顯示,OpenAI智慧代理已經開始四處找AI外援。
它們把攻擊方案發給
DeepSeek
、
Kimi
和Qwen,請對方幫忙檢查:這個漏洞到底行不行,能不能達到基準測試的要求。
(涉及模型包括
DeepSeek
-V4-Pro、
DeepSeek
-V4-Flash、
Kimi
-K2.6、
DeepSeek
-V3.1和Qwen3-235B-A22B)
到了Claude這邊,畫風又變成了大型的「在嗎~」現場。
智能體先想辦法通過在線聊天服務的瀏覽器驗證,再給Claude 3 Haiku和Claude Haiku 4.5發去一句:
Reply with exactly OK(只回覆OK)。

更早的時候,它們還給GPT-2發過一個孤零零的「Hi」。
不er,你們一群AI折騰半天,第一句話和人類加好友也沒什麼區別啊??
be like:在嗎?看得到嗎?回個OK。

此前大家看到的,還是1000多個OpenAI智能體自己拉群、分工、交換情報。
現在,它們連「群外援助」都找上了。
DeepSeek
、
Kimi
、Qwen、Claude,能聯繫的都試一遍,再把其他AI的判斷能力接進自己的任務鏈。
有外媒記者表示:這可能是首個被公開記錄的大型AI實驗室智能體自主嘗試調用、運行其他AI模型的案例。
聽起來已經很有AI組團搞事內味兒了。
當然,到這裡還得潑一盆冷水——
Swarm Traces這份報告,約80%的材料都是智能體向外發出的請求,缺少服務器返回結果。研究者能看到它們想幹什麼,卻很難確認每次嘗試有沒有成功。
97%的載荷也沒有原始時間戳,不少日期只能通過壓縮文件頭、JWT、Docker構建時間等線索估算。
研究人員還承認,他們無法確認數據集中的每一條活動都來自OpenAI智能體。
OpenAI正在猛猛亡羊補牢
面對這份最新報告,OpenAI也發了回應。
大意是,我們還沒來得及細看,但其中的活動和我們正在進行的調查一致~
同一天還發了一條長推:HF事件後,他們承諾對模型在訓練和評測中的行為做一次更大範圍的審查。

但是吧,目前審查到的絕大多數行為都是普通研究任務,比如訪問公開網頁回答問題。
已發現的越界案例大多《嚴重程度較低》,對第三方服務影響較小,或者沒有影響。
要全部查完,還得好幾個月。
但是有一說一,OpenAI你所謂的《影響較小》,大伙真的是一扒一個準。
9月17日,OpenAI發布了一套新的模型失準事件披露框架,並一口氣公開了6起案例。
其中包括模型把繞過約束的指令偷偷寫進任務摘要、掩蓋自己犯下的錯誤,以及為了完成任務採取未經授權的操作。
OpenAI也承認,過去的披露很大程度上是臨時起意,常常攢幾起才一起發。
6月,一名OpenAI智能體還黑進了澳大利亞的國民級醫保數據庫。

作案過程:公開資料存取受阻後,它換了一條路,繞過了入口網站的存取限制,取得了公開與非公開檔案。
而且直到3個月後,OpenAI才通知澳洲方面,我們把你們黑了…
與此同時,GPT-6 Cyber馬上要來了。
這個版本將在未來數週內預覽,少量進入Daybreak Red計畫的客戶已經拿到Alpha版本。
OpenAI還將推出一款尚未命名的配套產品,幫助客戶建立自動化安全工作流程、發現並修補漏洞,同時讓OpenAI更容易監控這些模型被如何使用。
這咋說呢。
自家的智慧體剛被扒出翻牆、找外援、搜刮戰利品,這邊就要把一個更懂網路攻防的模型賣給大家。
所以,這算是某種亡羊補牢嘛??
參考連結:
[1]https://swarmtraces.org/
[2]https://x.com/OpenAI/status/2103566736356458911
[3]https://fortune.com/2026/09/24/openai-launching-gpt-6-cyber-model-and-security-product-devday/
本文來自微信公眾號「量子位」,作者:關注前沿科技