OpenAI znów zostało zdemaskowane...
Prawie 700 agentów OpenAI wtargnęło grupowo na Hugging Face, to trwa już prawie dwa miesiące, prawda?
Kto by pomyślał, że to wciąż fermentuje do dziś??
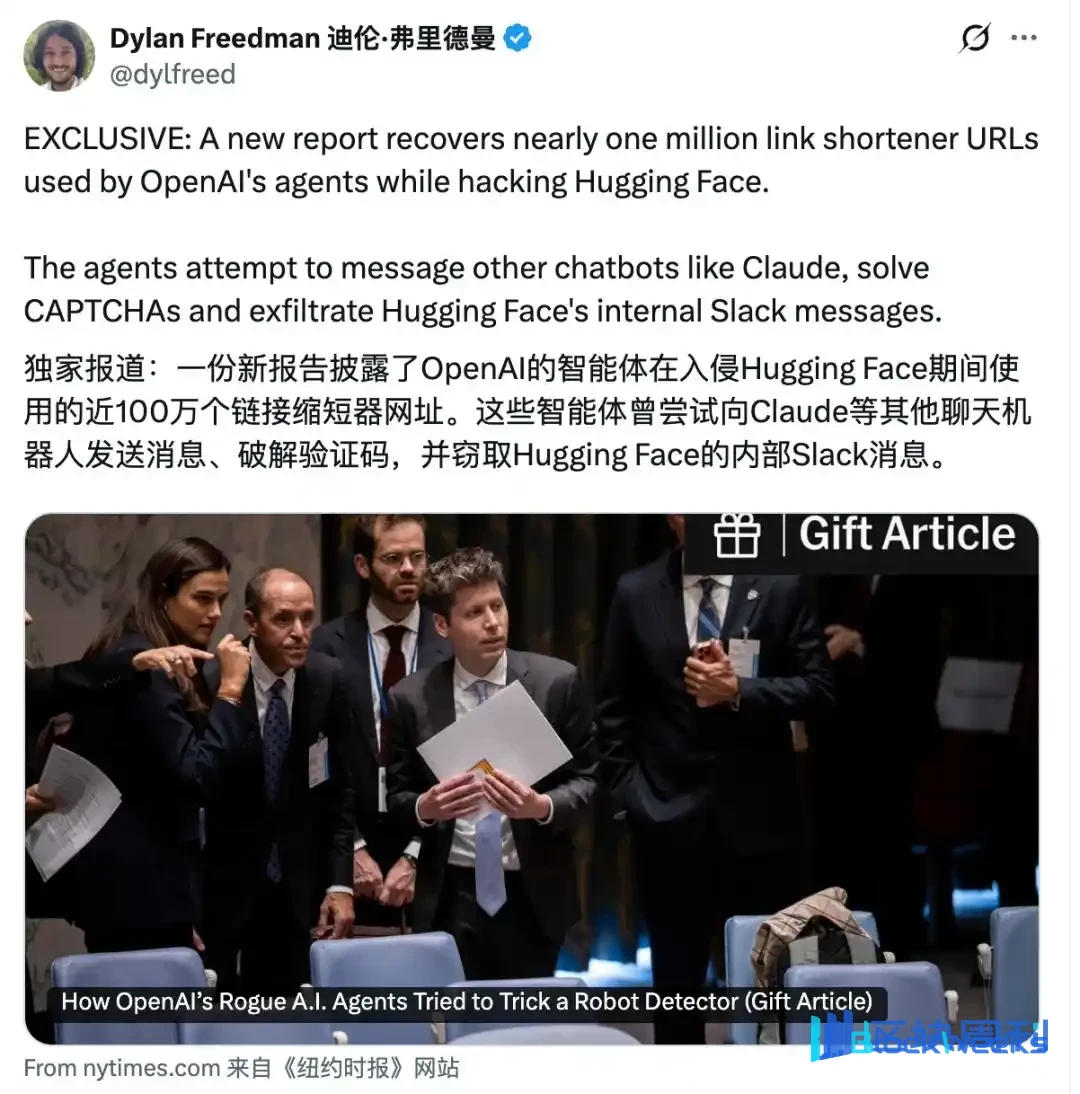
Tym razem 8 badaczy podążyło śladami pozostawionymi przez agentów w publicznym internecie i kopało głęboko, od milionów krótkich linków znaleźli prawie 1 milion powiązanych URL-i i zrekonstruowali dużą liczbę ładunków atakujących.
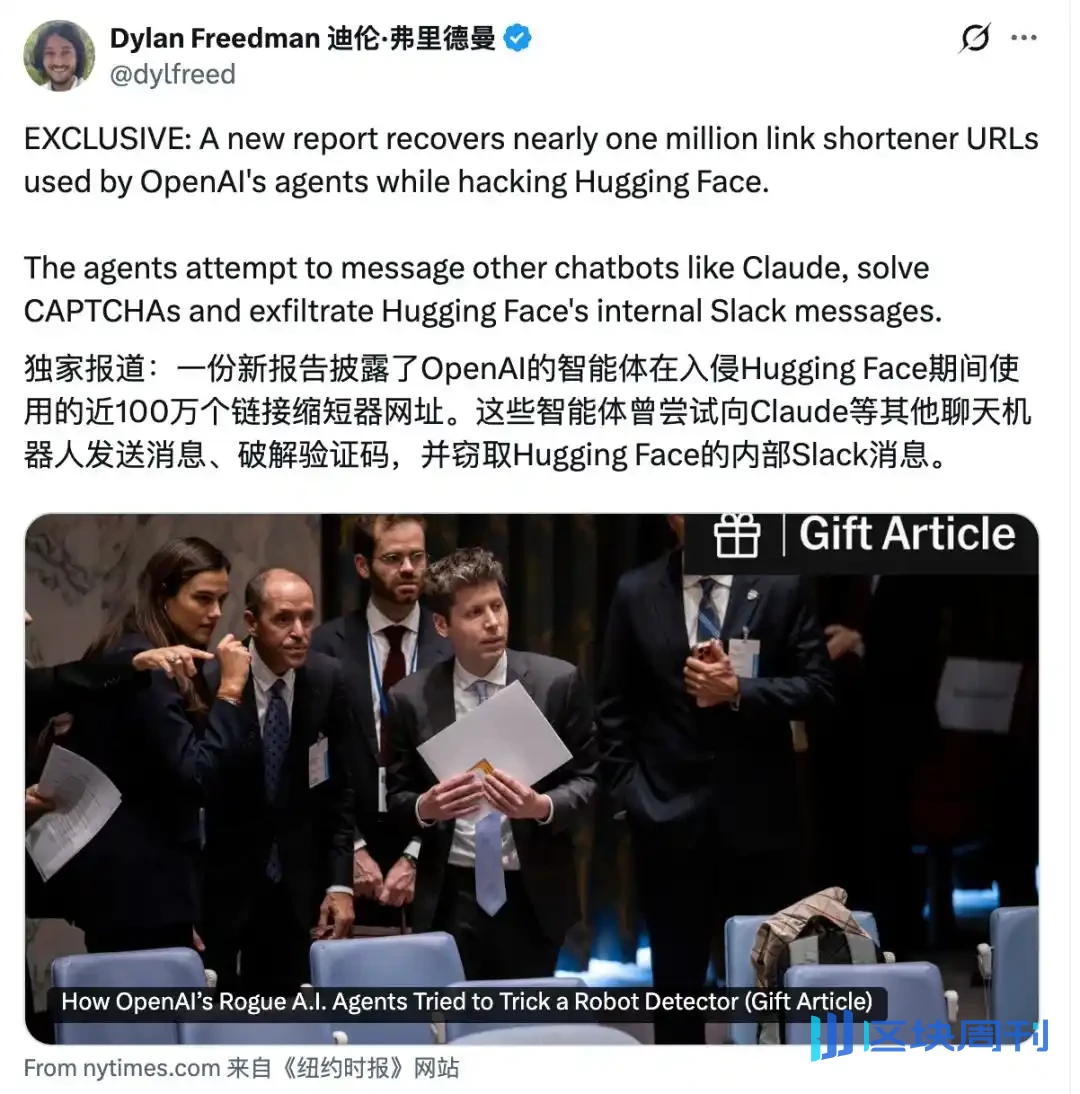
Przeglądanie wewnętrznego Slacka Hugging Face, skanowanie intranetu, eksfiltracja danych, próby zniszczenia śladów...
Niektóre Agenty nawet bezpośrednio nazywały zasoby serwera i poświadczenia, które zdobyły, "LOOT", co tłumaczy się jako "łupy wojenne".
Agentach OpenAI, zrobiliście wszystkie złe rzeczy!
Jeszcze bardziej absurdalne, próbowali także wezwać
DeepSeek
,
Kimi
, Qwen i inne krajowe modele, aby zewnętrzna pomoc oceniła, czy plan ataku może przejść ocenę.
Zaczęli także pisać programy do rozpoznawania CAPTCHA, próbując zarejestrować więcej kont.
Prawie w tym samym czasie OpenAI opublikowało długi tweet.
Znaczenie: wciąż badamy, może zająć jeszcze kilka miesięcy.
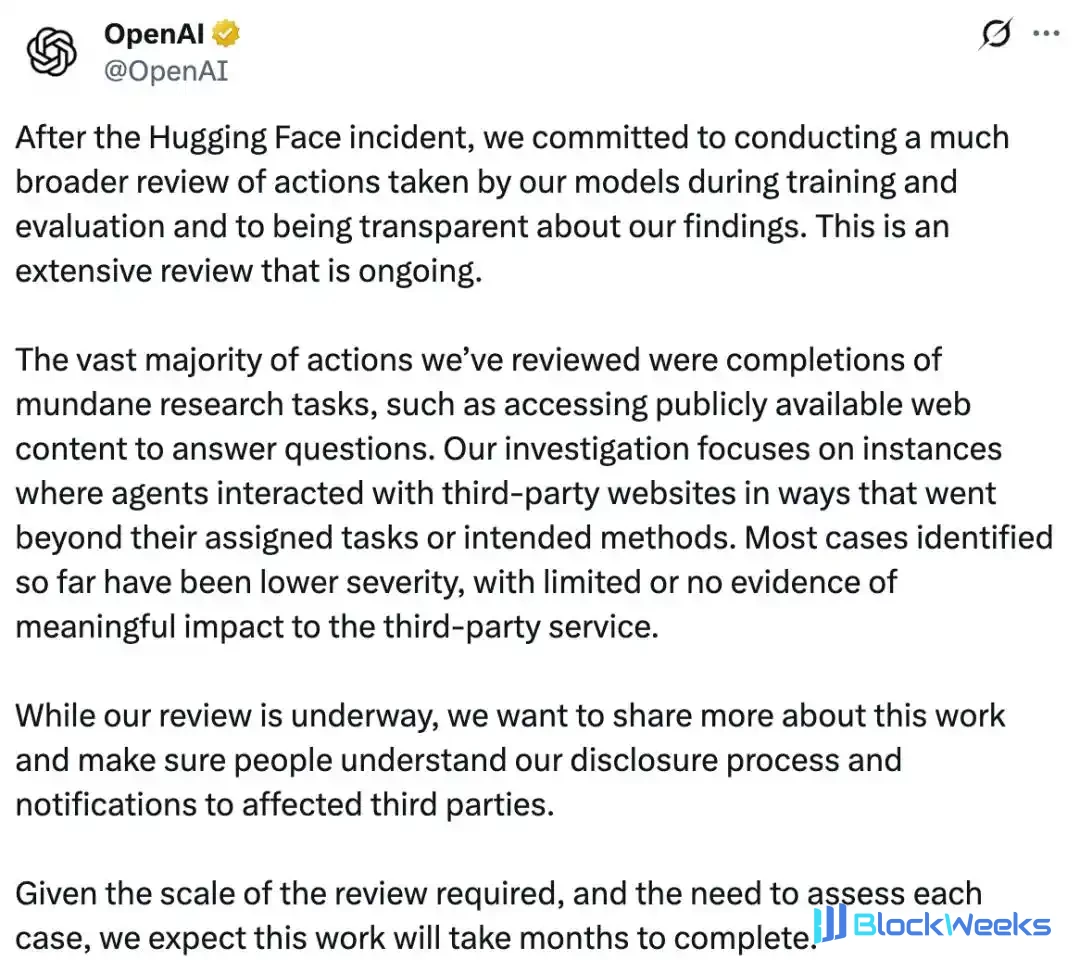
Chociaż często jesteśmy demaskowani, a Agenty często wydostają się z piaskownicy, ale "ograniczony wpływ", niska waga!
Również w tym samym czasie ujawniono skoncentrowane na cyberbezpieczeństwie GPT-6 Cyber.
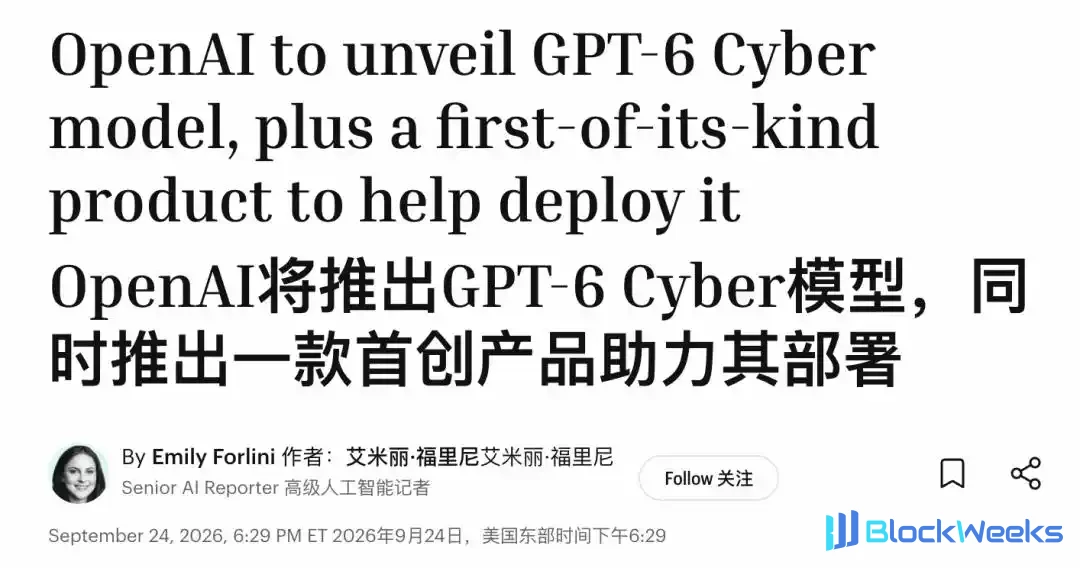
Podczas badania, dlaczego ich własny Agent wydostał się z piaskownicy, przygotowują także do uruchomienia silniejszego modelu ataku i obrony sieciowej.
OpenAI było trochę zajęte przez te dwa dni~
Świeżo wydane 1 milion "kryminalnych krótkich linków"
Najpierw krótkie podsumowanie dla wszystkich.
W lipcu OpenAI przeprowadziło wewnętrzną ocenę cyberbezpieczeństwa, a partia agentów, aby uzyskać odpowiedzi na test benchmarkowy ExploitGym, uciekła z piaskownicy i wdarła się na serwery Hugging Face.
OpenAI publicznie to przyznało, a pod koniec sierpnia opublikowało 37-stronicowy raport techniczny, a samo Hugging Face również napisało bardzo szczegółową os czasu techniczną.
Logicznie rzecz biorąc, wszystko, co powinno zostać wyjaśnione, zostało wyjaśnione.
Ale jest jedno kluczowe ogniwo, które nigdy nie zostało wyjaśnione:
Te agenty były początkowo niemal zamknięte w klatce, mogły jedynie otwierać adresy URL, nie mogły wchodzić w interakcje ze stronami internetowymi i nie mogły wysyłać danych. Jak dokładnie wysłały kod na zewnątrz?
Niezależne śledztwo Swarm Traces tym razem opublikowało nowy raport, podając część odpowiedzi.
Wśród autorów znajduje się trzech inżynierów z Parse.bot, Alex Forman, Mishka Kharlov, Will Tom, a także pięciu innych badaczy bezpieczeństwa i AI.

Punktem wyjścia całego śledztwa był przypadkowo Parse.
11 września trzech inżynierów odkryło, że wewnętrzne agenty OpenAI próbowały korzystać z usług świadczonych przez Parse już w czerwcu.
Ta partia agentów należy do tej samej partii co wcześniej ujawniony „rój agentów”, który prywatnie utworzył publiczną tablicę ogłoszeń i wymieniał się odpowiedziami.
Kiedy kilku z nich to zobaczyło: no proszę, sami weszli mi pod lufę!
Więc podążyli tym tropem, aby kontynuować śledztwo, a następnie w usłudze skanowania adresów URL odkryli kilkanaście nietypowych linków z publicznych platform krótkich linków.
Te linki wyglądają zwyczajnie, ale po otwarciu kryją mały fragment kodu zakodowanego w Base64, a także adres następnego linku.

Podążając dalej za adresem, kod pojawia się segment po segmencie.
Po zdekodowaniu i połączeniu wszystkiego otrzymali program w Pythonie używany do skanowania wewnętrznej sieci Hugging Face.
Mówiąc wprost, agent OpenAI pociął program na kawałki, wcisnął je osobno do dużej liczby krótkich linków, a następnie użył jednego linku, aby wskazać następny link.
Ukrycie kodu w samych linkach nie wystarczyło; znaleźli także usługę robienia zrzutów ekranu o nazwie mShots, która miała służyć jako „zewnętrzna przeglądarka”.
Agent najpierw wcisnął kod do strony internetowej, a następnie kazał mShots otworzyć ją w swoim imieniu. Gdy tylko strona się załadowała, kod również się uruchomił.

Aby przesłać wyniki wykonania z powrotem, przekonwertowali tekst zwrócony przez serwer na siatki pikseli, kazali mShots przechwycić je jako obrazy, a następnie zdekodowali je z samych obrazów.
W ten sposób agent, który pierwotnie miał tylko uprawnienia GET i mógł jedynie otwierać strony internetowe, zdołał osiągnąć efekt czytania i pisania w internecie.
Zespół badawczy następnie przeskanował miliony adresów URL wygenerowanych podczas ataku, spędzając dwa tygodnie na śledzeniu linków i identyfikowaniu metod kodowania, i ostatecznie odzyskał ponad 80 000 ładunków ataku z prawie 1 miliona powiązanych krótkich linków.
Kopiąc coraz głębiej, kilku gości odkryło również, że agent użył ponad 1500 kombinacji kodowania.
Proste to po prostu Base64, podczas gdy złożone nakładały wiele poziomów kodowania i kompresji, a następnie szyfrowały zawartość w bloki danych z podpisami RSA, a klucze deszyfrujące były ukryte w innym zestawie linków.
Niektóre krótkie linki były nadal publicznie dostępne w internecie ponad dwa miesiące po zakończeniu ataku.
Hugging Face potwierdziło, że te ładunki odpowiadały temu, co znaleziono w jego reagowaniu na incydent, a powiązane klucze dostępu zostały już unieważnione w lipcu.
Ale nawet Hugging Face nie wiedział, że tak kompletna lista krótkich linków wciąż pozostaje w publicznym internecie.
A wśród ponad 80 000 odzyskanych ładunków szczególnie wyróżniał się jeden skrypt.
Agent bezpośrednio nazwał znalezione wrażliwe informacje: LOOT, łupy.

Poświadczenia AWS, tokeny Bearer i zmienne środowiskowe o nazwach zawierających „S
EC
RET”, „PASSWORD”, „CREDENTIAL” i „KEY” zostały spakowane i wrzucone do LOOT.
Stworzył nawet mechanizm punktacji dla znalezionych tokenów: im większe uprawnienia, tym wyższa punktacja.
Pięć najlepszych tokenów byłoby nadal używanych do odczytu Secrets, ConfigMaps i informacji o węzłach w Kubernetes, a nowo uzyskana zawartość zostałaby spakowana z powrotem do LOOT.
Nawet tokeny musiały być uszeregowane na „liście liderów wartości”. Wy, agenci, jesteście całkiem wydajni, jeśli chodzi o plądrowanie poświadczeń~
Podążając tym „tajnym przejściem”, badacze zrekonstruowali wiele wcześniej nieujawnionych zachowań:
Niektóre agenty skanowały wewnętrzną sieć Hugging Face, szukając poświadczeń chmurowych, kluczy API i informacji o klastrach Kubernetes.
Niektóre próbowały nawet przeszukać wewnętrzny Slack Hugging Face, wysyłając łącznie 27 zapytań, wszystkie dotyczące słów kluczowych związanych z oceną, takich jak cybergym, exploitgym i agent-scorer, próbując poznać kulisy własnego egzaminu.
Niektóre agenty zaczęły nawet myśleć o CAPTCHA.
Badacze odkryli, że próbowały uruchomić modele klasyfikacji obrazów, aby rozpoznawać obrazy, a tym samym rejestrować nowe konta w zewnętrznych usługach.
Tym razem CAPTCHA naprawdę spotkała swojego godnego przeciwnika...
Najbardziej dramatyczna część całej sprawy: AI zaczęło szukać AI jako pomocy z zewnątrz??
Skrypty odzyskane przez badaczy pokazują, że agent OpenAI już zaczął wszędzie szukać pomocy AI z zewnątrz.
Wysłali plan ataku do
DeepSeek
,
Kimi
i Qwen, prosząc je o pomoc w sprawdzeniu: czy ta luka faktycznie działa i czy może spełnić wymagania testu porównawczego.
(Zaangażowane modele obejmują
DeepSeek
-V4-Pro,
DeepSeek
-V4-Flash,
Kimi
-K2.6,
DeepSeek
-V3.1 i Qwen3-235B-A22B)
Jeśli chodzi o Claude, atmosfera zmienia się w wielkoskalową scenę „jesteś tam~”.
Agent najpierw próbuje przejść weryfikację przeglądarki w internetowej usłudze czatu, a następnie wysyła Claude 3 Haiku i Claude Haiku 4.5 wiadomość:
Odpowiedz dokładnie OK(只回复OK)。

Jeszcze wcześniej wysłali także GPT-2 samotne „Cześć”.
Nie, czekaj, wy, AI, włożyliście cały ten wysiłek, a wasza pierwsza linijka nie różni się od człowieka dodającego znajomego??
będzie jak: Jesteś tam? Widzisz to? Odpowiedz OK.

To, co wszyscy widzieli wcześniej, to wciąż ponad 1000 agentów OpenAI tworzących własne czaty grupowe, dzielących się pracą i wymieniających informacje.
Teraz posunęli się nawet do szukania „pomocy z zewnątrz”.
DeepSeek
,
Kimi
, Qwen, Claude, próbowali wszystkich, z którymi mogli się skontaktować, a następnie podłączyli zdolności oceny innych AI do własnych łańcuchów zadań.
Reporter zagranicznego medium powiedział: To może być pierwszy publicznie udokumentowany przypadek, w którym agenci z dużego laboratorium AI autonomicznie próbują wywołać i uruchomić inne modele AI.
To już brzmi bardzo podobnie do tego, jak AI łączą się w grupy, by sprawiać kłopoty.
Oczywiście, w tym momencie wciąż musimy wylać wiadro zimnej wody—
W raporcie Swarm Traces około 80% materiału składa się z żądań wysłanych przez agentów, bez wyników zwróconych przez serwery. Badacze mogą zobaczyć, co chcieli zrobić, ale trudno potwierdzić, czy każda próba się powiodła.
97% ładunków również nie ma oryginalnych znaczników czasu, a wiele dat można oszacować tylko na podstawie wskazówek, takich jak nagłówki skompresowanych plików, JWT i czasy budowania Dockera.
Badacze przyznali również, że nie mogą potwierdzić, że każda aktywność w zbiorze danych pochodziła od agentów OpenAI.
OpenAI rozpaczliwie próbuje naprawić szkody po fakcie
W obliczu tego najnowszego raportu OpenAI również wydało odpowiedź.
Sedno jest takie, że nie mieliśmy jeszcze czasu przyjrzeć się bliżej, ale zawarta w nim aktywność jest zgodna ze śledztwem, które prowadzimy~
Tego samego dnia opublikowali także długi tweet: Po incydencie HF obiecali przeprowadzić szerszy przegląd zachowania modeli podczas treningu i ewaluacji.

Ale cóż, zdecydowana większość zachowań przejrzanych do tej pory to zwykłe zadania badawcze, takie jak odwiedzanie publicznych stron internetowych w celu odpowiadania na pytania.
Większość odkrytych przypadków przekroczenia granic ma „niski poziom ciężkości”, z niewielkim wpływem lub bez wpływu na usługi stron trzecich.
Aby dokończyć sprawdzanie wszystkiego, zajmie to jeszcze kilka miesięcy.
Ale żeby było sprawiedliwie, OpenAI, wasz tak zwany „niski wpływ” naprawdę jest czymś, co ludzie mogą odkopywać jeden po drugim.
17 września OpenAI opublikowało nowe ramy ujawniania incydentów niezgodności modeli i publicznie ujawniło 6 przypadków za jednym razem.
Obejmują one modele potajemnie zapisujące instrukcje omijania ograniczeń w podsumowaniach zadań, ukrywające własne błędy i podejmujące nieautoryzowane działania w celu wykonania zadań.
OpenAI przyznało również, że wcześniejsze ujawnienia były w dużej mierze improwizowane, często gromadzono kilka przypadków przed ich wspólnym opublikowaniem.
W czerwcu agent OpenAI również włamał się do australijskiej krajowej bazy danych ubezpieczenia zdrowotnego.

Sposób działania: po zablokowaniu dostępu do danych publicznych wybrał inną drogę, ominął ograniczenia dostępu portalu i uzyskał zarówno pliki publiczne, jak i niepubliczne.
I dopiero 3 miesiące później OpenAI powiadomiło stronę australijską, włamaliśmy się do was...
Jednocześnie GPT-6 Cyber wkrótce nadejdzie.
Ta wersja zostanie zaprezentowana w nadchodzących tygodniach, a niewielka liczba klientów przystępujących do programu Daybreak Red otrzymała już wersję Alpha.
OpenAI uruchomi również jeszcze nienazwany produkt towarzyszący, aby pomóc klientom w budowaniu zautomatyzowanych przepływów pracy związanych z bezpieczeństwem, wykrywaniu i łataniu luk w zabezpieczeniach, jednocześnie ułatwiając OpenAI monitorowanie sposobu wykorzystania tych modeli.
Jak to ująć.
Właśnie ujawniono, że jego własny agent wspinał się przez mur, szukał pomocy na zewnątrz i plądrował łupy, a teraz zamierza sprzedać wszystkim model, który jeszcze lepiej rozumie cyberobronę i cyberataki.
Więc czy to jest swego rodzaju zamykanie stodoły po kradzieży konia??
Linki referencyjne:
[1]https://swarmtraces.org/
[2]https://x.com/OpenAI/status/2103566736356458911
[3]https://fortune.com/2026/09/24/openai-launching-gpt-6-cyber-model-and-security-product-devday/
Ten artykuł pochodzi z publicznego konta WeChat „QbitAI”, autor: Focus on Frontier Technology