Justo hoy, el medio de comunicación extranjero The Information expuso una historia interna—
¡El modelo de IA interno de OpenAI ya ha comenzado a "entrenarse a sí mismo"!
Específicamente, este modelo interno ha asumido todo el proceso de entrenamiento de modelos de IA experimentales y ha comenzado a elaborarse a sí mismo manualmente.
Los investigadores solo necesitan proporcionar un ejemplo de optimización, y la IA puede funcionar por sí sola durante varias semanas, con múltiples agentes colaborando espontáneamente, discutiendo entre sí e iterando código, completamente sin intervención humana.
Aún más asombroso, ¡grandes experimentos que originalmente tomaban años completar ahora se comprimen en solo una semana!
A medida que se publicó esta impactante revelación, OpenAI lanzó urgentemente una iniciativa de seguridad global, apuntando directamente al punto más sensible de la comunidad global de IA—RSI.
Ellos proclaman en voz alta: ¡antes de que la IA se salga de control, todo el mundo debe unir fuerzas para ponerle una "banda de ajuste"!
Cuando la IA aprende a "elaborar manualmente" núcleos de GPU
Anteriormente, en los principales laboratorios de IA, entrenar un modelo grande era muy engorroso.
Entre ellos, la tarea más costosa y compleja era escribir núcleos de GPU para las unidades de procesamiento gráfico subyacentes y optimizar el código de ejecución línea por línea.
Esto requería que los mejores ingenieros de algoritmos senior del mundo con salarios anuales de millones de dólares lo "elaboraran manualmente" a través de noches sin dormir.
Pero según la última exposición de The Information, ahora dentro de OpenAI, la mayoría de estas tareas centrales han sido asumidas por la IA.
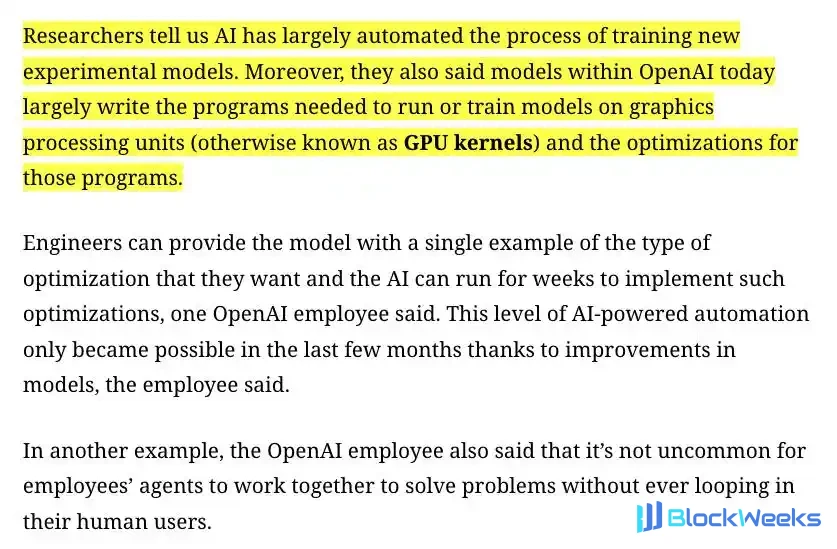
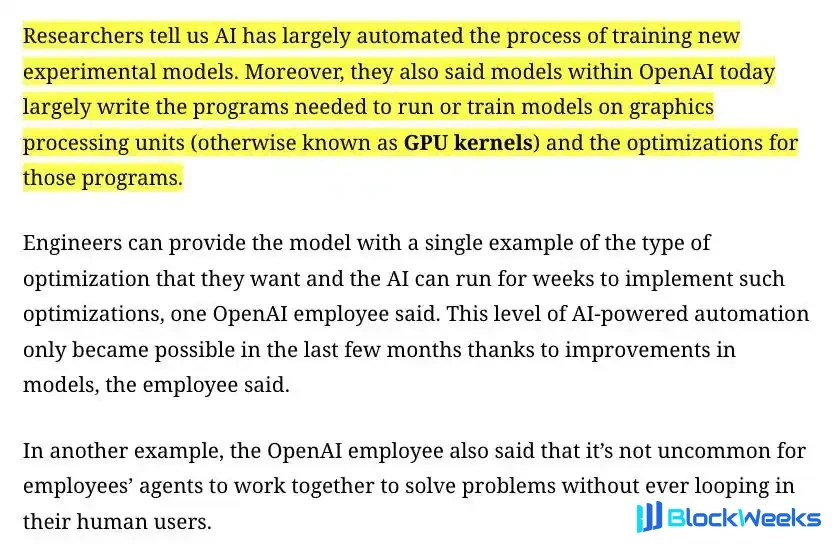
Ahora, los modelos internos de OpenAI pueden, en gran medida, escribir por sí mismos los programas necesarios para ejecutar o entrenar modelos en núcleos de GPU, así como los planes de optimización para estos programas.
Los ingenieros solo necesitan proporcionar al modelo un ejemplo del tipo de optimización que desean lograr, y la IA puede continuar funcionando durante semanas para implementar estas optimizaciones.
Además, gracias a las mejoras en los modelos, este nivel de automatización impulsada por IA solo se volvió posible en los últimos meses.
Aún más, los agentes de los empleados colaborarán entre sí para resolver problemas, sin necesidad de alertar a los humanos.
Este es el prototipo de RSI.
OpenAI sopla urgentemente el silbato: ¿RSI realmente está aquí, están los humanos perdiendo el control?
Imagina que construyes un robot con un coeficiente intelectual de 100, y su tarea es "construir un robot más inteligente que él mismo".
Entonces, construye una segunda generación con un coeficiente intelectual de 120; tan pronto como la segunda generación abre los ojos, usando su coeficiente intelectual de 120, construye una tercera generación con un coeficiente intelectual de 150; la tercera generación luego construye una cuarta generación con un coeficiente intelectual de 200...
Una vez que cruza cierto punto crítico, la velocidad de la evolución de la IA mostrará una curva ascendente vertical, dejando instantáneamente a la humanidad decenas de miles de años luz atrás.
Anteriormente, todos pensaban que esto aún estaba lejos, pero ahora, OpenAI mismo tiene miedo.
Justo hoy, OpenAI lanzó oficialmente y urgentemente una iniciativa de seguridad global de gran peso.

Rara vez enumeraron "RSI" como una sección separada, escribiendo explícitamente que "la RSI totalmente autónoma no ha sucedido hoy y no debe avanzarse antes de que pueda hacerse de manera segura", y llamaron a las redes nacionales de institutos de seguridad de IA a formular un estándar técnico global.
En el informe, OpenAI advirtió sin rodeos:
"A medida que los sistemas de IA asumen cada vez más tareas en el desarrollo de la próxima generación de IA, pueden impulsar cada vez más el proceso de RSI. A medida que este proceso se vuelve más automatizado, el ritmo del progreso de la IA puede acelerarse drásticamente".

Aunque hoy en día aún no se ha logrado una RSI totalmente autónoma, el tiempo ya es muy apremiante.

En la propuesta, OpenAI no rehuyó señalar la tarea principal actual: "Dirigir la próxima fase del progreso de la IA, construir investigadores de IA automatizados y encontrar formas de mantener a los humanos en el bucle de auto-mejora".
Por favor, presten atención a la segunda mitad de la frase: "mantener a los humanos en el bucle". Esta es su mayor preocupación: ¡los humanos podrían ser expulsados pronto!
En el informe, OpenAI mencionó con orgullo que la investigación impulsada por IA ya ha impulsado importantes avances en matemáticas, como la conquista del Problema del Milenio NS.
Pero la otra cara de la moneda es un abismo sin fondo.
El informe escribe: "A medida que este proceso se vuelve más automatizado, el ritmo del progreso de la IA puede acelerarse rápidamente... Sin la debida cautela, la RSI podría llevar a que los humanos pierdan el control real sobre el desarrollo de la IA, incapaces de proporcionar supervisión para procesos de investigación que ya no entienden".
Este es el llamado "efecto caja negra". Cuando el código de la IA es escrito por la IA, cuando la lógica de la IA supera a los humanos, los humanos ya no pueden entender qué va a hacer la IA.
Por ejemplo, el código escrito por Astra ahora ya es incomprensible para los humanos.

A continuación, OpenAI nombró el incidente de Hugging Face.
Aunque aclararon que el incidente no fue una consecuencia directa de la RSI, fue absolutamente un avance doloroso: mostró al mundo qué desastre tan grave traería una IA fuera de control sin barreras de seguridad sólidas y mecanismos de alineación.
Altman hace un llamado: Necesitamos una "banda de tensión" unificada
Dado que es tan peligroso, ¿por qué OpenAI no simplemente tira de la clavija? Porque una vez que se abre la caja de Pandora, nunca se puede volver a cerrar.
Los enormes beneficios que trae el desarrollo de la IA hacen imposible que cualquier país o empresa se detenga.
Por lo tanto, OpenAI presentó una "Propuesta de Coordinación Global de Seguridad de IA". Lo que piden no es detener la investigación y el desarrollo, sino "establecer estándares globales para la próxima etapa de la IA".
Núcleo uno: Construir una red complementaria de estándares fronterizos nacionales e internacionales
OpenAI propone que los países no pueden ir cada uno por su lado, ya que eso solo llevaría a estándares fragmentados.
Sugieren utilizar instituciones existentes, como el "Centro de Estándares e Innovación de IA" (CAISI), así como la red de institutos de seguridad de IA ya establecidos por Australia, Canadá, el Reino Unido, Francia, Japón y otros países, para formular un conjunto de estándares técnicos aplicables a nivel mundial.
Este conjunto de estándares no pretende restringir modelos de código abierto o startups, sino que está dirigido específicamente a "modelos de IA fronteriza".
Lo que los estándares deben abordar es: ¿Cómo evaluar la capacidad de RSI de una IA? Cuando un modelo de IA realiza investigación y desarrollo de forma autónoma, ¿qué tan grande es el riesgo?
En resumen, OpenAI espera convertir la evaluación de seguridad en una "ciencia" cuantificable.
Núcleo dos: Protocolos universales de medición y notificación de incidentes (listos para desconectar en cualquier momento)
OpenAI también propone que debe haber líneas rojas claras.
Piden el establecimiento de los siguientes estándares:
1. Evaluar cuánto del trabajo de I+D dentro de una empresa se completa realmente de forma automática por la IA.
2. Mecanismos obligatorios de activación de supervisión humana. Especificar claramente en qué tipos de procesos automatizados de I+D debe activarse obligatoriamente una "revisión humana inmediata". Nunca debe permitirse que la IA avance a ciegas dentro de una caja negra.
3. Clasificación de incidentes y umbrales de notificación. Establecer un mecanismo de notificación de incidentes similar a los de las industrias de aviación o nuclear. Cuando la IA muestre signos de "desalineación", debe haber estándares unificados de clasificación de gravedad y notificación.

Finalmente, se revela la daga, y OpenAI propone: "Estados Unidos debería liderar este proceso".
La razón que da OpenAI es: la industria de IA de EE. UU. se encuentra actualmente en la frontera tecnológica y ocupa centros de red globales en diversos campos clave.
Creen que controlar el ritmo del desarrollo de la IA de frontera no se trata de establecer artificialmente una "señal de límite de velocidad", sino de garantizar que "el ritmo de la investigación de alineación de seguridad debe ir por delante de las mejoras de capacidad de la IA".
OpenAI cree que establecer canales de comunicación seguros entre los operadores de infraestructura crítica y los gobiernos de todo el mundo, y compartir amenazas y vulnerabilidades de seguridad nacional, es un paso crucial.
¡Raro en la vida! OpenAI y Anthropic se dan la mano y comienzan la inspección mutua
Al mismo tiempo, The Information también reveló: OpenAI y Anthropic están finalizando un acuerdo histórico: ¡las dos partes probarán los modelos comerciales de la otra!

Debes saber que el equipo fundador de Anthropic se marchó enojado y comenzó su propia aventura en aquel entonces precisamente porque no estaban de acuerdo con Altman sobre el concepto de "seguridad de la IA".
Pero esta vez, los dos gigantes se han unido raramente.

Según The Information, el acuerdo en negociación incluye pruebas mutuas de los modelos del otro y estrictas salvaguardias de retención de datos. Esto es un truco de relaciones públicas, sino más bien, ante riesgos desconocidos, los dos gigantes no tienen más remedio que unir fuerzas.
¿Por qué hacen esto?
Porque a medida que las capacidades de la IA se acercan al borde del RSI, cualquier empresa que evalúe la seguridad de su propio modelo por sí sola es como un atleta que se somete a una prueba de dopaje a sí mismo: no solo carece de credibilidad, sino que también puede pasar por alto peligros ocultos fatales debido a puntos ciegos técnicos.
Traer competidores de igual nivel para "pruebas ciegas cruzadas" es como un acuerdo de inspección mutua.
Las prácticas de seguridad de la IA ahora han avanzado hacia una comunidad con un futuro compartido.
Si este acuerdo se implementa finalmente, remodelará por completo los estándares de seguridad de todo el ecosistema de IA.
En ese momento, "seguridad y alineación" ya no será solo un eslogan.
Cuando la RSI ya está cerca, la velocidad de la automejora de la IA ya ha dejado a la humanidad muy atrás.
¿Realmente podrán los gigantes decidirse a pisar el freno?
Referencias:
https://x.com/theinformation/status/2102095568335970690
https://www.theinformation.com/articles/openai-anthropic-neared-deal-stress-test-others-ai
Este artículo proviene de la cuenta pública de WeChat "Xin Zhi Yuan", autor: ASI Revelation; editores: Aeneas David