
En resumen
- Claude Opus 5.5 se lanzó el martes con un precio de $4 y $20 por millón de tokens de entrada y salida, un 40% más barato que Opus 5 en la configuración predeterminada, mientras que Anthropic dice que iguala a Fable 5.1 en la mayoría de las tareas.
- Según los propios números de Anthropic, Opus 5.5 lidera a Fable 5.1 y Opus 5 en pruebas de codificación y trabajo de conocimiento, pero GPT-6 Astra aún lo supera en AutomationBench y Terminal-Bench-Science 0.1.
- Es el primer modelo que Anthropic ha lanzado desde que el CEO Dario Amodei pidió a la industria frenar las ganancias en capacidades de IA, y lleva las mismas salvaguardas de ciberseguridad y biología que Fable 5.1.
Anthropic lanzó Claude Opus 5.5 el martes, el primer modelo de lo que la compañía llama su familia Claude 5.5. Anthropic dice que el nuevo modelo rinde al nivel de Claude Fable 5.1, su buque insignia más caro, en la mayoría de las tareas.
El giro es que el modelo cuesta un 20% menos de ejecutar que Opus 5, el modelo al que reemplaza, y es un 60% más barato que Fable 5.1, la oferta más avanzada de la compañía.
El modelo, al parecer, es muy capaz. Es el modelo más avanzado tanto en versión (5.5 frente a la 5.1 de Fable) como en familia (Opus es el modelo más grande disponible públicamente, seguido de Sonnet, siendo Haiku el más pequeño).
Anthropic admite que la brecha entre Fable y Opus es más estrecha de lo que sugieren sus puntuaciones de referencia, pero estar disponible públicamente en el plan, y ser más barato por token, lo convierte en la elección obvia para la mayoría de los usuarios de Claude.
Opus 5 se lanzó en julio con un precio inferior y superando a Fable 5 en la mayoría de las pruebas de referencia, y Fable 5.1 llegó a principios de septiembre e invirtió esa situación, superando a Opus 5 en todas las pruebas de referencia que Anthropic publicó.
Opus 5.5 vuelve a cerrar la brecha, esta vez en precio en lugar de en puntuaciones brutas. Lovable, una plataforma de desarrollo que sometió a Opus 5 a sus propias pruebas de programación en julio, dijo en un comunicado compartido por Anthropic que el modelo anterior era "más estable, con mucha menos variación de una ejecución a otra" que lo que vino antes—el mismo argumento de eficiencia que Anthropic está presentando de nuevo ahora.
Opus 5.5 también es el primer modelo que Anthropic ha lanzado desde que el CEO Dario Amodei publicó un ensayo en el que pedía a la industria que redujera el ritmo, argumentando que las mejoras en las capacidades de la IA están superando las pruebas de seguridad destinadas a mantenerlas bajo control. "Debemos frenar el ritmo al que mejoramos las capacidades de los modelos de IA", escribió Amodei a principios de este mes.
Anthropic mide la mayor parte de este progreso a través de la codificación agéntica: trabajo realizado por un agente de IA, un modelo que lleva a cabo acciones de varios pasos por sí solo en lugar de limitarse a responder a una única instrucción.
En Terminal-Bench 4.0, que evalúa si un agente puede completar tareas profesionales complejas dentro de una interfaz de línea de comandos y puntúa el resultado como un porcentaje de tareas completadas, Opus 5.5 alcanzó el 66,4%, por delante del 55,8% de Fable 5.1 y el 57,9% de GPT-6 Astra. FrontierCode, que comprueba si los cambios de código de un agente realmente se fusionarían en un pipeline de ingeniería real utilizando esa misma puntuación de tasa de éxito, situó a Opus 5.5 en el 54,4% frente al 50,3% de Fable 5.1.
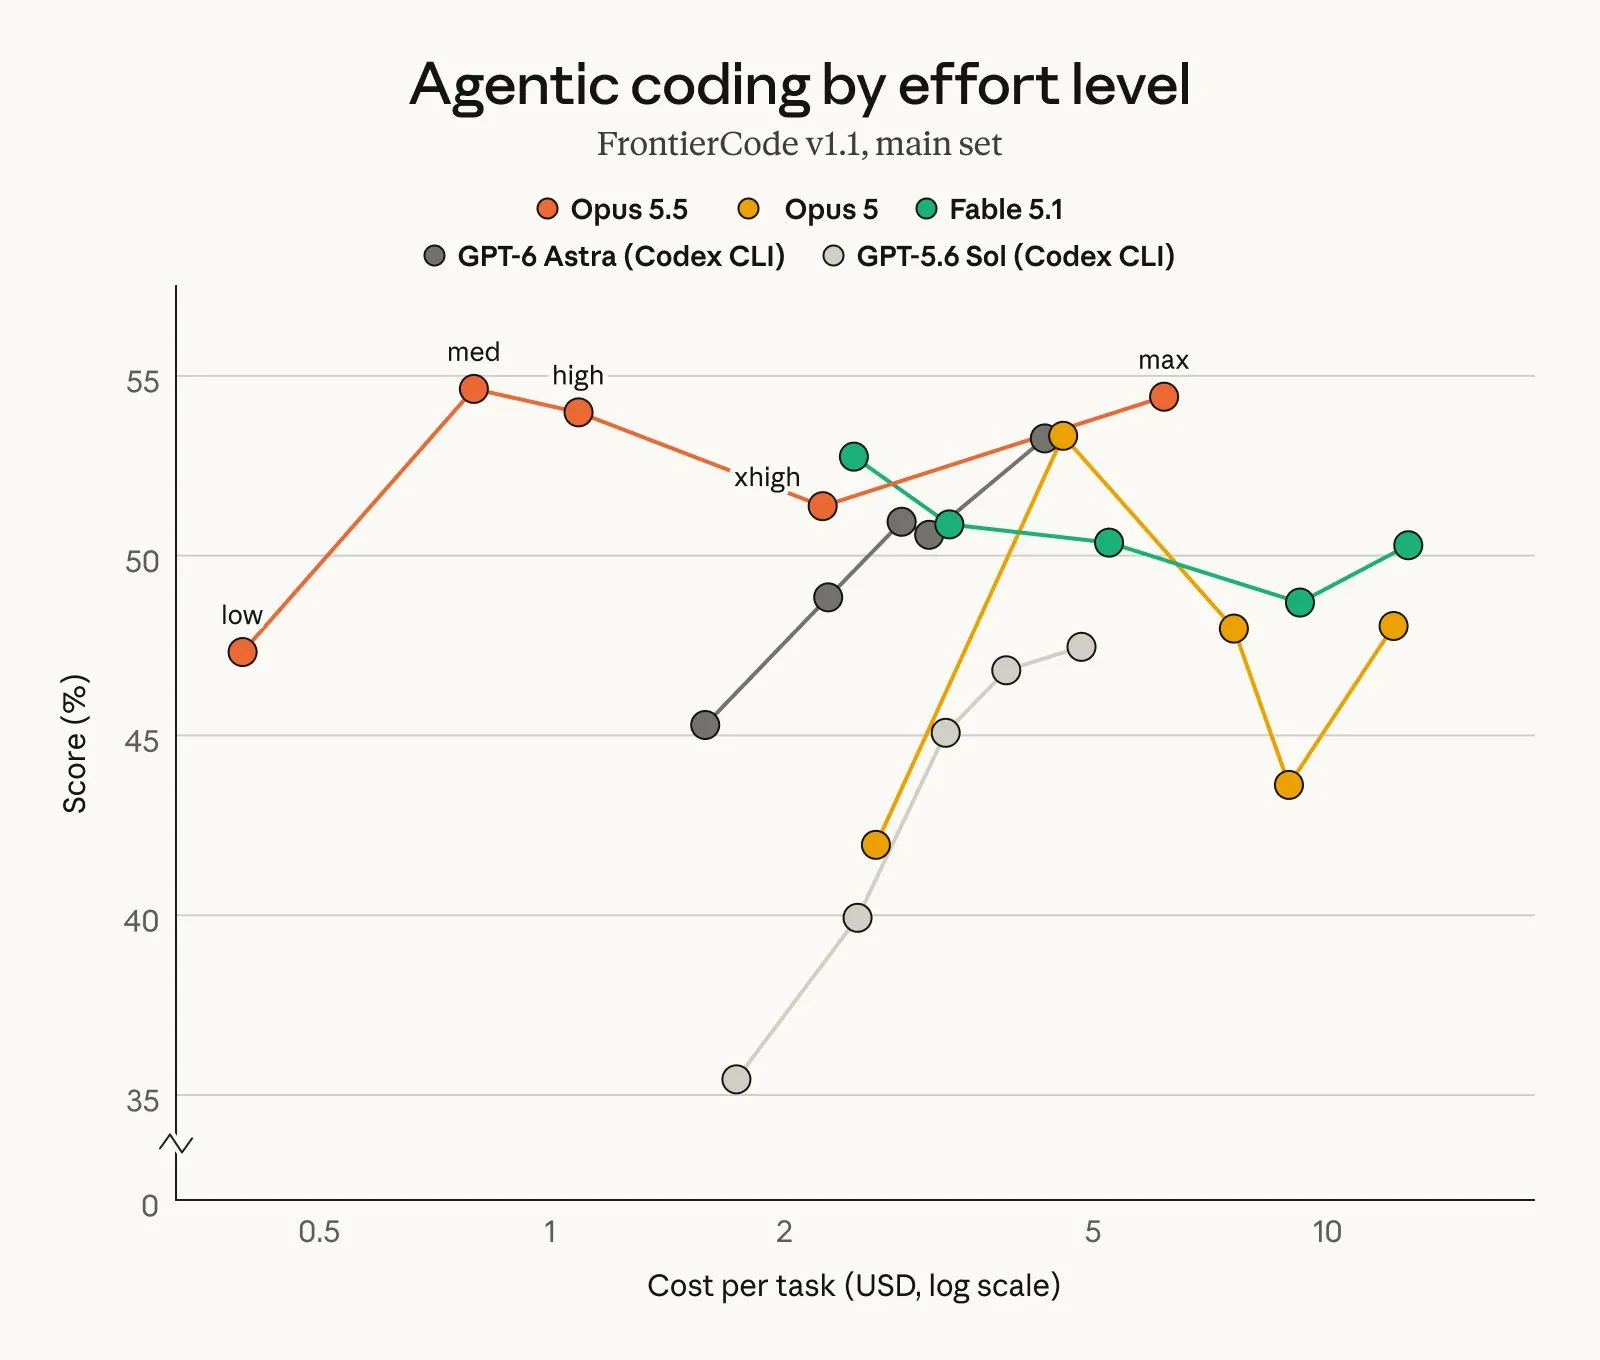
En GDPval-AA v2.1, que califica el trabajo profesional del mundo real en 44 ocupaciones utilizando Elo —el mismo sistema de clasificación estilo ajedrez que se usa para medir la habilidad relativa en lugar de un porcentaje plano—, Opus 5.5 obtuvo 1846 frente a los 1735 de Fable 5.1 y los 1708 de Opus 5.
Sin embargo, Opus 5.5 no lidera en todos los ámbitos. En AutomationBench, un benchmark creado por Zapier que puntúa si un agente puede llevar a cabo un flujo de trabajo empresarial completo de principio a fin sin ayuda humana, el 41,4% de GPT-6 Astra supera por poco el 40,0% de Opus 5.5.
En Terminal-Bench-Science 0.1, que evalúa la investigación científica agéntica llevada a cabo dentro de un entorno de línea de comandos utilizando ese mismo método de tasa de éxito, el 64,6% de Astra supera el 58,7% de Opus 5.5 por un margen más amplio.
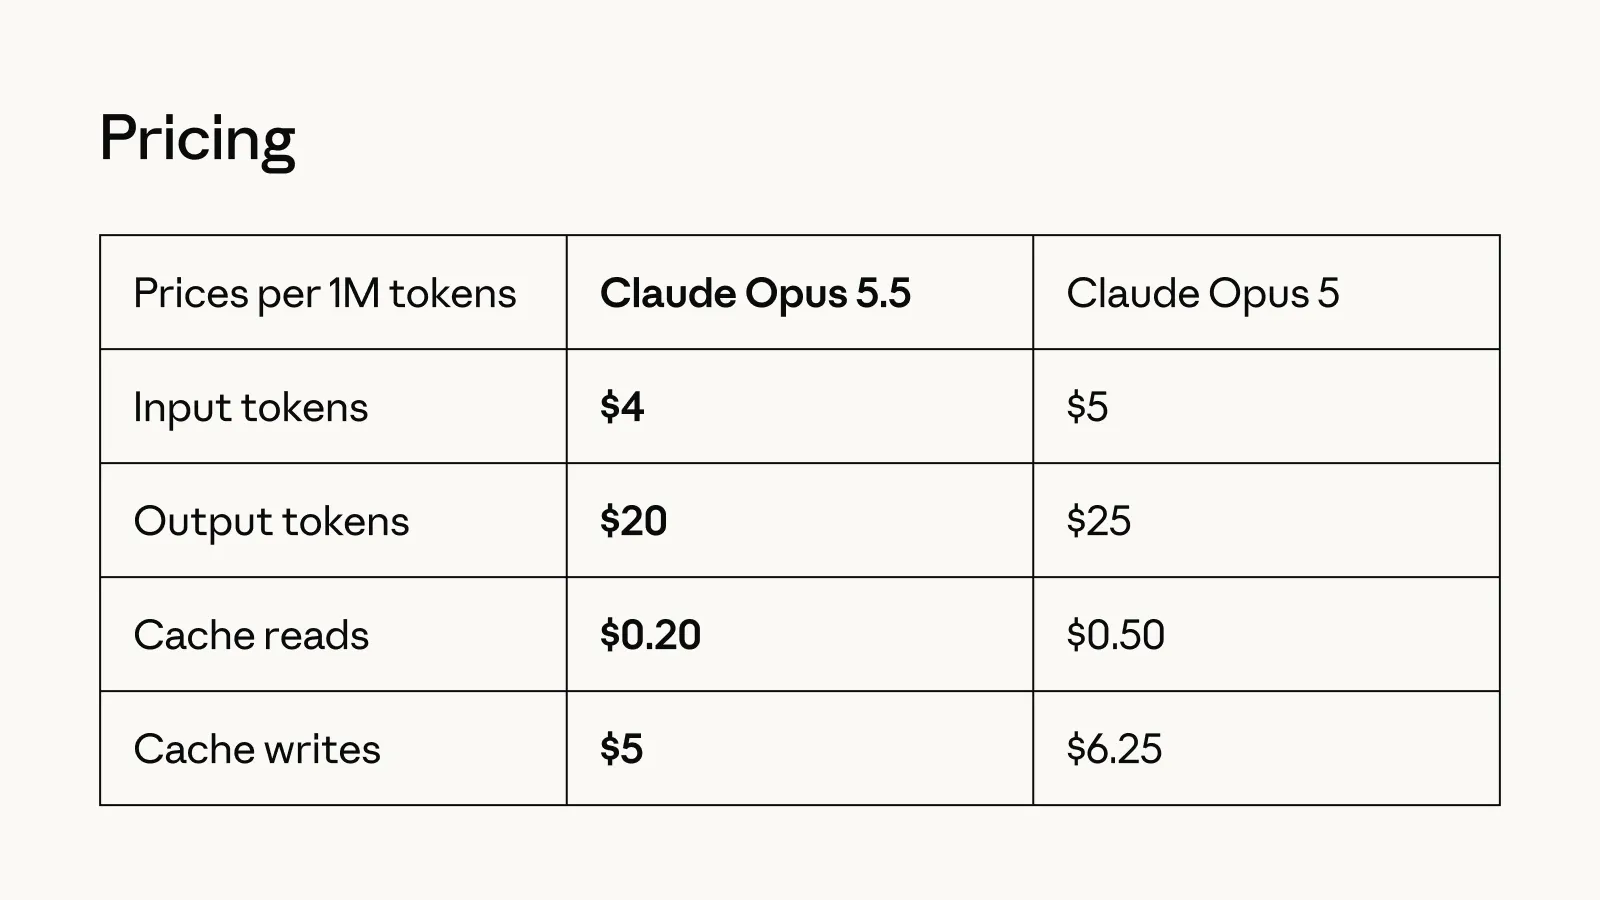
El mayor argumento de venta es el costo. Los tokens de entrada—los fragmentos de texto que un modelo lee y escribe, con precio por millón—ahora cuestan $4 para Opus 5.5 frente a $5 para Opus 5, y los tokens de salida bajan a $20 desde $25. Las lecturas de caché, que significan reutilizar el contexto que un modelo ya ha procesado en lugar de reprocesarlo desde cero y que generan la mayor parte del costo en sesiones largas de codificación agéntica, caen un 60% a $0.20 por millón de tokens.
Debido a que Opus 5.5 iguala a los modelos de clase Mythos de Anthropic—el nivel más restringido de la compañía, reservado para investigadores de ciberseguridad y biología verificados—en esas dos capacidades, se lanza con las mismas salvaguardas que Fable 5.1.
La mayoría de las tareas de ciberseguridad se redirigen automáticamente al anterior Opus 4.8, algo de lo que muchos desarrolladores y usuarios se han quejado anteriormente..
Opus 5.5 ya está disponible en todas las plataformas de Anthropic, incluidas Amazon Web Services, Google Cloud y Microsoft Azure. Sonnet 5.5 y Haiku 5.5 llegarán en las próximas semanas, según Anthropic, llevando las mismas reducciones de precios al resto de la línea.





