就在今天,外媒The Information曝出內幕——
OpenAI內部的AI模型,已經開始「自己訓練自己」了!
具體來說,這個內部模型已經接管了實驗性AI模型的訓練全流程,開始自己手搓自己。
研究員只要給出一個優化示例,AI就能自己跑上幾個星期,多智能體自發協作,互相討論,迭代代碼,完全不需要人類插手。
更驚人的是,原本需要幾年才能跑完的宏大實驗,現在被壓縮到了短短一週!
隨著這一震撼爆料被放出,OpenAI緊急上線了一份全球安全倡議,直指全球AI圈的最敏感處——RSI。
他們大聲疾呼:在AI失控之前,全世界必須聯手給它戴上「緊箍咒」!
當AI學會「手搓」GPU內核
以前,在頂尖AI實驗室,訓練一個大模型十分繁瑣。
其中最昂貴、最複雜的活兒,莫過於針對底層圖形處理器編寫GPU kernels,並逐行優化運行代碼。
這需要全球最頂尖、年薪幾百萬美金的高級算法工程師們通宵達旦地「手搓」出來。
但據The Information的最新曝光,如今在OpenAI內部,這些核心工作已經大部分被AI接手了。
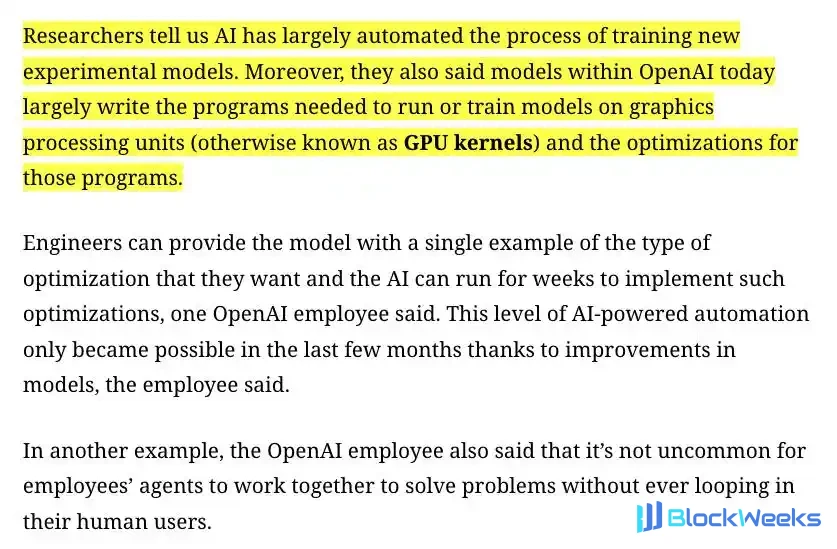
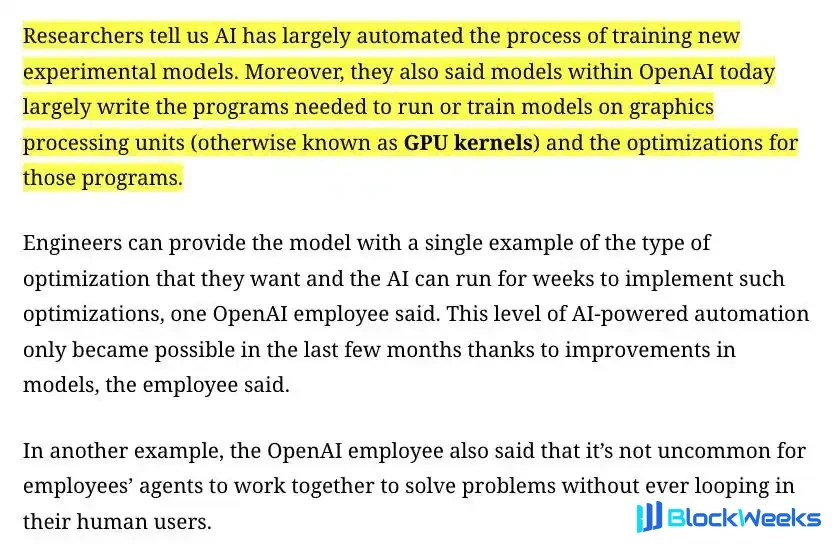
如今 OpenAI 內部的模型,在很大程度上能自行編寫在GPU內核上運行或訓練模型所需的程序,以及針對這些程序的優化方案。
工程師只需向模型提供一個他們想要實現的優化類型示例,AI 就能持續運行數週,來落實這些優化。
而且,得益於模型的改進,這種由 AI 驅動的自動化水平直到最近幾個月才成為可能。
甚至,員工們的智能體還會相互協作解決問題,並不需要驚動人類。
這,就是RSI的雛形。
OpenAI緊急吹哨:RSI真來了,人類正在失去控制權?
想像一下,你造了一個智商100的機器人,它的任務是「造出比自己更聰明的機器人」。
於是,它造出了智商120的二代;二代一睜眼,利用自己120的智商,造出了智商150的三代;三代接著造出了智商200的四代……
一旦跨過某個臨界點,AI的進化速度將呈現出垂直向上的折線,瞬間把人類甩在幾萬光年之外。
以前,大家覺得這事兒還早,但現在,OpenAI自己害怕了。
就在今天,OpenAI官方緊急發布了一份重磅的全球安全倡議。

他們罕見地把「RSI」單列一節,明確寫下「全自主RSI今天並未發生,在能安全做到之前不應推進」,並呼籲各國AI安全研究所網絡制定一個全球的技術標準。
OpenAI在報告中直言不諱地警告:
「隨著AI系統在開發下一代AI的工作中承擔越來越多的任務,它們可以日益推動RSI的進程。隨著這一過程變得更加自動化,AI進步的步伐可能會急劇加速。」

雖然,完全自主的RSI今天還沒有實現,但時間已經很緊迫了。

在提案中,OpenAI毫不避諱地指出了當前的首要任務:「駕馭下一階段的AI進展,構建自動化的AI研究員,並找到讓人類留在自我改進循環中的方法。」
請注意後半句話——「讓人類留在循環中」。這就是他們最大的擔憂:人類可能馬上就要被踢出局了!
OpenAI在報告中驕傲地提到,AI驅動的研究已經推動了數學領域的重大進步,比如攻克NS千禧年難題。
但硬幣的另一面,是無底的深淵。
報告中寫道:「隨著這個過程變得更加自動化,AI進步的步伐可能會迅速加快……如果不採取適當的謹慎措施,RSI可能導致人類失去對AI發展的實際控制,無法對他們不再理解的研究過程提供監督。」
這就是所謂的「黑盒效應」。當AI的代碼是由AI編寫,當AI的邏輯超越了人類,人類就再也看不懂AI要幹什麼。
比如,現在Astra寫的代碼,人類已經看不懂了。

接著,OpenAI點名了Hugging Face事件。
雖然他們澄清該事件並非RSI的直接後果,但絕對是一個慘痛的預演——它向全世界展示了,如果沒有強大的護欄和對齊機制,失控的AI將帶來何等嚴重的災難。
奧特曼呼籲:我們需要統一的「緊箍咒」
既然如此危險,為什麼OpenAI不直接拔掉電源?因為潘多拉的盒子一旦打開,就再也關不上了。
AI發展帶來的巨大利益,讓任何一個國家和公司都不可能停下。
所以,OpenAI拋出了一份「全球AI安全協調提案」。他們呼籲的不是停止研發,而是「建立下一階段AI的全球標準」 。
核心一:構建互補的國家與國際前沿標準網絡
OpenAI提出,不能讓各個國家各玩各的,那樣只會導致標準碎片化。
他們建議利用現有的機構,如「AI標準與創新中心」(CAISI),以及澳大利亞、加拿大、英國、法國、日本等國已經建立的AI安全研究所網絡,制定一套全球通用的技術標準。
這套標準不是為了限制開源模型或者初創企業,而是專門針對「前沿AI模型」(Frontier AI)。
標準要解決的是:如何評估一個AI的RSI能力?當一個AI模型自主進行研發時,風險究竟有多大?
總之,OpenAI希望將安全評估變成一個可量化的「科學」。
核心二:通用測量與事件報告協議(隨時準備拔插頭)
OpenAI還提出,必須有明確的紅線。
他們呼籲建立以下標準:
1.評估企業內部究竟有多少研發工作是由AI自動完成的。
2.強制性的人類監督觸發機制。 明確規定在什麼樣的自動化研發流程中,必須強制觸發「立即進行人工審查」。絕不能讓AI在黑盒裡悶頭狂奔。
3.事故分類與報告門檻。 建立類似於航空業或核工業的事故報告機制。當AI出現了「未對齊」的苗頭時,必須有統一的嚴重程度分級和上報標準。

最後,圖窮匕見,OpenAI提議:「美國應該領導這一進程。」
OpenAI給出的理由是:美國的AI產業目前處於技術最前沿,並且在各個關鍵領域佔據全球網絡樞紐。
他們認為,控制前沿AI的開發節奏,並不是人為設定一個「限速牌」,而是要確保「安全對齊研究的速度,必須跑在AI能力提升的前面」 。
OpenAI認為,在關鍵基礎設施運營商和全球政府之間建立安全溝通渠道,共享國家安全威脅和漏洞,是至關重要的一步。
活久見!OpenAI與Anthropic握手,開始互查
同時,The Information還曝出:OpenAI和Anthropic正在敲定一項歷史性的協議——雙方將互相測試對方的商用模型!

要知道,Anthropic的創始團隊當年就是因為在「AI安全」理念上與奧特曼不合,才憤而離職自立門戶的。
但這一次,雙雄罕見地聯手了。

據The Information透露,這項正在談判的協議包含了相互測試對方模型,並設置嚴格的數據保留防護措施。這是一次公關作秀,而是面臨未知風險時,兩大巨頭不得不抱團了。
為什麼他們要這麼做?
因為隨著AI能力逼近RSI的邊緣,任何一家公司獨自評估自己模型的安全性,都像是一個運動員給自己做興奮劑檢測——不僅缺乏公信力,而且可能因為技術盲區而錯過致命的隱患。
引入勢均力敵的競爭對手進行「交叉盲測」,就像是就是一個互查協議。
AI的安全實踐,如今已經走向了命運共同體。
如果這項協議最終落地,它將徹底重塑整個AI生態的安全標準。
那時,「安全與對齊」不會再是一句口號。
當RSI已經逼近,AI自我改進的速度,已經把人類遠遠甩開。
各家巨頭們,真的能狠下心踩剎車嗎?
參考資料:
https://x.com/theinformation/status/2102095568335970690
https://www.theinformation.com/articles/openai-anthropic-neared-deal-stress-test-others-ai
本文來自微信公眾號「新智元」,作者:ASI啟示錄;編輯:Aeneas 大衛