Саме сьогодні іноземне медіа The Information оприлюднило внутрішню історію—
Внутрішня AI-модель OpenAI вже почала «тренувати саму себе»!
Зокрема, ця внутрішня модель взяла на себе весь процес тренування експериментальних AI-моделей і почала вручну створювати себе.
Дослідникам достатньо надати приклад оптимізації, і AI може працювати самостійно протягом кількох тижнів, при цьому кілька агентів спонтанно співпрацюють, обговорюють один з одним та ітерують код, повністю без втручання людини.
Ще більш вражаюче, грандіозні експерименти, які раніше займали роки, тепер стискаються до одного тижня!
Коли ця шокуюча інформація була оприлюднена, OpenAI терміново запустила глобальну ініціативу з безпеки, спрямовану безпосередньо на найчутливіше місце в глобальній AI-спільноті—RSI.
Вони гучно закликають: перш ніж AI вийде з-під контролю, весь світ повинен об'єднати зусилля, щоб накласти на нього «стягувальний ремінь»!
Коли AI вчиться «вручну створювати» ядра GPU
Раніше в провідних AI-лабораторіях тренування великої моделі було дуже громіздким.
Серед них найдорожчим і найскладнішим завданням було написання ядер GPU для базових графічних процесорів та оптимізація робочого коду рядок за рядком.
Це вимагало від найкращих у світі старших інженерів-алгоритмістів з річною зарплатою в мільйони доларів «вручну створювати» це через безсонні ночі.
Але згідно з останнім викриттям The Information, тепер в OpenAI більшість цих основних завдань перебрали на себе AI.
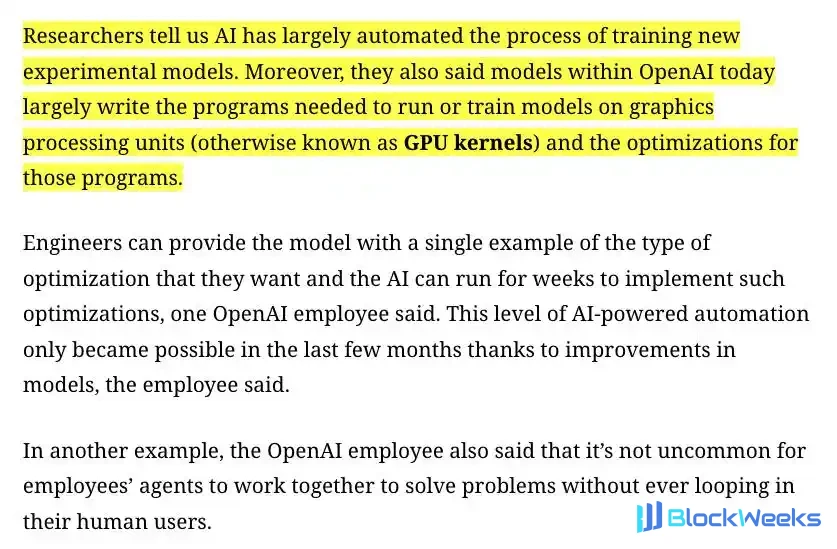
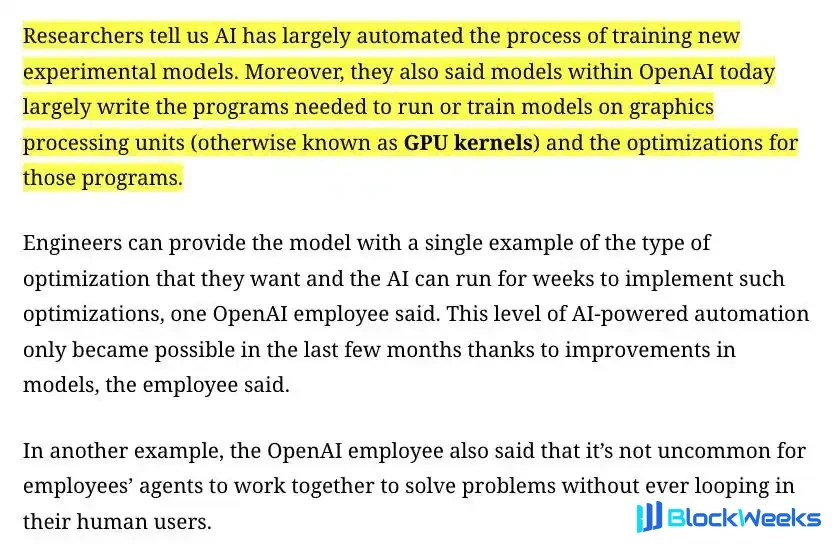
Тепер внутрішні моделі OpenAI можуть значною мірою самостійно писати програми, необхідні для запуску або тренування моделей на ядрах GPU, а також плани оптимізації для цих програм.
Інженерам потрібно лише надати моделі приклад типу оптимізації, яку вони хочуть досягти, і AI може продовжувати працювати тижнями, щоб реалізувати ці оптимізації.
Більше того, завдяки вдосконаленню моделей, цей рівень автоматизації на основі AI став можливим лише в останні місяці.
Ще більше, агенти співробітників співпрацюватимуть один з одним для вирішення проблем, без необхідності повідомляти людей.
Це прототип RSI.
OpenAI терміново б'є на сполох: RSI справді тут, чи втрачають люди контроль?
Уявіть, що ви створюєте робота з IQ 100, і його завдання — «створити робота розумнішого за себе».
Отже, він створює друге покоління з IQ 120; як тільки друге покоління розплющує очі, використовуючи свій IQ 120, воно створює третє покоління з IQ 150; третє покоління потім створює четверте покоління з IQ 200...
Як тільки воно перетне певну критичну точку, швидкість еволюції AI покаже вертикальну висхідну криву, миттєво залишивши людство на десятки тисяч світлових років позаду.
Раніше всі думали, що це ще далеко, але тепер сам OpenAI боїться.
Саме сьогодні OpenAI офіційно терміново випустила важковагову глобальну ініціативу з безпеки.

Вони рідко виділяли «RSI» як окремий розділ, чітко написавши, що «повністю автономний RSI не стався сьогодні і не повинен просуватися, поки це не можна буде зробити безпечно», і закликали національні мережі інститутів безпеки AI сформулювати глобальний технічний стандарт.
У звіті OpenAI відверто попереджає:
«Оскільки системи ШІ беруть на себе все більше й більше завдань у розробці наступного покоління ШІ, вони можуть дедалі більше керувати процесом RSI. У міру того, як цей процес стає більш автоматизованим, темпи прогресу ШІ можуть різко прискоритися».

Хоча повністю автономний RSI ще не досягнуто сьогодні, час уже дуже підтискає.

У пропозиції OpenAI не ухиляється від зазначення поточного першочергового завдання: «Спрямувати наступну фазу прогресу ШІ, створити автоматизованих дослідників ШІ та знайти способи зберегти людей у циклі самовдосконалення».
Зверніть увагу на другу половину речення — «зберегти людей у циклі». Це їхнє найбільше занепокоєння: людей можуть незабаром викинути!
У звіті OpenAI з гордістю згадує, що керовані ШІ дослідження вже спричинили значні прориви в математиці, наприклад, підкорення проблемі тисячоліття NS.
Але інший бік медалі — бездонна прірва.
У звіті написано: «У міру того, як цей процес стає більш автоматизованим, темпи прогресу ШІ можуть швидко прискоритися... Без належної обережності RSI може призвести до того, що люди втратять фактичний контроль над розробкою ШІ, не зможуть забезпечити нагляд за дослідницькими процесами, яких вони більше не розуміють».
Це так званий «ефект чорної скриньки». Коли код ШІ написаний ШІ, коли логіка ШІ перевершує людську, люди більше не можуть зрозуміти, що ШІ збирається робити.
Наприклад, код, написаний Astra зараз, уже незрозумілий для людей.

Далі OpenAI назвала інцидент із Hugging Face.
Хоча вони уточнили, що інцидент не був прямим наслідком RSI, це був абсолютно болісний передвісник — він показав світові, яку серйозну катастрофу принесе ШІ, що вийшов з-під контролю, без надійних запобіжників і механізмів вирівнювання.
Альтман закликає: нам потрібна єдина «стягувальна стрічка»
Якщо це так небезпечно, чому OpenAI просто не вимкне все? Тому що як тільки скриньку Пандори відкрито, її вже ніколи не можна закрити знову.
Величезні переваги, які приносить розвиток ШІ, роблять неможливим для будь-якої країни чи компанії зупинитися.
Тому OpenAI висунула «Глобальну пропозицію щодо координації безпеки ШІ». Вони закликають не зупиняти дослідження та розробки, а «встановити глобальні стандарти для наступного етапу ШІ».
Основне перше: побудувати взаємодоповнювальну мережу національних і міжнародних передових стандартів
OpenAI пропонує, щоб країни не йшли кожна своїм шляхом, оскільки це призведе лише до фрагментованих стандартів.
Вони пропонують використовувати існуючі інституції, такі як «Центр стандартів та інновацій ШІ» (CAISI), а також мережу інститутів безпеки ШІ, уже створених Австралією, Канадою, Великою Британією, Францією, Японією та іншими країнами, для формулювання набору технічних стандартів, застосовних у всьому світі.
Цей набір стандартів не має на меті обмежити відкриті моделі чи стартапи, а спеціально спрямований на «передові моделі ШІ».
Стандарти повинні вирішити: Як оцінити здатність ШІ до RSI? Коли модель ШІ проводить дослідження та розробки автономно, наскільки великий ризик?
Коротко кажучи, OpenAI сподівається перетворити оцінку безпеки на вимірювану «науку».
Ядро друге: Універсальні протоколи вимірювання та звітування про інциденти (готовність вимкнути в будь-який момент)
OpenAI також пропонує, щоб існували чіткі червоні лінії.
Вони закликають до встановлення таких стандартів:
1. Оцінити, яка частина досліджень і розробок всередині підприємства фактично виконується автоматично ШІ.
2. Обов'язкові тригерні механізми людського нагляду. Чітко вказати, у яких видах автоматизованих процесів досліджень і розробок обов'язково має запускатися «негайний людський перегляд». ШІ ніколи не можна дозволяти мчати наосліп у чорній скриньці.
3. Класифікація інцидентів і пороги звітування. Створити механізм звітування про інциденти, подібний до тих, що існують в авіаційній або ядерній галузях. Коли ШІ виявляє ознаки «неузгодженості», мають бути уніфіковані стандарти градації серйозності та звітування.

Нарешті, кинджал розкрито, і OpenAI пропонує: «Сполучені Штати повинні очолити цей процес».
Причина, яку наводить OpenAI, така: американська індустрія ШІ наразі перебуває на технологічному рубежі та займає глобальні мережеві вузли в різних ключових сферах.
Вони вважають, що контроль темпів розвитку передового ШІ — це не штучне встановлення «знаку обмеження швидкості», а забезпечення того, щоб «темпи досліджень безпечного вирівнювання випереджали покращення можливостей ШІ».
OpenAI вважає, що створення безпечних каналів зв'язку між операторами критичної інфраструктури та урядами в усьому світі, а також обмін інформацією про загрози національній безпеці та вразливості є критично важливим кроком.
Рідкісна нагода! OpenAI та Anthropic потискають руки та починають взаємну перевірку
Водночас The Information також повідомив: OpenAI та Anthropic завершують історичну угоду — обидві сторони тестуватимуть комерційні моделі одна одної!

Слід знати, що засновницька команда Anthropic тоді пішла в гніві та заснувала власну справу саме тому, що не погоджувалася з Альтманом щодо концепції «безпеки ШІ».
Але цього разу два гіганти рідко об'єднали зусилля.

Згідно з The Information, угода, що обговорюється, включає взаємне тестування моделей одна одної та суворі гарантії збереження даних. Це не піар-трюк, а скоріше, перед обличчям невідомих ризиків два гіганти не мають іншого вибору, окрім як об'єднатися.
Чому вони це роблять?
Тому що, коли можливості ШІ наближаються до межі RSI, будь-яка компанія, яка оцінює безпеку власної моделі самостійно, схожа на спортсмена, який сам себе тестує на допінг — не лише бракує довіри, але й можна пропустити фатальні приховані небезпеки через технічні сліпі зони.
Залучення рівноцінних конкурентів для «перехресного сліпого тестування» схоже на угоду про взаємну перевірку.
Практики безпеки ШІ тепер рухаються до спільноти зі спільним майбутнім.
Якщо цю угоду зрештою буде реалізовано, вона повністю переформатує стандарти безпеки всієї екосистеми ШІ.
У той час «безпека та узгодження» вже не будуть просто гаслом.
Коли RSI вже наближається, швидкість самовдосконалення ШІ вже давно залишила людство далеко позаду.
Чи справді гіганти зможуть змусити себе натиснути на гальма?
Посилання:
https://x.com/theinformation/status/2102095568335970690
https://www.theinformation.com/articles/openai-anthropic-neared-deal-stress-test-others-ai
Ця стаття походить із публічного акаунта WeChat «Xin Zhi Yuan», автор: ASI Revelation; редактори: Aeneas David