
Коротко
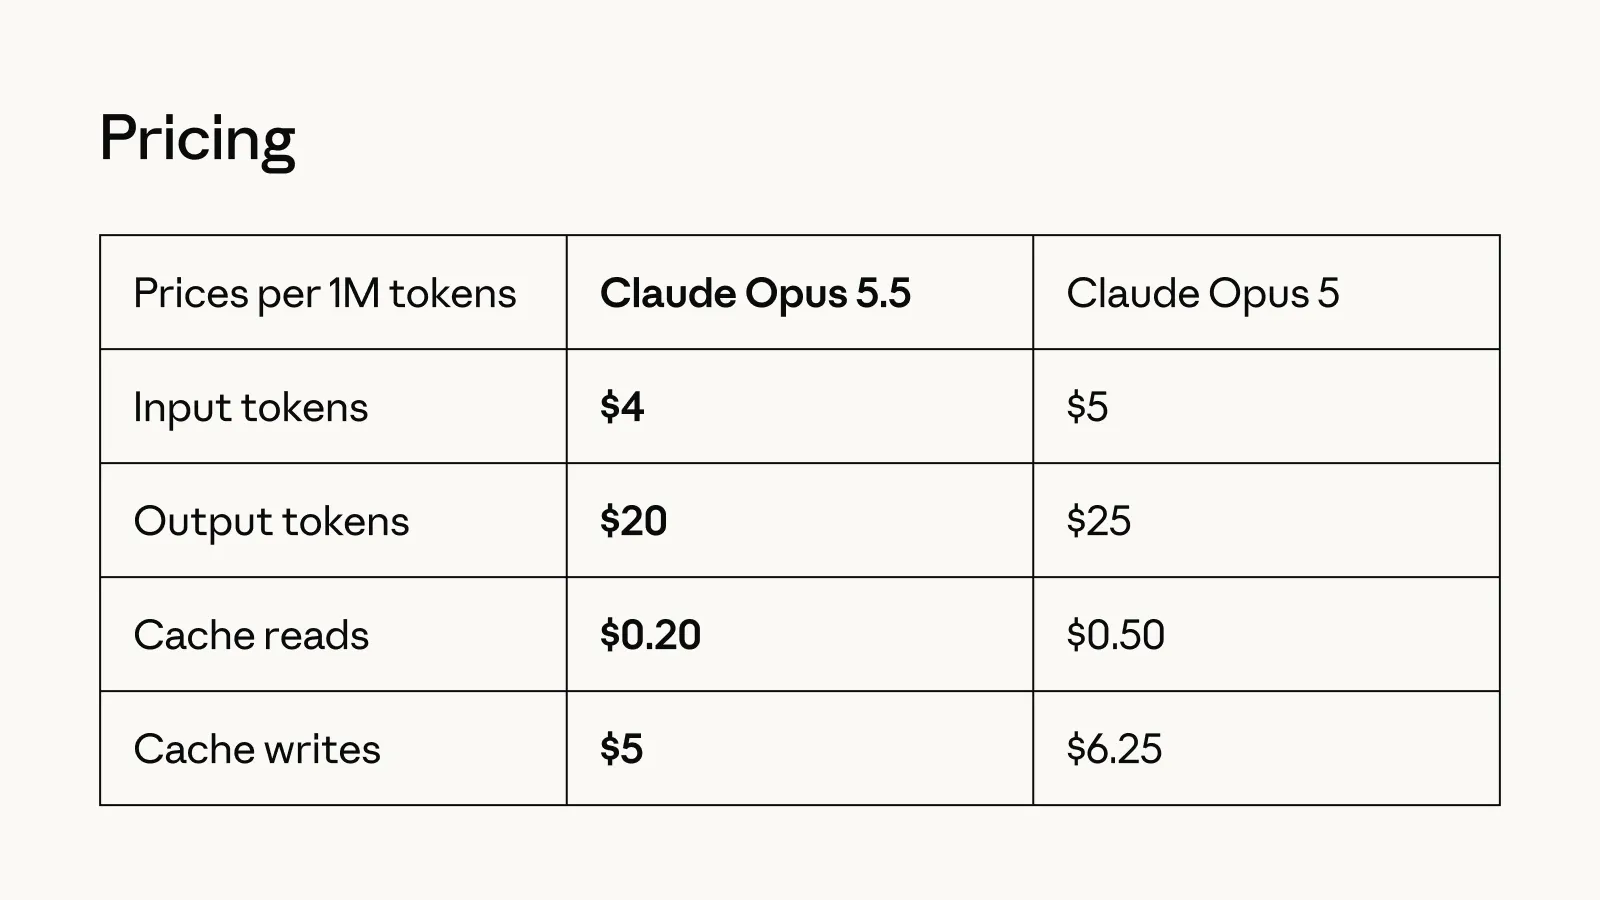
- Claude Opus 5.5 вийшла у вівторок за ціною $4 і $20 за мільйон вхідних і вихідних токенів, що на 40% дешевше за Opus 5 за стандартних налаштувань, тоді як Anthropic стверджує, що вона відповідає Fable 5.1 у більшості завдань.
- За власними даними Anthropic, Opus 5.5 випереджає Fable 5.1 і Opus 5 у тестах на програмування та інтелектуальну роботу, але GPT-6 Astra все ще перевершує її в AutomationBench і Terminal-Bench-Science 0.1.
- Це перша модель, яку Anthropic випустила відтоді, як генеральний директор Даріо Амодеї закликав галузь сповільнити зростання можливостей ШІ, і вона має ті самі засоби захисту кібербезпеки та біології, що й Fable 5.1.
Anthropic випустила Claude Opus 5.5 у вівторок — першу модель у тому, що компанія називає своєю сім'єю Claude 5.5. Anthropic стверджує, що нова модель працює на рівні Claude Fable 5.1, її найдорожчого флагмана, у більшості завдань.
Родзинка в тому, що використання цієї моделі коштує на 20% менше, ніж Opus 5, моделі, яку вона замінює, і вона на 60% дешевша за Fable 5.1, найдосконалішу пропозицію компанії.
Схоже, ця модель дуже потужна. Це найдосконаліша модель як за версією (5.5 проти 5.1 у Fable), так і за сімейством (Opus — найбільша модель, загальнодоступна, за нею йде Sonnet, а Haiku — найменша).
Anthropic визнає, що розрив між Fable та Opus вужчий, ніж свідчать його бенчмарк-оцінки, але загальнодоступність за планом і дешевша ціна за токен роблять це очевидним вибором для більшості користувачів Claude.
Opus 5 вийшов у липні, знизивши ціну та перевершивши Fable 5 за більшістю бенчмарків, а Fable 5.1 з'явився на початку вересня і змінив ситуацію на протилежну, перевершивши Opus 5 за кожним бенчмарком, який опублікувала Anthropic.
Opus 5.5 знову скорочує розрив, цього разу за ціною, а не за сирими балами. Lovable, платформа для розробників, яка прогнала Opus 5 через власні тести кодування ще в липні, заявила в коментарі, поширеному Anthropic, що попередня модель була «стабільнішою, з набагато меншою варіативністю від запуску до запуску», ніж те, що було до неї — той самий аргумент про ефективність, який Anthropic знову наводить тепер.
Opus 5.5 також є першою моделлю, яку Anthropic випустила відтоді, як генеральний директор Даріо Амодеї опублікував есе із закликом до галузі сповільнитися, аргументуючи, що зростання можливостей ШІ випереджає тестування безпеки, покликане їх стримувати. «Ми повинні сповільнити темп, з яким ми покращуємо можливості моделей ШІ», — написав Амодеї раніше цього місяця.
Anthropic вимірює більшість цього прогресу через агентне кодування — роботу, яку виконує ШІ-агент, модель, що самостійно виконує багатокрокові дії, а не просто відповідає на один запит.
На Terminal-Bench 4.0, який перевіряє, чи може агент виконати складні професійні завдання в інтерфейсі командного рядка, і оцінює результат як відсоток виконаних завдань, Opus 5.5 досяг 66,4%, випередивши Fable 5.1 з 55,8% і GPT-6 Astra з 57,9%. FrontierCode, який перевіряє, чи зміни коду агента справді були б прийняті в реальному інженерному конвеєрі, використовуючи ту саму оцінку за відсотком успішних проходжень, поставив Opus 5.5 на 54,4% проти 50,3% у Fable 5.1.
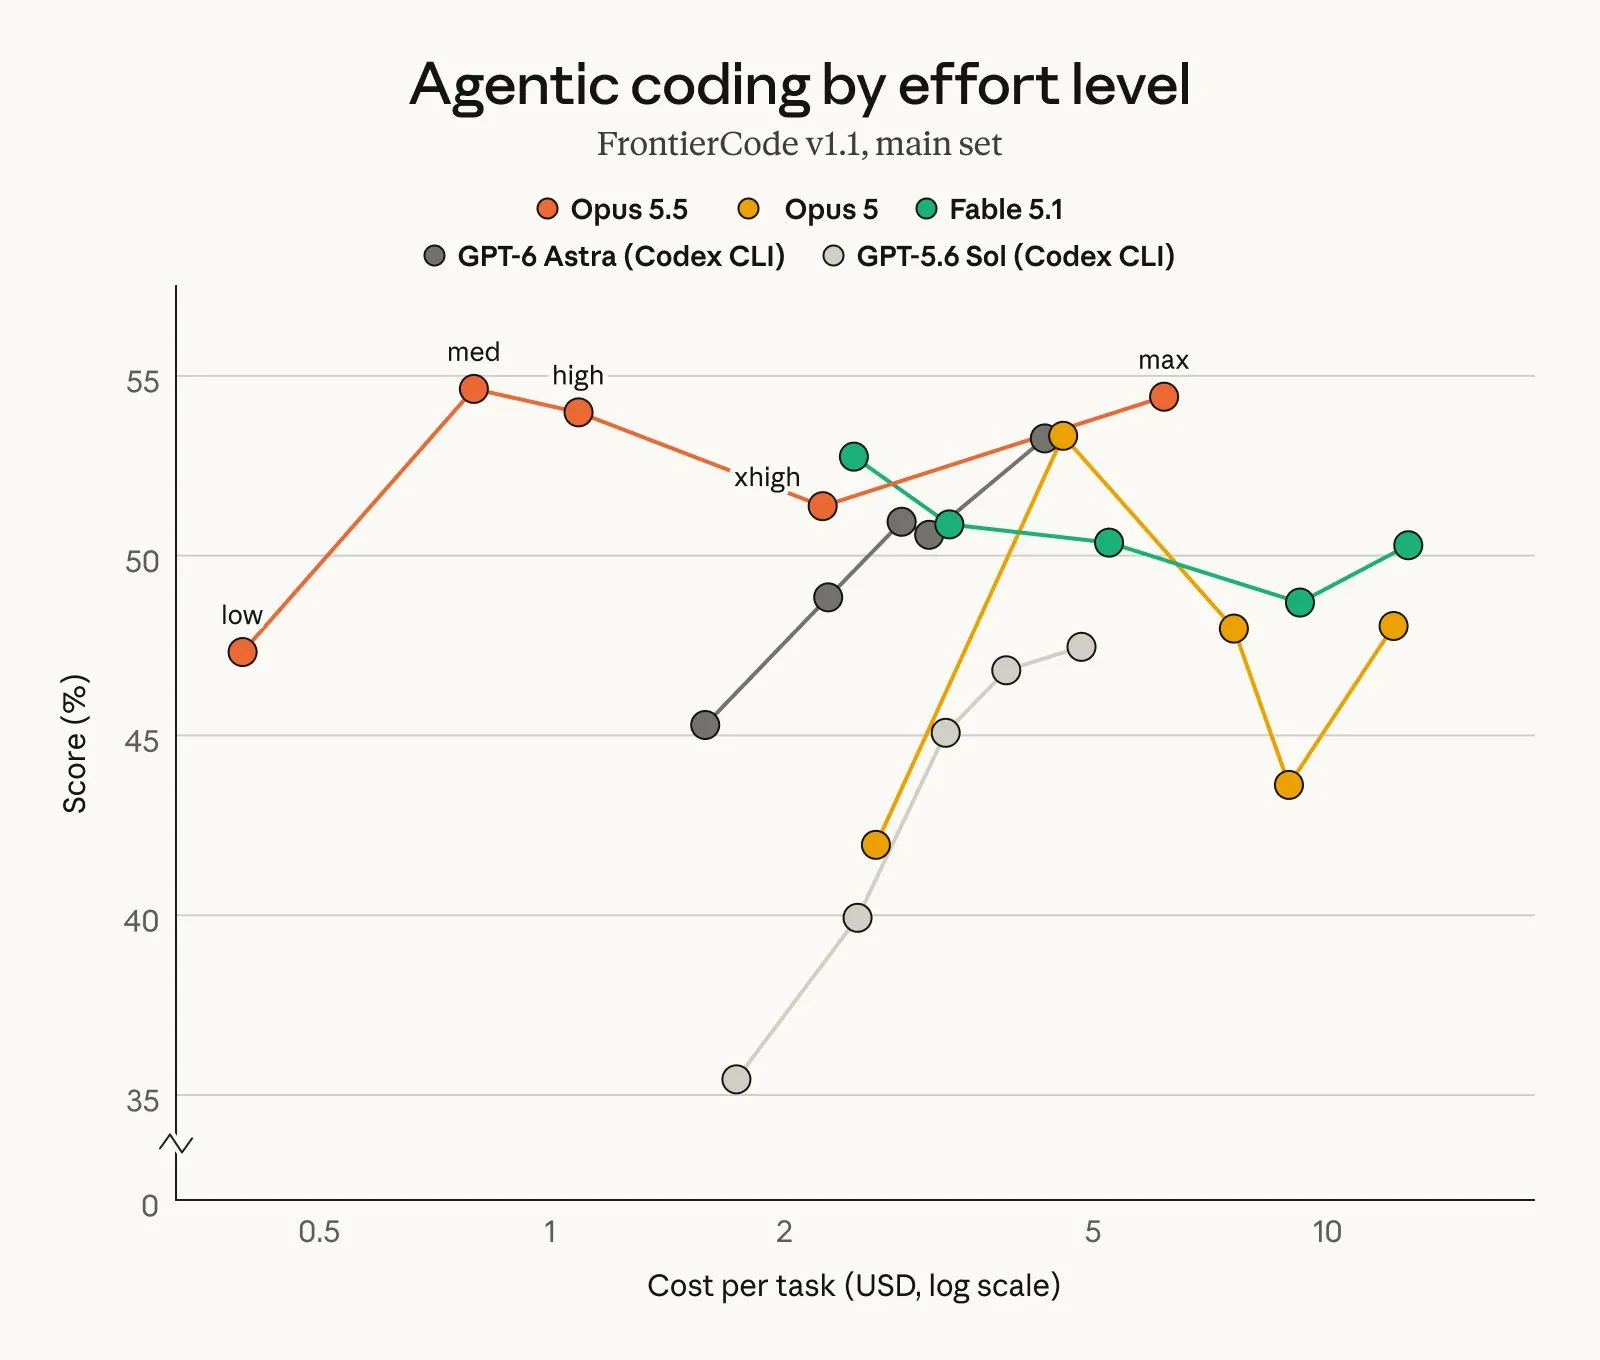
На GDPval-AA v2.1, який оцінює реальну професійну роботу в 44 професіях за допомогою Elo — тієї самої шахової системи рейтингу, що використовується для вимірювання відносної майстерності, а не плоского відсотка — Opus 5.5 набрав 1846 проти 1735 у Fable 5.1 і 1708 у Opus 5.
Однак Opus 5.5 не лідирує скрізь. На AutomationBench, створеному Zapier бенчмарку, який оцінює, чи може агент виконати повний бізнес-процес від початку до кінця без допомоги людини, 41,4% у GPT-6 Astra трохи перевищує 40,0% у Opus 5.5.
На Terminal-Bench-Science 0.1, який перевіряє агентні наукові дослідження, що виконуються в середовищі командного рядка, використовуючи той самий метод оцінки за відсотком успішних проходжень, 64,6% у Astra перевищують 58,7% у Opus 5.5 із ширшим відривом.
Більша перевага — це вартість. Вхідні токени — фрагменти тексту, які модель читає та записує, з ціною за мільйон — тепер коштують $4 для Opus 5.5 проти $5 для Opus 5, а вихідні токени знижуються до $20 з $25. Читання з кешу, що означає повторне використання контексту, який модель уже обробила, замість повторної обробки з нуля, і що спричиняє більшість витрат під час тривалих агентних сесій кодування, падає на 60% до $0.20 за мільйон токенів.
Оскільки Opus 5.5 відповідає моделям класу Mythos від Anthropic — найбільш обмеженому рівню компанії, призначеному для перевірених дослідників у сфері кібербезпеки та біології — за цими двома можливостями, він випускається з тими самими засобами захисту, що й Fable 5.1.
Більшість завдань із кібербезпеки автоматично перенаправляються до старішої Opus 4.8, на що багато розробників і користувачів раніше скаржилися..
Opus 5.5 уже доступна на платформах Anthropic, зокрема Amazon Web Services, Google Cloud і Microsoft Azure. Sonnet 5.5 і Haiku 5.5 з'являться протягом наступних тижнів, каже Anthropic, поширюючи те саме зниження цін на решту лінійки.





