Кратко
- xAI выпустила Grok 4.7 в понедельник после как минимум пяти задержек с конца июля.
- Модель заняла второе место после Claude Fable 5.1 в GDPval и AA-Briefcase, а также второе место после GPT-6 Astra в EEBench — бенчмарке по электротехнике.
- Grok 4.7 сразу доступна в приложении Grok, Cursor, Grok Build и API xAI, работая на 2,1 триллиона параметров с дополнительным обучением на инженерных данных SpaceX.
xAI Илона Маска выпустила Grok 4.7 в понедельник днём — свою лучшую на сегодняшний день модель, назвав её «заметным улучшением по сравнению с Grok 4.6 при той же цене и скорости».
Релиз состоялся после нескольких очевидных задержек. Маск отодвигал сроки как минимум пять раз с конца июля: «через четыре недели», затем «через несколько недель», затем «через 3–4 недели», затем «через 10 дней» 1 сентября, затем «нужно ещё несколько дней, чтобы дозрела» 11 сентября.
xAI утверждает, что модель тратит больше времени на решение сложных задач и чаще перепроверяет собственные ответы, чем Grok 4.6, а также имеет, по словам компании, самые надёжные на сегодняшний день защитные механизмы безопасности.
Маск продолжил в X, назвав Grok 4.7 «сильным сочетанием интеллекта, скорости и низкой стоимости». На этот раз списка ожидания нет — он уже доступен в приложении Grok, Cursor, Grok Build и API xAI.
Grok 4.7 здесь.
Это заметное улучшение по сравнению с Grok 4.6 при той же цене и скорости. pic.twitter.com/H3OTBbXyvO
— SpaceXAI (@SpaceXAI) 21 сентября 2026 г.
Grok 4.7 содержит 2,1 триллиона параметров, что на 40% больше, чем 1,5 триллиона в Grok 4.6, который сам был усовершенствованием Grok 4.5. Стоимость составляет $2 за миллион входных токенов и $6 за миллион выходных токенов. Параметры — это внутренние регуляторы, которые модель настраивает во время обучения, и чем их больше, тем, как правило, больше возможностей для изучения закономерностей, а токены — это базовый объём информации, который модель ИИ может либо воспринять, либо сгенерировать.
xAI также включила дополнительные обучающие данные, полученные от SpaceX, ракетной компании Маска: телеметрию спутников Starlink, производственные записи и журналы инженерных сбоев. Замысел в том, чтобы модель лучше рассуждала об аппаратном обеспечении и физических системах, чем что-либо, обученное исключительно на интернет-тексте.
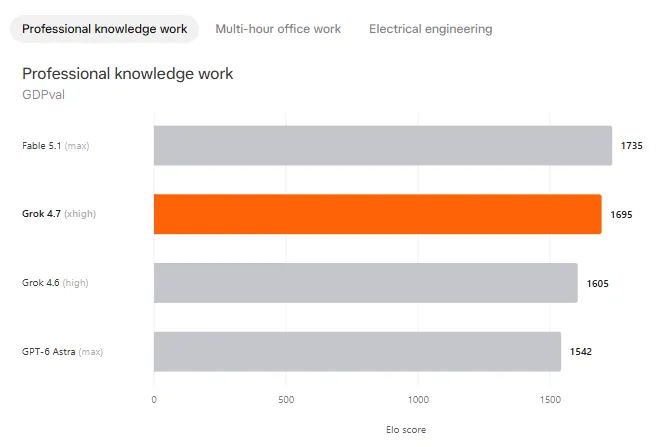
Тем не менее, оценки бенчмарков рассказывают знакомую историю. GDPval измеряет, насколько хорошо модель справляется с реальной, экономически ценной интеллектуальной работой — юридическими записками, электронными таблицами, слайдами — используя задачи, проверенные работающими профессионалами в каждой области, и оценивает её как рейтинг Эло, ту же систему ранжирования «голова к голове», которую использует шахматы.
Grok 4.7 набрал 1695 баллов в GDPval. Claude Fable 5.1 возглавил таблицу с 1735.
AA-Briefcase, созданный Artificial Analysis, тестирует многочасовую офисную работу, которая объединяет исследование, анализ и создание документов в одну длинную задачу, также оцениваемую по шкале Эло. Grok 4.7 показал 1657 против 1678 у Fable 5.1. Тот же результат, другой тест.
CursorBench 4.0, бенчмарк Cursor для реальных задач по программированию внутри его редактора, сопоставляет точность со стоимостью и количеством токенов, которые расходует каждая задача. Grok 4.7 оказывается в середине: дороже за задачу, чем преемник GPT-5.6 Sol, GPT-6 Astra, и Claude Sonnet 5, но всё ещё уступает Fable 5.1, который побеждает при любой цене на графике.
Это не новый паттерн для xAI. Grok 4.5 вышел в июле с крупнейшим обучающим кластером в отрасли и результатами на третьем месте после моделей Claude и OpenAI. До него Grok 4.20 обменял надёжность на скорость и индивидуальность. Grok 4.6 также отставал от передовой группы по автономности программирования.
Ничто из этого не делает Grok 4.7 плохим продуктом для миллионов людей, которые общаются с ним через X, отдельное приложение или панель управления своего Tesla. Это означает, что модель, которая с наибольшей вероятностью ответит на ваши вопросы или будет управлять голосовым помощником вашего автомобиля, работает на системе, которую бенчмарки самого её создателя ставят на ступень ниже вершины лестницы.
Именно из-за этого разрыва ценник значит для большинства людей больше, чем позиция в таблице лидеров. xAI последовательно устанавливала более низкую цену за токен, чем Anthropic и OpenAI, даже уступая им в сырых возможностях, делая ставку на то, что «достаточно хорошо, дёшево и повсюду» побеждает «лучшее, но дороже» для основной массы повседневного использования.
Маск уже занизил ожидания за несколько дней до запуска, написав, что Grok 4.7 должен оказаться «примерно на уровне» Claude Opus 5.0 от Anthropic, а не более новой Opus 5.1, при этом мультимодальная производительность всё ещё требует доработки.
В том же посте он набросал следующие три модели: Grok 4.8 как значительный шаг вперёд, Grok 4.9 в «классе Astra/Fable» и Grok 5 как возможного лидера переднего края. У этих обновлений пока нет даты выпуска. «Поживём — увидим», — написал он.