Em resumo
- A xAI lançou o Grok 4.7 na segunda-feira, após pelo menos cinco atrasos desde o final de julho.
- O modelo ficou em segundo lugar, atrás do Claude Fable 5.1, no GDPval e no AA-Briefcase, e em segundo lugar, atrás do GPT-6 Astra, no EEBench, um benchmark de engenharia elétrica.
- O Grok 4.7 já está disponível imediatamente no aplicativo Grok, no Cursor, no Grok Build e na API da xAI, operando com 2,1 trilhões de parâmetros e com treinamento complementar em dados de engenharia da SpaceX.
A xAI, de Elon Musk, lançou o Grok 4.7 na tarde de segunda-feira, seu melhor modelo até hoje, chamando-o de "uma melhoria notável em relação ao Grok 4.6 pelo mesmo preço e velocidade".
O lançamento ocorre após vários atrasos aparentes. Musk havia recuado o cronograma pelo menos cinco vezes desde o final de julho: "quatro semanas", depois "algumas semanas", depois "3 a 4 semanas", depois "10 dias" em 1º de setembro, e então "precisa de mais alguns dias para ficar pronto" em 11 de setembro.
A xAI afirma que o modelo passa mais tempo trabalhando em problemas difíceis e verifica suas próprias respostas com mais frequência do que o Grok 4.6 fazia, além do que a empresa chama de suas proteções de segurança mais fortes até agora.
Musk comentou no X, chamando o Grok 4.7 de "uma forte combinação de inteligência, velocidade e baixo custo". Não há lista de espera desta vez—já está disponível no app Grok, Cursor, Grok Build e na API da xAI.
O Grok 4.7 chegou.
É uma melhoria notável em relação ao Grok 4.6 pelo mesmo preço e velocidade. pic.twitter.com/H3OTBbXyvO
— SpaceXAI (@SpaceXAI) 21 de setembro de 2026
O Grok 4.7 possui 2,1 trilhões de parâmetros, um aumento de 40% em relação aos 1,5 trilhão do Grok 4.6, ele próprio um refinamento do Grok 4.5. Os custos são de US$ 2 por milhão de tokens de entrada e US$ 6 por milhão de tokens de saída. Parâmetros são os ajustes internos que um modelo calibra durante o treinamento, e mais deles geralmente significa mais capacidade de aprender padrões, enquanto tokens são a quantidade básica de informação que um modelo de IA pode registrar ou gerar.
A xAI também incorporou dados de treinamento suplementares extraídos da SpaceX, a empresa de foguetes de Musk: telemetria de satélites Starlink, registros de fabricação e logs de falhas de engenharia. A proposta é um modelo que raciocina melhor sobre hardware e sistemas físicos do que qualquer coisa treinada puramente em texto da internet.
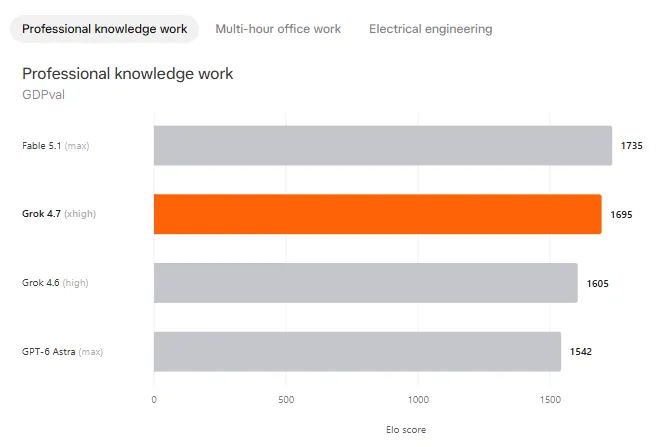
Dito isso, as pontuações dos benchmarks contam uma história familiar. O GDPval mede o desempenho de um modelo em trabalho de conhecimento real e economicamente valioso — memorandos jurídicos, planilhas, apresentações de slides — usando tarefas avaliadas por profissionais atuantes em cada área, e atribui uma pontuação como classificação Elo, o mesmo sistema de ranking frente a frente usado no xadrez.
O Grok 4.7 atingiu 1695 no GDPval. O Claude Fable 5.1 liderou o ranking com 1735.
O AA-Briefcase, criado pela Artificial Analysis, testa trabalho de escritório de várias horas que encadeia pesquisa, análise e produção de documentos em uma única tarefa longa, também pontuada na escala Elo. O Grok 4.7 registrou 1657 contra 1678 do Fable 5.1. Mesmo resultado, teste diferente.
O CursorBench 4.0, o benchmark da Cursor para tarefas reais de programação dentro de seu editor, traça a precisão em relação ao custo e à contagem de tokens que cada tarefa consome. O Grok 4.7 fica no meio: mais caro por tarefa do que o sucessor do GPT-5.6 Sol, o GPT-6 Astra, e o Claude Sonnet 5, mas ainda atrás do Fable 5.1, que vence em todos os pontos de preço do gráfico.
Esse não é um padrão novo para a xAI. O Grok 4.5 foi lançado em julho com o maior cluster de treinamento do setor e pontuações em terceiro lugar, atrás dos modelos da Claude e da OpenAI. Antes dele, o Grok 4.20 trocou confiabilidade por velocidade e personalidade. O Grok 4.6 também ficou atrás do pelotão de fronteira em autonomia de programação.
Nada disso torna o Grok 4.7 um produto ruim para os milhões de pessoas que conversam com ele pelo X, pelo aplicativo independente ou pelo painel do seu Tesla. Isso significa que o modelo com maior probabilidade de responder às suas perguntas, ou de alimentar o assistente de voz do seu carro, está rodando em um sistema que os próprios benchmarks de seu criador colocam um degrau abaixo do topo da escada.
Essa lacuna é o motivo pelo qual o preço importa mais do que a posição no ranking para a maioria das pessoas. A xAI tem consistentemente cobrado menos que a Anthropic e a OpenAI por token, mesmo ficando atrás delas em capacidade bruta, apostando que "bom o suficiente, barato e em todo lugar" supera "o melhor, mas mais caro" para a maior parte do uso cotidiano.
Musk já havia definido expectativas mais baixas dias antes do lançamento, escrevendo que o Grok 4.7 deveria ficar "mais ou menos em pé de igualdade com" o Claude Opus 5.0 da Anthropic, não com o mais novo Opus 5.1, com o desempenho multimodal ainda precisando de trabalho.
Nesse mesmo post, ele esboçou os próximos três modelos: Grok 4.8 como um avanço significativo, Grok 4.9 na "classe Astra/Fable" e Grok 5 como um possível líder de fronteira. Essas atualizações ainda não têm data de lançamento. "Veremos", ele escreveu.