W skrócie
- xAI wydało Grok 4.7 w poniedziałek, po co najmniej pięciu opóźnieniach od końca lipca.
- Model zajął drugie miejsce za Claude Fable 5.1 w GDPval i AA-Briefcase oraz drugie za GPT-6 Astra w EEBench, benchmarku inżynierii elektrycznej.
- Grok 4.7 jest dostępny natychmiast w aplikacji Grok, Cursor, Grok Build oraz xAI API, działając na 2,1 biliona parametrów z uzupełniającym treningiem na danych inżynieryjnych SpaceX.
xAI Elona Muska wydało Grok 4.7 w poniedziałkowe popołudnie, swój najlepszy model do tej pory, nazywając go „znaczącą poprawą w stosunku do Grok 4.6 przy tej samej cenie i szybkości”.
Wydanie nastąpiło po kilku wyraźnych opóźnieniach. Musk przesuwał termin co najmniej pięć razy od końca lipca: „cztery tygodnie”, potem „kilka tygodni”, potem „3 do 4 tygodni”, potem „10 dni” 1 września, a potem „potrzebuje jeszcze kilku dni, żeby dojrzeć” 11 września.
xAI twierdzi, że model spędza więcej czasu, pracując nad trudnymi problemami, i częściej niż Grok 4.6 sprawdza własne odpowiedzi, a także — jak określa to firma — ma najsilniejsze jak dotąd zabezpieczenia bezpieczeństwa.
Musk odniósł się do tego na X, nazywając Grok 4.7 „silnym połączeniem inteligencji, szybkości i niskiego kosztu”. Tym razem nie ma listy oczekujących — jest już dostępny w aplikacji Grok, Cursor, Grok Build i xAI API.
Grok 4.7 jest już dostępny.
To zauważalna poprawa w stosunku do Grok 4.6 przy tej samej cenie i szybkości. pic.twitter.com/H3OTBbXyvO
— SpaceXAI (@SpaceXAI) 21 września 2026
Grok 4.7 zawiera 2,1 biliona parametrów, o 40% więcej niż 1,5 biliona w Grok 4.6, który sam był udoskonaleniem Grok 4.5. Koszty wynoszą 2 dolary za milion tokenów wejściowych i 6 dolarów za milion tokenów wyjściowych. Parametry to wewnętrzne pokrętła, które model dostraja podczas treningu, a ich większa liczba generalnie oznacza większą zdolność do uczenia się wzorców, podczas gdy tokeny to podstawowa ilość informacji, którą model AI może zarejestrować lub wygenerować.
xAI włączyło również uzupełniające dane treningowe pozyskane od SpaceX, firmy rakietowej Muska: telemetrię satelitów Starlink, zapisy produkcyjne i dzienniki awarii inżynieryjnych. Celem jest model, który lepiej rozumuje o sprzęcie i systemach fizycznych niż cokolwiek trenowane wyłącznie na tekście z internetu.
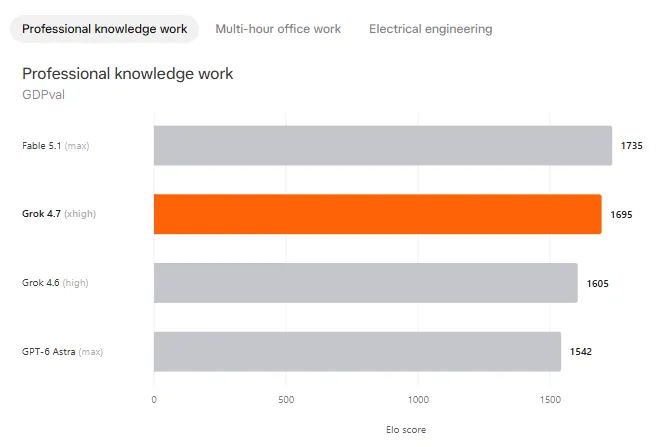
To powiedziawszy, wyniki benchmarków opowiadają znajomą historię. GDPval mierzy, jak model radzi sobie z prawdziwą, wartościową ekonomicznie pracą wiedzy—memorandami prawnymi, arkuszami kalkulacyjnymi, prezentacjami—wykorzystując zadania zweryfikowane przez pracujących profesjonalistów w każdej dziedzinie, i ocenia je jako ranking Elo, ten sam system rankingu bezpośredniego porównania, którego używa szachy.
Grok 4.7 osiągnął 1695 w GDPval. Claude Fable 5.1 zajął szczyt tabeli z 1735.
AA-Briefcase, stworzony przez Artificial Analysis, testuje wielogodzinną pracę biurową, która łączy badania, analizę i produkcję dokumentów w jedno długie zadanie, również oceniane w skali Elo. Grok 4.7 uzyskał 1657 przeciwko 1678 Fable 5.1. Ten sam wynik, inny test.
CursorBench 4.0, benchmark Cursor dla prawdziwych zadań kodowania w jego edytorze, przedstawia dokładność w zestawieniu z kosztem i liczbą tokenów, które każde zadanie zużywa. Grok 4.7 plasuje się w środku: droższy za zadanie niż następca GPT-5.6 Sol, GPT-6 Astra, i Claude Sonnet 5, ale wciąż poniżej Fable 5.1, który wygrywa przy każdym punkcie cenowym na wykresie.
To nie jest nowy wzorzec dla xAI. Grok 4.5 zadebiutował w lipcu z największym klastrem treningowym w branży i wynikami na trzecim miejscu za modelami Claude i OpenAI. Przed nim Grok 4.20 wymienił niezawodność na szybkość i osobowość. Grok 4.6 również pozostawał w tyle za czołówką w zakresie autonomii kodowania.
Nic z tego nie czyni Grok 4.7 złym produktem dla milionów ludzi, którzy rozmawiają z nim przez X, samodzielną aplikację lub deskę rozdzielczą swojego Tesli. Oznacza to, że model najprawdopodobniej odpowiadający na twoje pytania lub zasilający asystenta głosowego twojego samochodu działa w systemie, który według benchmarków samego producenta plasuje się o szczebel poniżej szczytu drabiny.
Ta luka jest powodem, dla którego cena ma większe znaczenie niż pozycja w rankingu dla większości ludzi. xAI konsekwentnie oferuje niższe ceny za token niż Anthropic i OpenAI, nawet gdy ustępuje im pod względem surowych możliwości, zakładając, że „wystarczająco dobry, tani i wszędzie dostępny” wygrywa z „najlepszy, ale droższy” w większości codziennych zastosowań.
Musk już kilka dni przed premierą obniżył oczekiwania, pisząc, że Grok 4.7 powinien uplasować się „mniej więcej na poziomie” Claude Opus 5.0 od Anthropic, a nie nowszego Opus 5.1, a wydajność multimodalna wciąż wymaga pracy.
W tym samym poście naszkicował trzy kolejne modele: Grok 4.8 jako znaczący krok naprzód, Grok 4.9 w „klasie Astra/Fable” i Grok 5 jako potencjalnego lidera na froncie. Te ulepszenia nie mają jeszcze daty premiery. „Zobaczymy”, napisał.