En bref
- xAI a publié Grok 4.7 lundi, après au moins cinq retards depuis fin juillet.
- Le modèle s'est classé deuxième derrière Claude Fable 5.1 sur GDPval et AA-Briefcase, et deuxième derrière GPT-6 Astra sur EEBench, un benchmark d'ingénierie électrique.
- Grok 4.7 est disponible immédiatement dans l'application Grok, Cursor, Grok Build et l'API xAI, fonctionnant sur 2,1 billions de paramètres avec un entraînement complémentaire sur les données d'ingénierie de SpaceX.
xAI d'Elon Musk a publié Grok 4.7 lundi après-midi, son meilleur modèle à ce jour, le qualifiant d'« amélioration notable par rapport à Grok 4.6 au même prix et à la même vitesse ».
Cette publication intervient après plusieurs retards apparents. Musk avait repoussé le calendrier au moins cinq fois depuis fin juillet : « dans quatre semaines », puis « dans quelques semaines », puis « dans 3 à 4 semaines », puis « dans 10 jours » le 1er septembre, puis « a besoin de quelques jours de plus pour mijoter » le 11 septembre.
xAI affirme que le modèle passe plus de temps à travailler sur des problèmes difficiles et vérifie ses propres réponses plus souvent que ne le faisait Grok 4.6, aux côtés de ce que l'entreprise appelle ses garde-fous de sécurité les plus solides à ce jour.
Musk a donné suite sur X, qualifiant Grok 4.7 de « forte combinaison d'intelligence, de rapidité et de faible coût ». Il n'y a pas de liste d'attente cette fois—il est disponible dès maintenant dans l'application Grok, Cursor, Grok Build et l'API xAI.
Grok 4.7 est là.
C'est une amélioration notable par rapport à Grok 4.6 au même prix et à la même vitesse. pic.twitter.com/H3OTBbXyvO
— SpaceXAI (@SpaceXAI) 21 septembre 2026
Grok 4.7 contient 2,1 billions de paramètres, soit une augmentation de 40 % par rapport aux 1,5 billion de Grok 4.6, lui-même un raffinement de Grok 4.5. Les coûts sont de 2 $ par million de jetons d'entrée et de 6 $ par million de jetons de sortie. Les paramètres sont les réglages internes qu'un modèle ajuste pendant l'entraînement, et plus il y en a, plus la capacité d'apprendre des motifs est généralement grande, tandis que les jetons sont la quantité de base d'informations qu'un modèle d'IA peut soit enregistrer, soit générer.
xAI a également intégré des données d'entraînement supplémentaires provenant de SpaceX, la société de fusées de Musk : la télémétrie des satellites Starlink, les dossiers de fabrication et les journaux de défaillance d'ingénierie. Le pari est un modèle qui raisonne mieux sur le matériel et les systèmes physiques que tout ce qui est entraîné purement sur du texte internet.
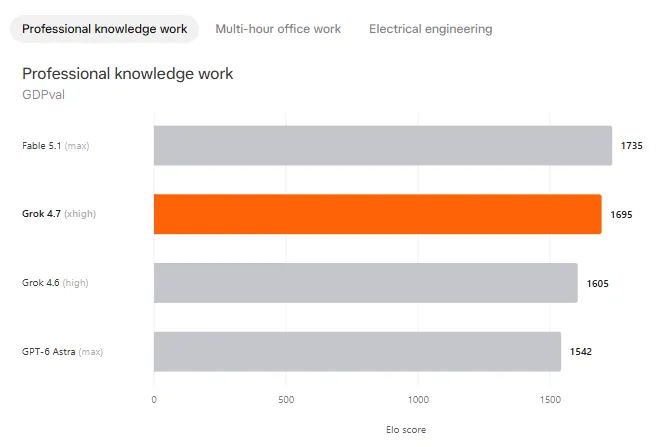
Cela dit, les scores des benchmarks racontent une histoire familière. GDPval mesure la performance d'un modèle sur un travail de connaissance réel et économiquement précieux—notes juridiques, feuilles de calcul, diaporamas—à l'aide de tâches vérifiées par des professionnels en exercice dans chaque domaine, et l'évalue comme un classement Elo, le même système de classement en face-à-face que celui utilisé aux échecs.
Grok 4.7 a atteint 1695 sur GDPval. Claude Fable 5.1 a dominé le classement avec 1735.
AA-Briefcase, conçu par Artificial Analysis, teste un travail de bureau de plusieurs heures qui enchaîne recherche, analyse et production de documents en une seule longue tâche, également notée sur l'échelle Elo. Grok 4.7 a obtenu 1657 contre 1678 pour Fable 5.1. Même résultat, test différent.
CursorBench 4.0, le benchmark de Cursor pour les tâches de codage réelles dans son éditeur, trace la précision en fonction du coût et du nombre de tokens que chaque tâche consomme. Grok 4.7 se situe au milieu : plus cher par tâche que le successeur de GPT-5.6 Sol, GPT-6 Astra, et Claude Sonnet 5, mais encore en dessous de Fable 5.1, qui gagne à chaque niveau de prix sur le graphique.
Ce n'est pas un nouveau schéma pour xAI. Grok 4.5 a été lancé en juillet avec le plus grand cluster d'entraînement du secteur et des scores à la troisième place derrière les modèles de Claude et d'OpenAI. Avant lui, Grok 4.20 échangeait la fiabilité contre la vitesse et la personnalité. Grok 4.6 était également à la traîne du peloton de tête en matière d'autonomie de codage.
Rien de tout cela ne fait de Grok 4.7 un mauvais produit pour les millions de personnes qui lui parlent via X, l'application autonome ou le tableau de bord de leur Tesla. Cela signifie que le modèle le plus susceptible de répondre à vos questions, ou d'alimenter l'assistant vocal de votre voiture, fonctionne sur un système que les benchmarks de son propre créateur placent un échelon en dessous du sommet de l'échelle.
Cet écart explique pourquoi le prix compte plus que la position au classement pour la plupart des gens. xAI a constamment sous-coté Anthropic et OpenAI sur le coût par token, même s'il est à la traîne sur la capacité brute, en pariant que « suffisamment bon, bon marché et partout » l'emporte sur « le meilleur, mais plus cher » pour la majorité des usages quotidiens.
Musk avait déjà revu les attentes à la baisse quelques jours avant le lancement, écrivant que Grok 4.7 devrait se situer « à peu près au niveau » de Claude Opus 5.0 d'Anthropic, et non du plus récent Opus 5.1, les performances multimodales nécessitant encore du travail.
Dans ce même message, il a esquissé les trois modèles suivants : Grok 4.8 comme une avancée significative, Grok 4.9 dans la « classe Astra/Fable », et Grok 5 comme un possible leader de frontière. Ces améliorations n'ont pas encore de date de sortie. « Nous verrons », a-t-il écrit.