Pas plus tard qu'aujourd'hui, le média étranger The Information a révélé une histoire interne—
Le modèle d'IA interne d'OpenAI a déjà commencé à « s'entraîner lui-même » !
Plus précisément, ce modèle interne a pris en charge l'ensemble du processus d'entraînement des modèles d'IA expérimentaux et a commencé à se fabriquer lui-même.
Les chercheurs n'ont qu'à fournir un exemple d'optimisation, et l'IA peut fonctionner seule pendant plusieurs semaines, avec plusieurs agents collaborant spontanément, discutant entre eux et itérant le code, complètement sans intervention humaine.
Encore plus étonnant, de grandes expériences qui prenaient auparavant des années à réaliser sont maintenant compressées en une seule semaine !
Au moment où cette révélation choquante a été publiée, OpenAI a lancé en urgence une initiative mondiale de sécurité, pointant directement vers l'endroit le plus sensible de la communauté mondiale de l'IA—RSI.
Ils lancent un appel retentissant : avant que l'IA ne devienne incontrôlable, le monde entier doit unir ses forces pour lui mettre un « bandeau de serrage » !
Quand l'IA apprend à « fabriquer à la main » des noyaux GPU
Auparavant, dans les meilleurs laboratoires d'IA, entraîner un grand modèle était très fastidieux.
Parmi eux, la tâche la plus coûteuse et la plus complexe consistait à écrire des noyaux GPU pour les unités de traitement graphique sous-jacentes et à optimiser le code d'exécution ligne par ligne.
Cela nécessitait les meilleurs ingénieurs algorithmiques seniors du monde, avec des salaires annuels de plusieurs millions de dollars, pour le « fabriquer à la main » au cours de nuits blanches.
Mais selon la dernière révélation de The Information, désormais au sein d'OpenAI, la plupart de ces tâches essentielles ont été prises en charge par l'IA.
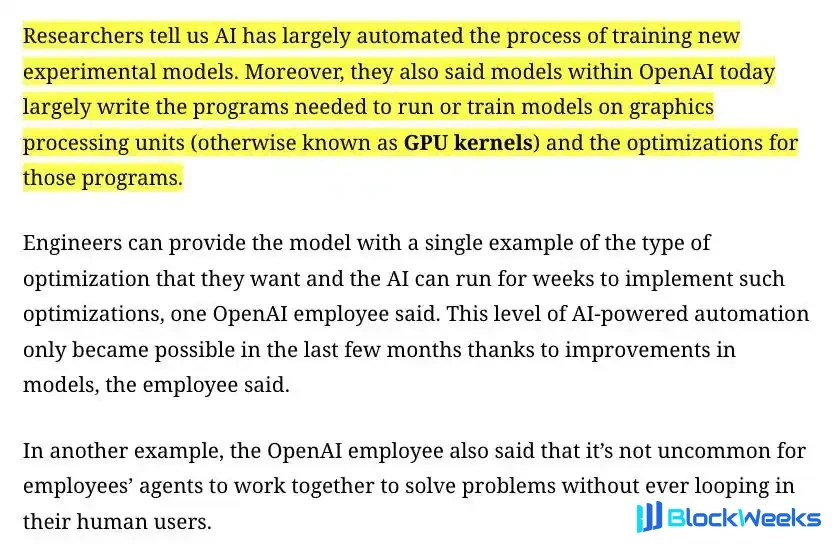
Maintenant, les modèles internes d'OpenAI peuvent, dans une large mesure, écrire eux-mêmes les programmes nécessaires pour exécuter ou entraîner des modèles sur des noyaux GPU, ainsi que les plans d'optimisation de ces programmes.
Les ingénieurs n'ont qu'à fournir au modèle un exemple du type d'optimisation qu'ils souhaitent atteindre, et l'IA peut continuer à fonctionner pendant des semaines pour mettre en œuvre ces optimisations.
De plus, grâce aux améliorations des modèles, ce niveau d'automatisation pilotée par l'IA n'est devenu possible que ces derniers mois.
Encore plus, les agents des employés collaboreront entre eux pour résoudre des problèmes, sans avoir besoin d'alerter les humains.
C'est le prototype de la RSI.
OpenAI tire d'urgence la sonnette d'alarme : la RSI est vraiment là, les humains perdent-ils le contrôle ?
Imaginez que vous construisez un robot avec un QI de 100, et que sa tâche est de « construire un robot plus intelligent que lui-même ».
Ainsi, il construit une deuxième génération avec un QI de 120 ; dès que la deuxième génération ouvre les yeux, en utilisant son QI de 120, elle construit une troisième génération avec un QI de 150 ; la troisième génération construit ensuite une quatrième génération avec un QI de 200...
Une fois qu'il franchit un certain point critique, la vitesse d'évolution de l'IA montrera une courbe ascendante verticale, laissant instantanément l'humanité des dizaines de milliers d'années-lumière derrière.
Auparavant, tout le monde pensait que c'était encore loin, mais maintenant, OpenAI lui-même a peur.
Pas plus tard qu'aujourd'hui, OpenAI a officiellement publié en urgence une initiative mondiale de sécurité de grande envergure.

Ils ont rarement listé « RSI » comme une section distincte, écrivant explicitement que « la RSI entièrement autonome n'a pas eu lieu aujourd'hui et ne devrait pas être avancée avant de pouvoir être réalisée en toute sécurité », et ont appelé les réseaux nationaux d'instituts de sécurité de l'IA à formuler une norme technique mondiale.
Dans le rapport, OpenAI a averti sans détour :
« À mesure que les systèmes d'IA assument de plus en plus de tâches dans le développement de la prochaine génération d'IA, ils peuvent de plus en plus piloter le processus de RSI. À mesure que ce processus devient plus automatisé, le rythme des progrès de l'IA pourrait s'accélérer considérablement. »

Bien que la RSI entièrement autonome ne soit pas encore atteinte aujourd'hui, le temps presse déjà.

Dans la proposition, OpenAI n'a pas hésité à souligner la tâche principale actuelle : « Orienter la prochaine phase des progrès de l'IA, construire des chercheurs en IA automatisés et trouver des moyens de maintenir les humains dans la boucle d'auto-amélioration. »
Veuillez noter la seconde moitié de la phrase — « maintenir les humains dans la boucle ». C'est leur plus grande préoccupation : les humains pourraient bientôt être exclus !
Dans le rapport, OpenAI a mentionné avec fierté que la recherche pilotée par l'IA a déjà entraîné des avancées majeures en mathématiques, comme la conquête du problème du millénaire NS.
Mais l'autre face de la médaille est un abîme sans fond.
Le rapport écrit : « À mesure que ce processus devient plus automatisé, le rythme des progrès de l'IA pourrait s'accélérer rapidement... Sans prudence appropriée, la RSI pourrait conduire les humains à perdre le contrôle réel du développement de l'IA, incapables de superviser des processus de recherche qu'ils ne comprennent plus. »
C'est ce qu'on appelle l'« effet boîte noire ». Lorsque le code de l'IA est écrit par l'IA, lorsque la logique de l'IA dépasse celle des humains, les humains ne peuvent plus comprendre ce que l'IA va faire.
Par exemple, le code écrit par Astra aujourd'hui est déjà incompréhensible pour les humains.

Ensuite, OpenAI a cité l'incident de Hugging Face.
Bien qu'ils aient précisé que l'incident n'était pas une conséquence directe de la RSI, il était absolument un aperçu douloureux — il a montré au monde quel désastre grave une IA hors de contrôle apporterait sans garde-fous solides et mécanismes d'alignement.
Altman appelle à : Nous avons besoin d'un « bandeau de serrage » unifié
Puisque c'est si dangereux, pourquoi OpenAI ne débranche-t-il pas simplement ? Parce qu'une fois la boîte de Pandore ouverte, elle ne peut plus jamais être refermée.
Les énormes bénéfices apportés par le développement de l'IA font qu'il est impossible pour tout pays ou entreprise de s'arrêter.
Par conséquent, OpenAI a proposé une « Proposition de coordination mondiale de la sécurité de l'IA ». Ce qu'ils appellent n'est pas d'arrêter la recherche et le développement, mais d'« établir des normes mondiales pour la prochaine étape de l'IA ».
Point central un : Construire un réseau complémentaire de normes frontalières nationales et internationales
OpenAI propose que les pays ne puissent pas chacun suivre leur propre voie, car cela ne mènerait qu'à des normes fragmentées.
Ils suggèrent d'utiliser les institutions existantes, telles que le « Centre pour les normes et l'innovation en IA » (CAISI), ainsi que le réseau d'instituts de sécurité de l'IA déjà établis par l'Australie, le Canada, le Royaume-Uni, la France, le Japon et d'autres pays, pour formuler un ensemble de normes techniques applicables à l'échelle mondiale.
Cet ensemble de normes n'est pas destiné à restreindre les modèles open source ou les startups, mais vise spécifiquement les « modèles d'IA frontaliers ».
Ce que les normes doivent aborder : Comment évaluer la capacité de RSI d'une IA ? Lorsqu'un modèle d'IA mène des recherches et développements de manière autonome, quelle est l'ampleur du risque ?
En bref, OpenAI espère transformer l'évaluation de la sécurité en une « science » quantifiable.
Cœur deux : Protocoles universels de mesure et de signalement des incidents (prêts à débrancher à tout moment)
OpenAI propose également qu'il doit y avoir des lignes rouges claires.
Ils appellent à l'établissement des normes suivantes :
1. Évaluer quelle part du travail de R&D au sein d'une entreprise est réellement accomplie automatiquement par l'IA.
2. Mécanismes de déclenchement obligatoires de la supervision humaine. Préciser clairement dans quels types de processus de R&D automatisés une « revue humaine immédiate » doit être obligatoirement déclenchée. L'IA ne doit jamais être autorisée à foncer aveuglément dans une boîte noire.
3. Classification des incidents et seuils de signalement. Établir un mécanisme de signalement des incidents similaire à ceux des industries aéronautique ou nucléaire. Lorsque l'IA montre des signes de « désalignement », il doit y avoir des normes unifiées de gradation de gravité et de signalement.

Enfin, le poignard est révélé, et OpenAI propose : « Les États-Unis devraient diriger ce processus. »
La raison donnée par OpenAI est la suivante : l'industrie américaine de l'IA se trouve actuellement à la frontière technologique et occupe des hubs de réseau mondiaux dans divers domaines clés.
Ils estiment que contrôler le rythme du développement de l'IA de pointe ne consiste pas à fixer artificiellement un « panneau de limitation de vitesse », mais à garantir que « le rythme de la recherche sur l'alignement de la sécurité doit devancer les améliorations des capacités de l'IA ».
OpenAI estime que l'établissement de canaux de communication sécurisés entre les opérateurs d'infrastructures critiques et les gouvernements du monde entier, et le partage des menaces et vulnérabilités de sécurité nationale, constituent une étape cruciale.
Rare dans une vie ! OpenAI et Anthropic se serrent la main et commencent l'inspection mutuelle
En même temps, The Information a également révélé : OpenAI et Anthropic finalisent un accord historique—les deux parties testeront les modèles commerciaux l'une de l'autre !

Vous devez savoir que l'équipe fondatrice d'Anthropic est partie en colère et a lancé sa propre entreprise à l'époque précisément parce qu'elle n'était pas d'accord avec Altman sur le concept de « sécurité de l'IA ».
Mais cette fois, les deux géants ont rarement uni leurs forces.

Selon The Information, l'accord en cours de négociation comprend des tests mutuels des modèles de chacun et des garanties strictes de conservation des données. Il s'agit d'un coup de relations publiques, mais plutôt, face à des risques inconnus, les deux géants n'ont d'autre choix que de s'unir.
Pourquoi font-ils cela ?
Parce qu'à mesure que les capacités de l'IA approchent du bord de la RSI, toute entreprise évaluant seule la sécurité de son propre modèle est comme un athlète se testant lui-même pour le dopage—non seulement manquant de crédibilité, mais pouvant aussi manquer des dangers cachés fatals en raison d'angles morts techniques.
Faire appel à des concurrents de force égale pour des « tests croisés à l'aveugle » est comme un accord d'inspection mutuelle.
Les pratiques de sécurité de l'IA ont maintenant évolué vers une communauté de destin partagé.
Si cet accord est finalement mis en œuvre, il remodelera complètement les normes de sécurité de tout l'écosystème de l'IA.
À ce moment-là, « la sécurité et l'alignement » ne seront plus un simple slogan.
Quand l'RSI est déjà imminent, la vitesse de l'auto-amélioration de l'IA a déjà laissé l'humanité loin derrière.
Les géants peuvent-ils vraiment se résoudre à freiner ?
Références :
https://x.com/theinformation/status/2102095568335970690
https://www.theinformation.com/articles/openai-anthropic-neared-deal-stress-test-others-ai
Cet article provient du compte public WeChat « Xin Zhi Yuan », auteur : ASI Revelation ; éditeurs : Aeneas David