En resumen
- xAI lanzó Grok 4.7 el lunes, tras al menos cinco retrasos desde finales de julio.
- El modelo obtuvo el segundo lugar detrás de Claude Fable 5.1 en GDPval y AA-Briefcase, y el segundo lugar detrás de GPT-6 Astra en EEBench, un benchmark de ingeniería eléctrica.
- Grok 4.7 está disponible de inmediato en la aplicación Grok, Cursor, Grok Build y la API de xAI, funcionando con 2,1 billones de parámetros con entrenamiento complementario en datos de ingeniería de SpaceX.
xAI, de Elon Musk, lanzó Grok 4.7 el lunes por la tarde, su mejor modelo hasta la fecha, calificándolo como "una mejora notable respecto a Grok 4.6 al mismo precio y velocidad".
El lanzamiento llega tras varios retrasos aparentes. Musk había retrasado la fecha al menos cinco veces desde finales de julio: "en cuatro semanas", luego "en unas semanas", después "en 3 o 4 semanas", luego "en 10 días" el 1 de septiembre, y después "necesita unos días más para cocinarse" el 11 de septiembre.
xAI afirma que el modelo dedica más tiempo a resolver problemas difíciles y verifica sus propias respuestas con más frecuencia que Grok 4.6, junto con lo que la compañía describe como sus barreras de seguridad más sólidas hasta la fecha.
Musk siguió en X, calificando a Grok 4.7 como "una fuerte combinación de inteligencia, velocidad y bajo costo". Esta vez no hay lista de espera: ya está disponible en la aplicación Grok, Cursor, Grok Build y la API de xAI.
Grok 4.7 ya está aquí.
Es una mejora notable respecto a Grok 4.6 al mismo precio y velocidad. pic.twitter.com/H3OTBbXyvO
— SpaceXAI (@SpaceXAI) 21 de septiembre de 2026
Grok 4.7 cuenta con 2,1 billones de parámetros, un 40 % más que los 1,5 billones de Grok 4.6, que a su vez era un refinamiento de Grok 4.5. Los costos son de $2 por millón de tokens de entrada y $6 por millón de tokens de salida. Los parámetros son los ajustes internos que un modelo calibra durante el entrenamiento, y más de ellos generalmente significa más capacidad para aprender patrones, mientras que los tokens son la cantidad básica de información que un modelo de IA puede registrar o generar.
xAI también incorporó datos de entrenamiento suplementarios extraídos de SpaceX, la empresa de cohetes de Musk: telemetría de satélites Starlink, registros de fabricación y registros de fallos de ingeniería. La propuesta es un modelo que razona mejor sobre hardware y sistemas físicos que cualquier cosa entrenada puramente con texto de internet.
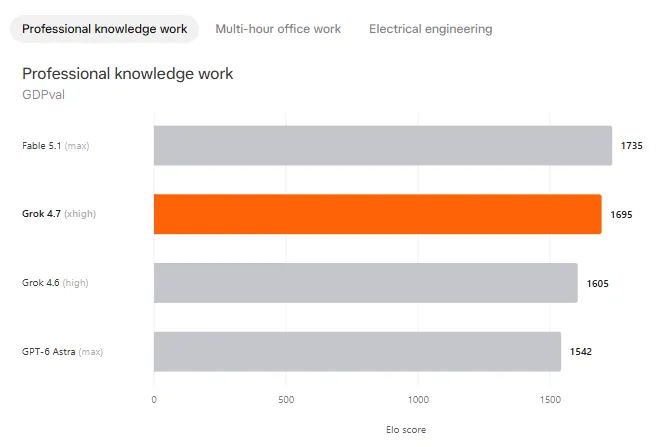
Dicho esto, las puntuaciones de los benchmarks cuentan una historia conocida. GDPval mide cómo se desempeña un modelo en trabajo de conocimiento real y económicamente valioso —memorandos legales, hojas de cálculo, presentaciones de diapositivas— usando tareas revisadas por profesionales en activo de cada campo, y lo puntúa como una calificación Elo, el mismo sistema de clasificación cara a cara que usa el ajedrez.
Grok 4.7 alcanzó 1695 en GDPval. Claude Fable 5.1 encabezó la tabla con 1735.
AA-Briefcase, creado por Artificial Analysis, evalúa trabajo de oficina de varias horas que encadena investigación, análisis y producción de documentos en una sola tarea larga, también puntuada en la escala Elo. Grok 4.7 registró 1657 frente a los 1678 de Fable 5.1. Mismo resultado, prueba diferente.
CursorBench 4.0, el benchmark de Cursor para tareas reales de programación dentro de su editor, representa la precisión frente al costo y la cantidad de tokens que consume cada tarea. Grok 4.7 queda en el medio: más caro por tarea que el sucesor de GPT-5.6 Sol, GPT-6 Astra, y que Claude Sonnet 5, pero todavía por debajo de Fable 5.1, que gana en cada punto de precio del gráfico.
Este no es un patrón nuevo para xAI. Grok 4.5 se lanzó en julio con el mayor clúster de entrenamiento de la industria y puntuaciones de tercer lugar por detrás de los modelos de Claude y OpenAI. Antes que él, Grok 4.20 cambió fiabilidad por velocidad y personalidad. Grok 4.6 también quedó por detrás del pelotón de vanguardia en autonomía de programación.
Nada de esto convierte a Grok 4.7 en un mal producto para los millones de personas que hablan con él a través de X, la aplicación independiente o el panel de su Tesla. Significa que el modelo con más probabilidades de responder a tus preguntas, o de impulsar el asistente de voz de tu coche, funciona sobre un sistema que, según los propios benchmarks de su creador, se sitúa un peldaño por debajo de la cima de la escalera.
Esa brecha es la razón por la que el precio importa más que la posición en la tabla de clasificación para la mayoría de la gente. xAI ha rebajado sistemáticamente los precios de Anthropic y OpenAI en coste por token, incluso mientras va por detrás de ellos en capacidad bruta, apostando a que "suficientemente bueno, barato y en todas partes" supera a "el mejor, pero más caro" para la mayor parte del uso cotidiano.
Musk ya había fijado expectativas más bajas días antes del lanzamiento, escribiendo que Grok 4.7 debería situarse "más o menos a la par" del Claude Opus 5.0 de Anthropic, no del más nuevo Opus 5.1, con un rendimiento multimodal que aún necesita trabajo.
En esa misma publicación esbozó los tres modelos siguientes: Grok 4.8 como un avance significativo, Grok 4.9 en la "clase Astra/Fable", y Grok 5 como un posible líder de frontera. Esas mejoras aún no tienen fecha de lanzamiento. "Ya veremos", escribió.