In Kürze
- xAI veröffentlichte Grok 4.7 am Montag, nach mindestens fünf Verzögerungen seit Ende Juli.
- Das Modell erreichte den zweiten Platz hinter Claude Fable 5.1 bei GDPval und AA-Briefcase sowie den zweiten Platz hinter GPT-6 Astra bei EEBench, einem Benchmark für Elektrotechnik.
- Grok 4.7 ist sofort in der Grok-App, in Cursor, in Grok Build und in der xAI-API verfügbar, läuft mit 2,1 Billionen Parametern und wurde zusätzlich mit SpaceX-Engineering-Daten trainiert.
Elon Musks xAI veröffentlichte Grok 4.7 am Montagnachmittag, sein bisher bestes Modell, und bezeichnete es als „eine bemerkenswerte Verbesserung gegenüber Grok 4.6 bei gleichem Preis und gleicher Geschwindigkeit“.
Die Veröffentlichung erfolgt nach mehreren offensichtlichen Verzögerungen. Musk hatte den Zeitplan seit Ende Juli mindestens fünf Mal nach hinten verschoben: „in vier Wochen“, dann „in ein paar Wochen“, dann „in 3 bis 4 Wochen“, dann „in 10 Tagen“ am 1. September, dann „braucht noch ein paar Tage zum Reifen“ am 11. September.
xAI sagt, dass das Modell länger an schwierigen Problemen arbeitet und seine eigenen Antworten häufiger überprüft als Grok 4.6, zusammen mit dem, was das Unternehmen seine bisher stärksten Sicherheitsleitplanken nennt.
Musk folgte auf X nach und nannte Grok 4.7 „eine starke Kombination aus Intelligenz, Geschwindigkeit & niedrigen Kosten“. Diesmal gibt es keine Warteliste – es ist jetzt live in der Grok-App, Cursor, Grok Build und der xAI-API.
Grok 4.7 ist da.
Es ist eine bemerkenswerte Verbesserung gegenüber Grok 4.6 bei gleichem Preis und gleicher Geschwindigkeit. pic.twitter.com/H3OTBbXyvO
— SpaceXAI (@SpaceXAI) 21. September 2026
Grok 4.7 umfasst 2,1 Billionen Parameter, 40 % mehr als die 1,5 Billionen in Grok 4.6, das selbst eine Verfeinerung von Grok 4.5 war. Die Kosten betragen 2 $ pro Million Eingabe-Token und 6 $ pro Million Ausgabe-Token. Parameter sind die internen Stellschrauben, die ein Modell während des Trainings justiert, und mehr davon bedeuten im Allgemeinen mehr Kapazität, Muster zu lernen, während Token die grundlegende Informationsmenge sind, die ein KI-Modell entweder registrieren oder generieren kann.
xAI hat außerdem ergänzende Trainingsdaten eingebunden, die von SpaceX stammen, Musks Raketenunternehmen: Starlink-Satellitentelemetrie, Fertigungsaufzeichnungen und Protokolle über technische Ausfälle. Das Versprechen ist ein Modell, das besser über Hardware und physische Systeme reasoning kann als alles, was ausschließlich auf Internettext trainiert wurde.
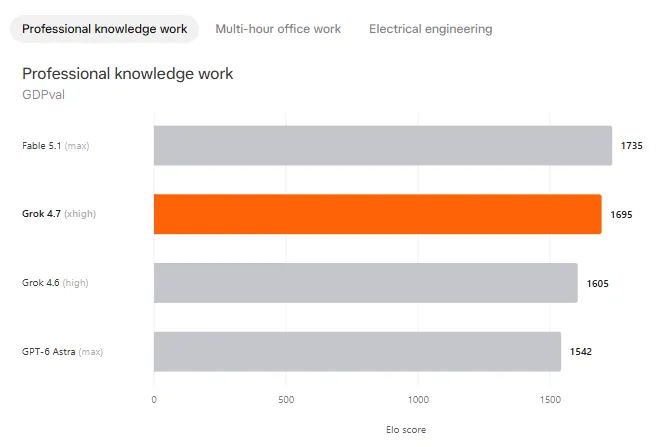
Allerdings erzählen Benchmark-Ergebnisse eine bekannte Geschichte. GDPval misst, wie ein Modell bei realer, wirtschaftlich wertvoller Wissensarbeit abschneidet – juristische Memoranden, Tabellenkalkulationen, Präsentationsfolien –, wobei die Aufgaben von berufstätigen Fachleuten auf dem jeweiligen Gebiet geprüft werden, und bewertet sie mit einer Elo-Bewertung, demselben direkten Ranking-System, das auch beim Schach verwendet wird.
Grok 4.7 erreichte 1695 bei GDPval. Claude Fable 5.1 führte die Tabelle mit 1735 an.
AA-Briefcase, entwickelt von Artificial Analysis, testet mehrstündige Büroarbeit, die Recherche, Analyse und Dokumentenerstellung zu einer einzigen langen Aufgabe verbindet, ebenfalls auf der Elo-Skala bewertet. Grok 4.7 erzielte 1657 gegenüber 1678 von Fable 5.1. Gleiches Ergebnis, anderer Test.
CursorBench 4.0, Cursors Benchmark für echte Programmieraufgaben innerhalb seines Editors, stellt die Genauigkeit den Kosten und der Token-Anzahl gegenüber, die jede Aufgabe verbraucht. Grok 4.7 landet im Mittelfeld: pro Aufgabe teurer als der Nachfolger von GPT-5.6 Sol, GPT-6 Astra, und Claude Sonnet 5, aber noch hinter Fable 5.1, das bei jedem Preispunkt im Diagramm gewinnt.
Dies ist kein neues Muster für xAI. Grok 4.5 startete im Juli mit dem größten Trainingscluster der Branche und Ergebnissen auf dem dritten Platz hinter den Modellen von Claude und OpenAI. Davor tauschte Grok 4.20 Zuverlässigkeit gegen Geschwindigkeit und Persönlichkeit. Grok 4.6 lag bei der Coding-Autonomie ebenfalls hinter dem Frontier-Paket zurück.
Nichts davon macht Grok 4.7 zu einem schlechten Produkt für die Millionen von Menschen, die über X, die eigenständige App oder das Dashboard ihres Teslas mit ihm sprechen. Es bedeutet, dass das Modell, das am wahrscheinlichsten Ihre Fragen beantwortet oder den Sprachassistenten Ihres Autos antreibt, auf einem System läuft, das die Benchmarks seines eigenen Herstellers eine Sprosse unter der Spitze der Leiter einordnen.
Diese Lücke ist der Grund, warum der Preis für die meisten Menschen mehr zählt als die Platzierung auf der Bestenliste. xAI hat Anthropic und OpenAI bei den Kosten pro Token konsequent unterboten, auch wenn es bei der rohen Leistungsfähigkeit hinter ihnen zurückbleibt, und setzt darauf, dass "gut genug, günstig und überall verfügbar" für den Großteil der alltäglichen Nutzung "am besten, aber teurer" schlägt.
Musk hatte die Erwartungen bereits Tage vor dem Start niedriger angesetzt und geschrieben, dass Grok 4.7 "ungefähr auf Augenhöhe mit" Anthropics Claude Opus 5.0 liegen sollte, nicht mit dem neueren Opus 5.1, wobei die multimodale Leistung noch Arbeit benötige.
In demselben Beitrag skizzierte er die nächsten drei Modelle: Grok 4.8 als bedeutenden Fortschritt, Grok 4.9 in der "Astra/Fable-Klasse" und Grok 5 als möglichen Frontier-Anführer. Diese Upgrades haben noch kein Veröffentlichungsdatum. "Wir werden sehen", schrieb er.