簡而言之
- Anthropic 和 OpenAI 的頂級模型每個 token 的成本比它們最小的模型高出 100 倍,然而許多使用者無論做什麼都預設使用旗艦模型。
- Meta、Amazon 和 Uber 的使用量排行榜推高了 AI 帳單,而 Uber 在大約四個月內就燒光了其 2026 年的 AI 工具預算。
- 將任務路由到正確的模型、精簡上下文、快取和批次處理能大幅削減成本,但還有其他省錢的技術。
今年早些時候,Meta 員工在 30 天內燒掉了 60 兆個 AI token,只為了在一個暱稱為「Claudeonomics」的內部排行榜上爭取名次。科技專欄作家 Gergely Orosz 估算這筆帳單按 Anthropic 的標價約為 9 億美元,不過 Meta 實際支付的費用可能遠低於此。
貝恩公司(Bain & Company)顧問 Jue Wang 在各處都看到了這種浪費的較為隱蔽版本:「這麼多公司、這麼多使用者,無論做什麼都預設使用 Opus,包括生成電子郵件,」她今年夏天告訴美聯社,指的是 Anthropic 的高階模型。如果你也這麼做,那你就是在聘請愛因斯坦來計算你在麥當勞找的零錢。
你在 ChatGPT 或 Claude 中輸入的每一個字,以及它回覆的每一個字,都以 token 計量,這些文字片段平均約為四分之三個單詞。在每月 20 美元的訂閱方案中,這個計量決定了你多快會觸及使用上限。在 API 上——開發者用來將模型接入自家應用程式的按 token 付費存取方式——它則決定了帳單金額。
以下是 Anthropic 目前的價目表,以每百萬 token 計:
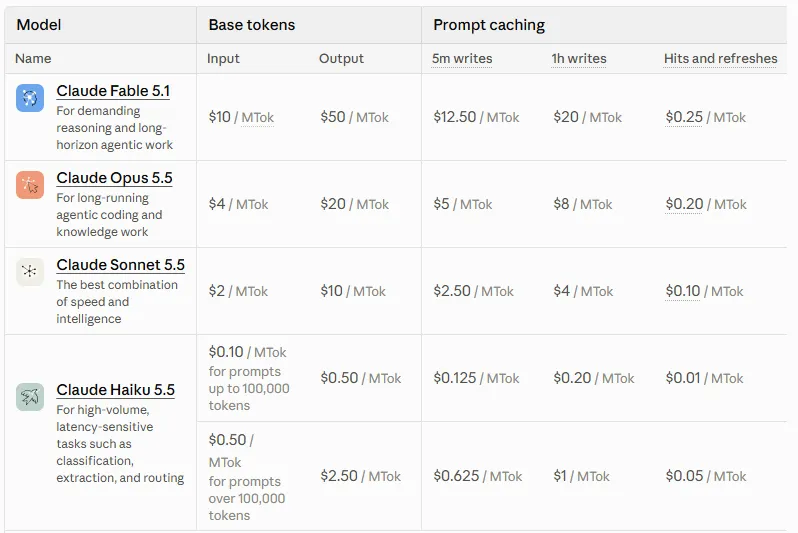
Haiku 的費率適用於低於 100,000 個 token 的提示詞;更長的提示詞費用則高出五倍。
最頂級的模型費用是最小型號的 100 倍,而 OpenAI 的自家產品線也有著同樣的價差,從每百萬輸入 token 10 美元到 0.10 美元不等。這些按 token 計的價格對實驗室——以及你——來說會迅速累積:Anthropic 的年化營收從 2025 年底的約 90 億美元,到五月時已超過470 億美元,而 OpenAI 則在打一場價格戰以跟上腳步。
幾個習慣就能大幅削減這筆開銷,而以下前五個技巧完全不需要寫程式。
tokenmaxxing 的含義(以及它應該意味著什麼)
tokenmaxxing 起初是矽谷的一種炫耀方式,就像 Meta 的 Claudeonomics 那樣,微軟、Shopify 和亞馬遜也以類似的 token 排行榜來為員工排名。Nvidia 執行長黃仁勳在三月於「All-In」播客上說,如果一位年薪 50 萬美元的工程師沒有燒掉至少價值 25 萬美元的 token,他會「深感震驚」,這番話更是火上加油。
而他們確實燒掉了 token……燒在一些愚蠢且毫無生產力的事情上。
在亞馬遜,員工承認誇大了他們的數字,方法是讓內部 AI 工具執行無關的任務,直到一位資深副總裁告訴員工:「請不要只是為了用 AI 而用 AI。」
本指南採用工程師們現在所推動的含義:最大化每個 token 的價值,而不是你花費的數量。
三個概念解釋了 token 都去了哪裡,首先是代理迴圈。代理是一個可以使用工具的模型,因此它會思考、搜尋網路或執行程式碼、讀取結果,然後再次執行,直到它決定完成為止,每一輪都會重新傳送整段對話。
編排會使這項成本倍增:一個模型扮演管理者,將你的請求拆分成多個部分,交給稱為子代理的工作模型,再將它們的答案拼接回去。每個工作者都用自己的記憶執行自己的迴圈,這就是為什麼 Anthropic 表示,當隊友在計畫模式下執行時,Claude Code 中的代理團隊可能使用約七倍於標準工作階段的 token,該設定會在下方的中級技巧中涵蓋。
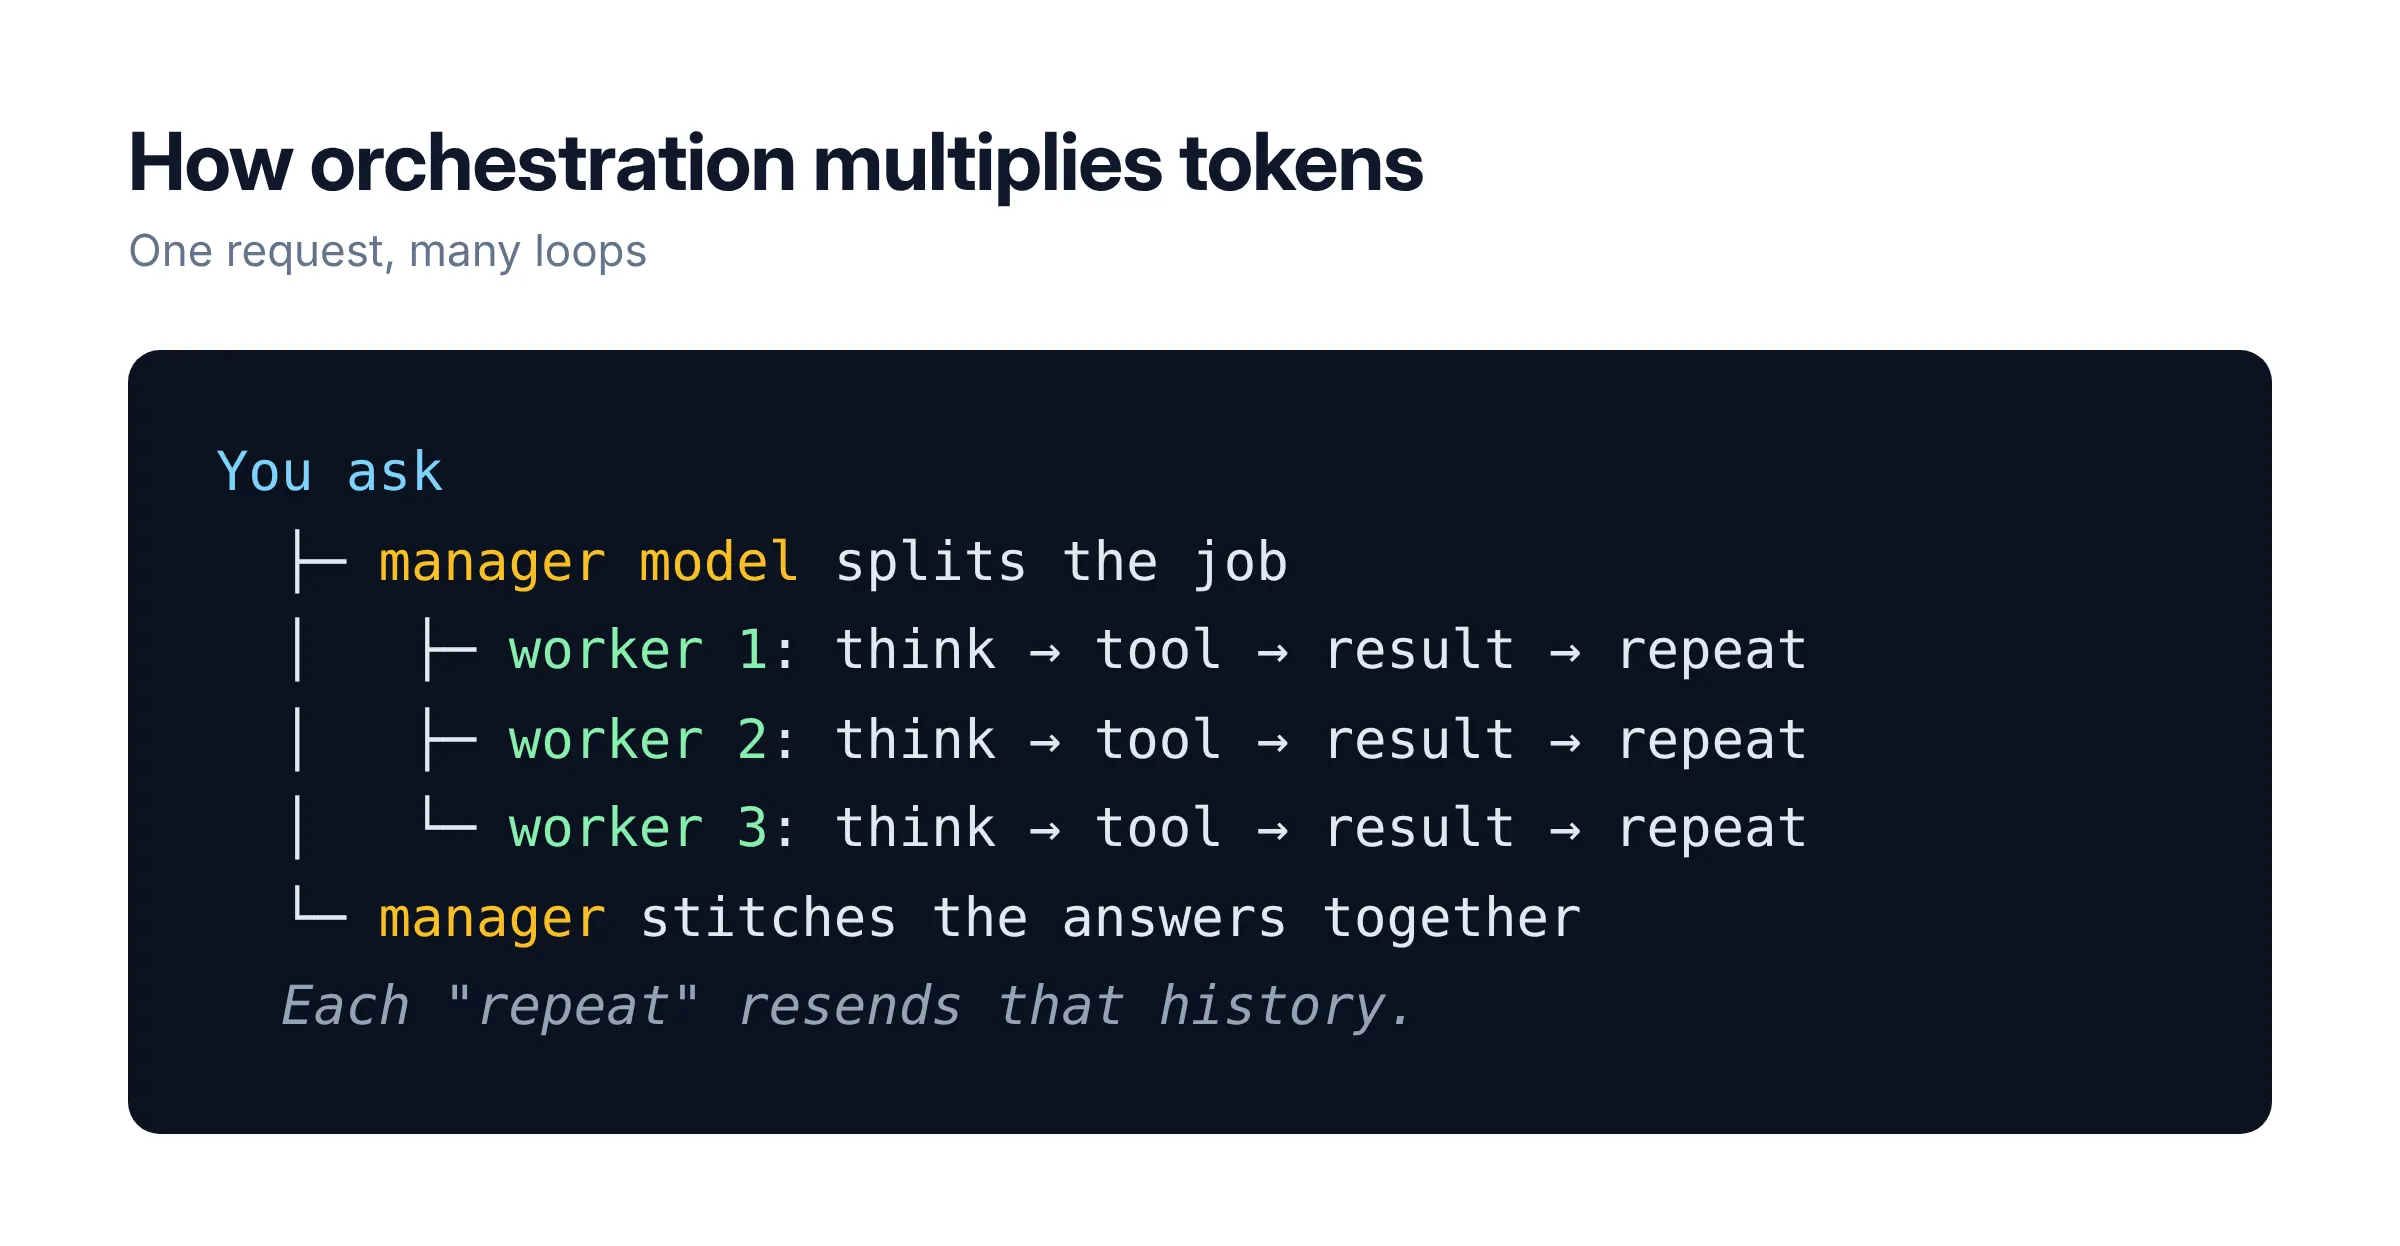
圖是開發者防止這些迴圈偏離軌道的方式。像 LangGraph 這樣的框架讓你像畫地鐵圖一樣繪製工作流程,由站點(節點)執行工作,由軌道(邊)決定下一步去哪裡,因此模型會遵循固定路線,而不是一直迴圈直到耗盡想法或預算。
換句話說,迴圈能幫助你自動化事情並提升品質,但你也會花很多錢,因此保持效率極其重要。以下是一些可能對你有幫助的技巧
初階:小任務,小模型
1. 為任務挑選合適的模型
如果你才剛開始,你很可能正在使用圖形使用者介面來執行你的 AI。
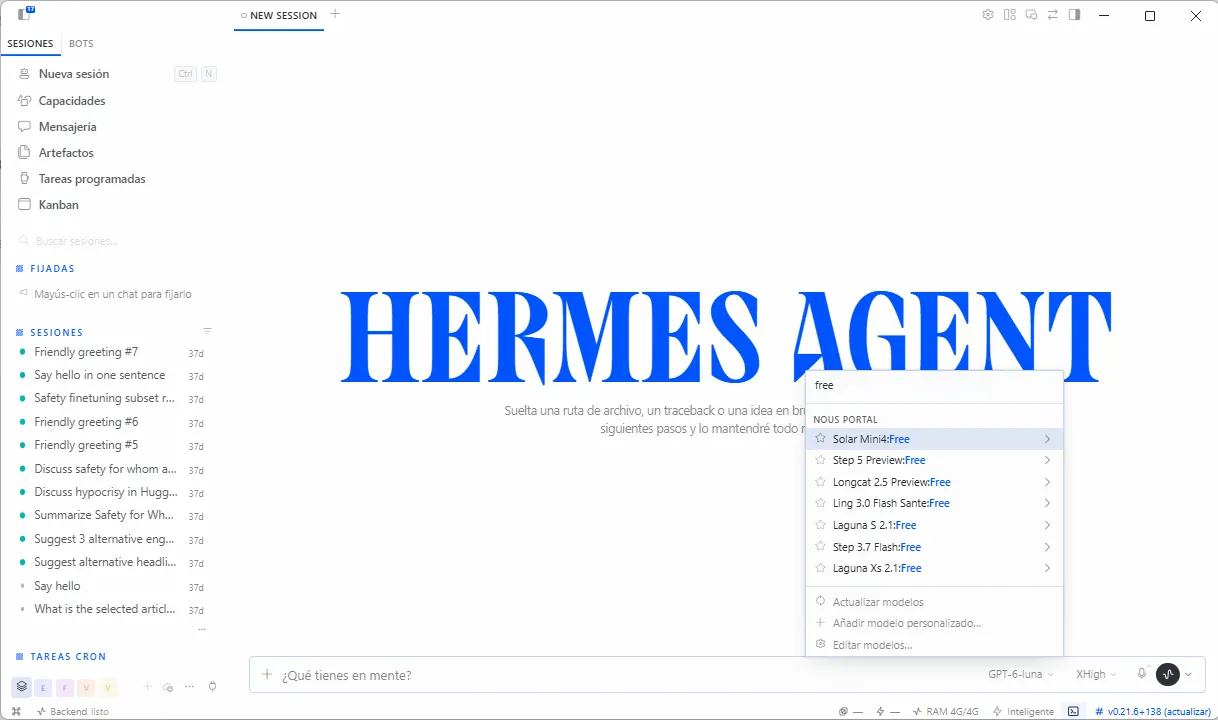
在你的聊天應用程式中點擊模型名稱(在 ChatGPT 中位於聊天視窗頂部,在 Claude 或 Hermes 中位於傳送按鈕旁),並切換到更小、更快的選項,用於電子郵件、摘要和改寫。把頂級模型留給困難的推理和決策,因為在這些情況下,一個細微的錯誤會造成實際的金錢損失。
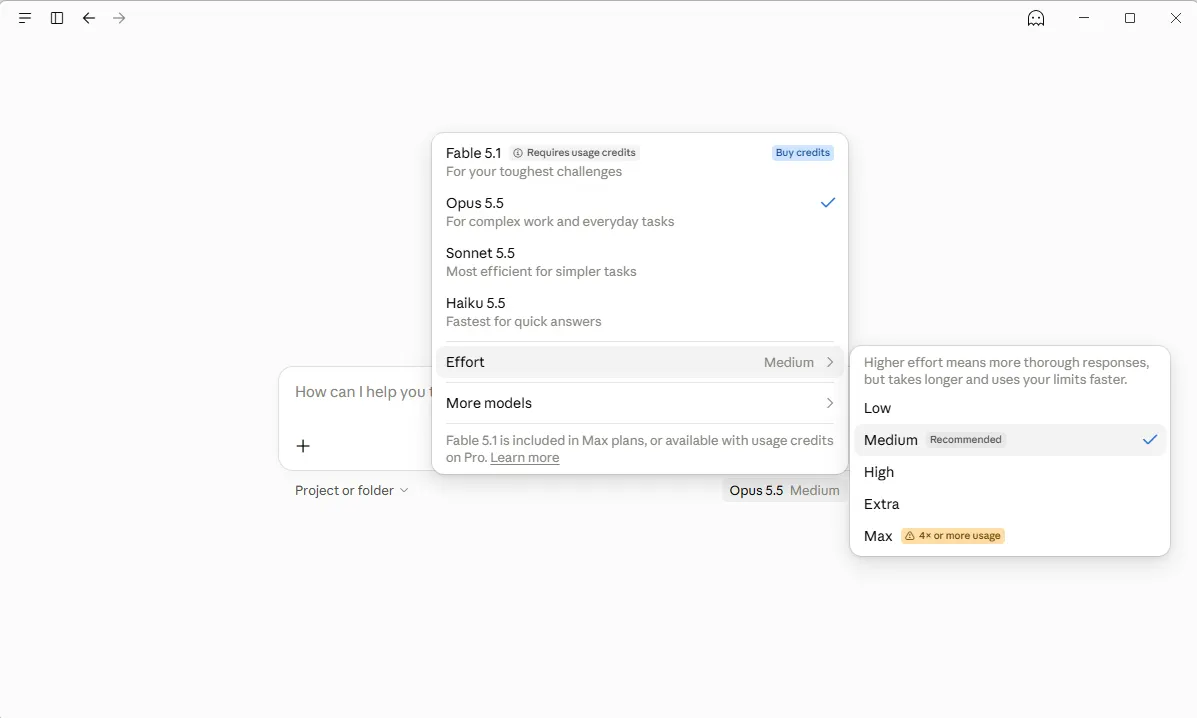
在兩個模型上並排執行上週的五項任務,如果小模型能通過,就繼續用它。在會讓你超出使用上限的訂閱方案上,以及在 API 上,這能將帳單削減多達 99%。
2. 寫一個好的提示詞,而不是五個糟糕的提示詞
三輪「不,只要總計就好」或「讓這個更好、更準確」的來回,每次都會重新傳送整段對話。一個清楚的提示詞會明確說明任務內容以及答案的確切格式。像下面這樣的提示詞可能就管用:
從下方文字中擷取發票號碼、日期、供應商和總計。每個值都完全按照原文保留。每個欄位輸出一行,如果某個欄位不存在,就寫「missing」。
OpenAI 自己的測試發現,更精簡、更清晰的提示詞 得分更高,同時使用的 token 更少。
3. 當你改變主題時,開啟一個新的對話
每次你按下傳送,模型都會重新閱讀整段對話,所以一段關於你假期的 50 則訊息串,會讓你的稅務問題同時變得更貴又更笨。
Anthropic 稱這種衰減為「上下文腐化(context rot)」。
所以,拜託,每當主題改變時就開啟一個新的對話。
4. 要求你需要的篇幅
在 Anthropic 和 OpenAI 的頂級模型上,輸出 token 的成本是輸入的五倍。在你的提示詞結尾加上類似「三個要點,100 字以內」或「只列出變更的行」,模型就比較沒有空間灌水。
如果模型在輸出長度上受到限制,它就會節省 token,尤其是當任務屬於創意型(例如寫作或研究)而非確定型(例如寫程式或解數學)時。
5. 付費前先試用免費的
OpenRouter 是一個透過單一帳號就能連上數百個 AI 模型的網站,它有一個 免費路由器,會把你的請求送到大約 20 個免費模型中的一個。你也可以在具備 8GB 視訊記憶體的顯示卡或 Apple M 系列 Mac 上,用 LM Studio 或 Ollama 在本機執行模型。
免費方案可能 一夜之間消失,所以不要在上面建立任何重要的東西,而且在貼上任何敏感內容之前,先閱讀資料政策。
話雖如此,你可以利用免費優惠來最大化你的反覆嘗試次數。Hermes 有不錯的免費模型選擇,可能足以完成你需要的任務,Nvidia 也是如此。用免費、較笨的模型來調整提示詞,總比付費使用高階模型、做同樣的事但更快來得好。
其他初學者提示
對於簡單的問題,跳過延伸思考,或在無法關閉思考功能的較新 Claude 模型上降低投入程度設定。Anthropic 會將完整的思考過程計為輸出,包括你從未看到的部分。
開啟使用額度的 Claude Pro 與 Max 訂閱者,可以在「設定」下的「用量」中設定每月支出上限。
中階:你的代理讀取太多內容了
從這裡開始,範例使用 Claude Code,這是 Anthropic 的代理,在你的終端機中執行並替你編輯檔案;指令直接輸入它的聊天框。其他框架會有類似的邏輯。
如果你只使用聊天應用程式,提示 8 在任何聊天視窗中也適用。
6. 從便宜開始,失敗時再升級
輸入 /model 來切換模型,將 Sonnet 保持為你的預設,只有在 Sonnet 在某個特定任務上失敗時才升級到 Opus,例如一個它試了兩次仍無法修復的錯誤。對於簡單的子代理任務,Anthropic 的文件建議在子代理的設定中設定 model: haiku。
7. 在任務之間清除
當你切換到不相關的任務時,輸入 /clear,這不花費任何成本,並會捨棄舊的歷史記錄。只有在需要歷史記錄時,才使用 /compact 並附上要保留內容的註記,例如 /compact keep the database decisions,因為壓縮本身就是一个大型請求。
8. 讓程式碼來做枯燥的數學
把一份 5,000 列的試算表貼進對話中,會讓模型逐列閱讀,而且它仍可能算錯,因為語言模型不是計算機,無論你付多少錢都一樣。
改為向它要一個公式或一段簡短的腳本,由你自己執行,然後只把結果交給模型。
9. 精簡你的工具
MCP 伺服器是將模型連接到 GitHub 或 Google Drive 等應用程式的外掛,每一個都會在每個工作階段中增加工具名稱與指示。
輸入 /context 來查看是什麼佔用了空間,並輸入 /mcp 來停用專案未使用的伺服器。
其他進階技巧
輸入 /usage 來查看你的 token 都花到哪裡去了。將你的 CLAUDE.md(或 Soul.md),也就是你的代理在每個工作階段開始時所讀取的指示檔案,保持在 200 行以內。
對於較大的變更,按下 Shift+Tab 切換到計畫模式,在此模式中代理會在動到檔案之前先提出計畫供你核准,而一旦它走錯方向就立刻按下 Esc。使用 /effort 來為像是重新命名變數這類簡單工作調低推理強度。
Anthropic 展示了當代理只載入它所需的工具定義時,其 token 使用量從 150,000 個 token 降到 2,000 個,因此像 GitHub 的 gh 這類在執行前不花任何成本的命令列工具,往往勝過一個常駐的外掛。
進階:將防護機制內建到系統中
假設一位開發者需要處理 1,000 張發票,每張 2,000 個 token,答案為 200 個 token:在套用以下任何技巧之前,這項工作在 Fable 5.1 上約花費 30 美元,在 Haiku 5.5 上約花費 0.30 美元。
10. 快取那些永不改變的部分
將穩定的指令放在前面,將變動的部分放在最後,並標記穩定區塊以供快取。在 Anthropic 的 API 中,那只是一個額外欄位:
"system": [{
"type": "text",
"text": "Your invoice instructions...",
"cache_control": {"type": "ephemeral"}
}]
從快取讀取的成本僅為正常輸入價格的一小部分,而寫入預設的五分鐘快取則需額外付費。檢查每次回應中的 cache_read_input_tokens 欄位;如果在第一次呼叫後它仍然顯示為零,則表示快取沒有運作。
11. 將任何可以等待的任務批次處理
OpenAI 和 Anthropic 都以 50% 的折扣處理批次任務,OpenAI 承諾在 24 小時內提供結果。將 1,000 張發票作為一個批次檔案上傳,而不是進行 1,000 次即時呼叫,帳單就會大幅下降。
12. 給代理加上牽繩
為每次代理執行設定最大步驟數和金額上限,並在開始前定義好「完成」的樣子。Claude Code 接受 --max-budget-usd 旗標用於腳本化執行,而 Shopify 使用斷路器,如果開發人員的支出在一天內飆升,可以立即切斷其存取權限,專門用來攔截失控的代理。
現在,正常的做法實際上是讓那些代理自由運行,並讓它們循環直到結果被認為完美為止。如果你沒有錢,就不要只是讓你的代理決定什麼是或不是「完美」。
額外進階技巧
將關鍵事實放在長提示的開頭或結尾。一項史丹佛大學主導的研究發現,模型在這些位置最能有效利用資訊,而當資訊被埋在中间時效果最差。
只有在錯誤代價高昂時(例如合約條款或付款金額),才付費使用第二個模型來檢查工作。在 OpenAI 的 API 上,為每個專案開啟硬性支出上限,因為其支出警示只會通知你,並不會停止流量。
從一個測試開始
把通過提示 1 中五項任務測試的最便宜模型設為你接下來一週的預設模型,只在它失敗時才切換。然後將你的用量頁面與前一週的進行比較;在發票這項工作上,光是路由就讓帳單從 30 美元降到 3.90 美元,即使還付錢給 Opus 5.5 重做了 300 次失敗。
不過,更便宜的 token 本身並不足以解決問題:根據 Silicon Data 的 Token 支出指數,單一 token 的價格自 2023 年以來已下跌超過 90%,然而大型語言模型的支出自 2025 年底以來卻翻了一倍。
經濟學家稱之為傑文斯悖論,即當一種資源變得如此便宜,以至於人們最終在它上面的總支出反而更多。貝恩公司六月的一份簡報發現了同樣的模式:在 2024 年 12 月至 2025 年之間,token 成本減半,而消耗的 token 數量卻增長了 450%。
好處在於,一旦你不再為了消遣而燃燒 token,同樣的價格下跌就會對你有利:將它們與上述習慣結合起來,AI 就會同時變得更便宜、更好用。