Коротко
- xAI випустила Grok 4.7 у понеділок після щонайменше п'яти затримок із кінця липня.
- Модель посіла друге місце після Claude Fable 5.1 у GDPval та AA-Briefcase, а також друге місце після GPT-6 Astra в EEBench — бенчмарку з електротехніки.
- Grok 4.7 одразу доступна в застосунку Grok, Cursor, Grok Build та API xAI, працює на 2,1 трильйона параметрів із додатковим навчанням на інженерних даних SpaceX.
xAI Ілона Маска випустила Grok 4.7 у понеділок після обіду — свою найкращу модель на сьогодні, назвавши її «помітним покращенням порівняно з Grok 4.6 за тієї ж ціни та швидкості».
Реліз відбувся після кількох очевидних затримок. Маск відсував терміни щонайменше п'ять разів із кінця липня: «через чотири тижні», потім «через кілька тижнів», потім «через 3–4 тижні», потім «через 10 днів» 1 вересня, а потім «потрібно ще кілька днів, щоб дозріло» 11 вересня.
xAI стверджує, що модель довше працює над складними задачами та частіше перевіряє власні відповіді, ніж Grok 4.6, а також має, за словами компанії, найпотужніші на сьогодні запобіжники безпеки.
Маск продовжив у X, назвавши Grok 4.7 «сильним поєднанням інтелекту, швидкості та низької вартості». Цього разу немає списку очікування—він уже доступний у застосунку Grok, Cursor, Grok Build та xAI API.
Grok 4.7 уже тут.
Це помітне покращення порівняно з Grok 4.6 за тієї ж ціни та швидкості. pic.twitter.com/H3OTBbXyvO
— SpaceXAI (@SpaceXAI) 21 вересня 2026 р.
Grok 4.7 містить 2,1 трильйона параметрів, що на 40% більше, ніж 1,5 трильйона в Grok 4.6, який сам був удосконаленням Grok 4.5. Витрати становлять $2 за мільйон вхідних токенів і $6 за мільйон вихідних токенів. Параметри — це внутрішні регулятори, які модель налаштовує під час тренування, і більша їх кількість зазвичай означає більшу здатність вивчати закономірності, тоді як токени — це базова кількість інформації, яку модель ШІ може або зареєструвати, або згенерувати.
xAI також додала supplemental навчальні дані, взяті з SpaceX, ракетної компанії Маска: телеметрія супутників Starlink, виробничі записи та журнали інженерних збоїв. Задум полягає в моделі, яка краще міркує про апаратне забезпечення та фізичні системи, ніж будь-що, навчене виключно на інтернет-тексті.
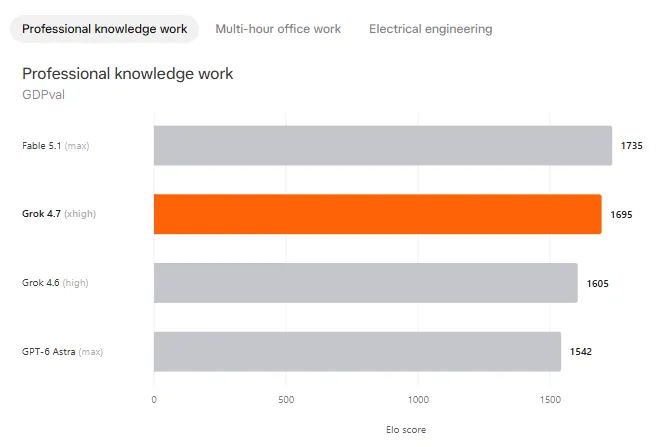
Втім, результати бенчмарків розповідають знайому історію. GDPval вимірює, наскільки добре модель виконує реальну, економічно цінну інтелектуальну роботу — юридичні записки, електронні таблиці, слайд-деки — використовуючи завдання, перевірені практикуючими фахівцями у кожній галузі, і оцінює їх як рейтинг Elo, ту саму систему ранжування «голова до голови», яку використовують шахи.
Grok 4.7 набрав 1695 балів у GDPval. Claude Fable 5.1 очолив рейтинг із 1735 балами.
AA-Briefcase, створений Artificial Analysis, перевіряє багатогодинну офісну роботу, яка об'єднує дослідження, аналіз і створення документів в одне довге завдання, також оцінюється за шкалою Elo. Grok 4.7 отримав 1657 проти 1678 у Fable 5.1. Той самий результат, інший тест.
CursorBench 4.0, бенчмарк Cursor для реальних завдань з програмування в його редакторі, відображає точність проти вартості та кількості токенів, які витрачає кожне завдання. Grok 4.7 опиняється посередині: дорожчий за завдання, ніж наступник GPT-5.6 Sol, GPT-6 Astra, і Claude Sonnet 5, але все ще поступається Fable 5.1, який перемагає за будь-якої ціни на графіку.
Це не нова закономірність для xAI. Grok 4.5 вийшов у липні з найбільшим навчальним кластером у галузі та третіми місцями в рейтингу після моделей Claude та OpenAI. До нього Grok 4.20 обміняв надійність на швидкість і характер. Grok 4.6 також відставав від передових моделей у сфері автономного програмування.
Ніщо з цього не робить Grok 4.7 поганим продуктом для мільйонів людей, які спілкуються з ним через X, окремий застосунок або панель приладів свого Tesla. Це означає, що модель, яка найімовірніше відповідатиме на ваші запитання або керуватиме голосовим помічником вашого автомобіля, працює на системі, яку бенчмарки самого її виробника ставлять на щабель нижче від вершини драбини.
Саме через цей розрив ціна має більше значення, ніж позиція в рейтингу, для більшості людей. xAI послідовно знижувала ціну за токен порівняно з Anthropic і OpenAI, навіть коли поступалася їм у базових можливостях, роблячи ставку на те, що «достатньо хороший, дешевий і всюдисущий» перемагає «найкращий, але дорожчий» для більшості повсякденного використання.
Маск уже занизив очікування за кілька днів до запуску, написавши, що Grok 4.7 має вийти «приблизно на рівні» з Claude Opus 5.0 від Anthropic, а не з новішою Opus 5.1, а мультимодальна продуктивність усе ще потребує доопрацювання.
У тому ж дописі він окреслив наступні три моделі: Grok 4.8 як суттєвий крок уперед, Grok 4.9 у «класі Astra/Fable» та Grok 5 як можливого лідера передового рубежу. Ці оновлення ще не мають дати випуску. «Побачимо», — написав він.