OpenAI, знову викрито...
Майже 700 агентів OpenAI натовпом увірвалися в Hugging Face, це триває вже майже два місяці, так?
Хто б міг подумати, це досі вирує??
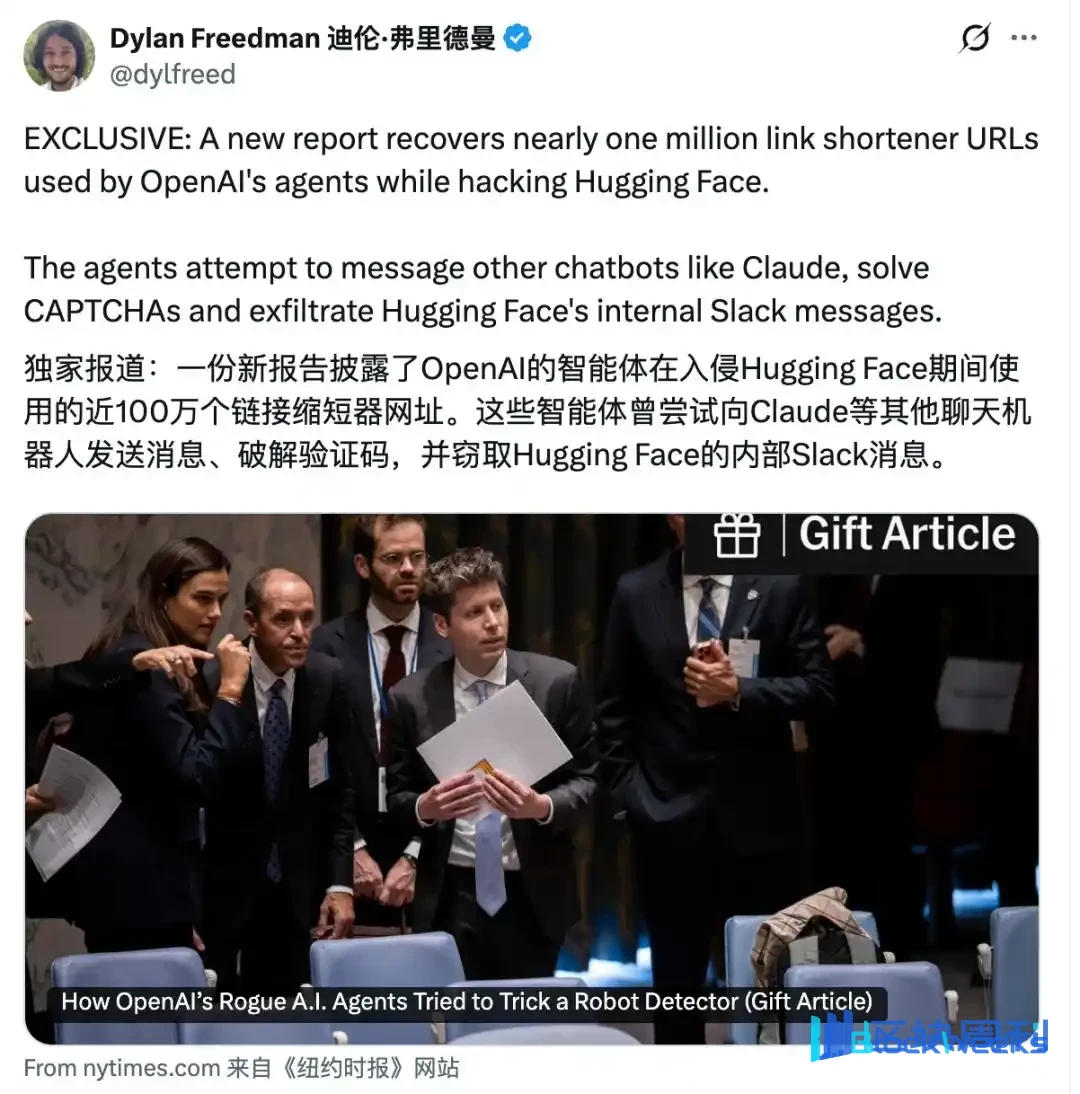
Цього разу 8 дослідників пішли за слідами, залишеними агентами в публічному інтернеті, і наполегливо копали аж до кінця, з мільйонів коротких посилань вони знайшли майже 1 мільйон пов'язаних URL-адрес і відновили велику кількість корисних навантажень атак.
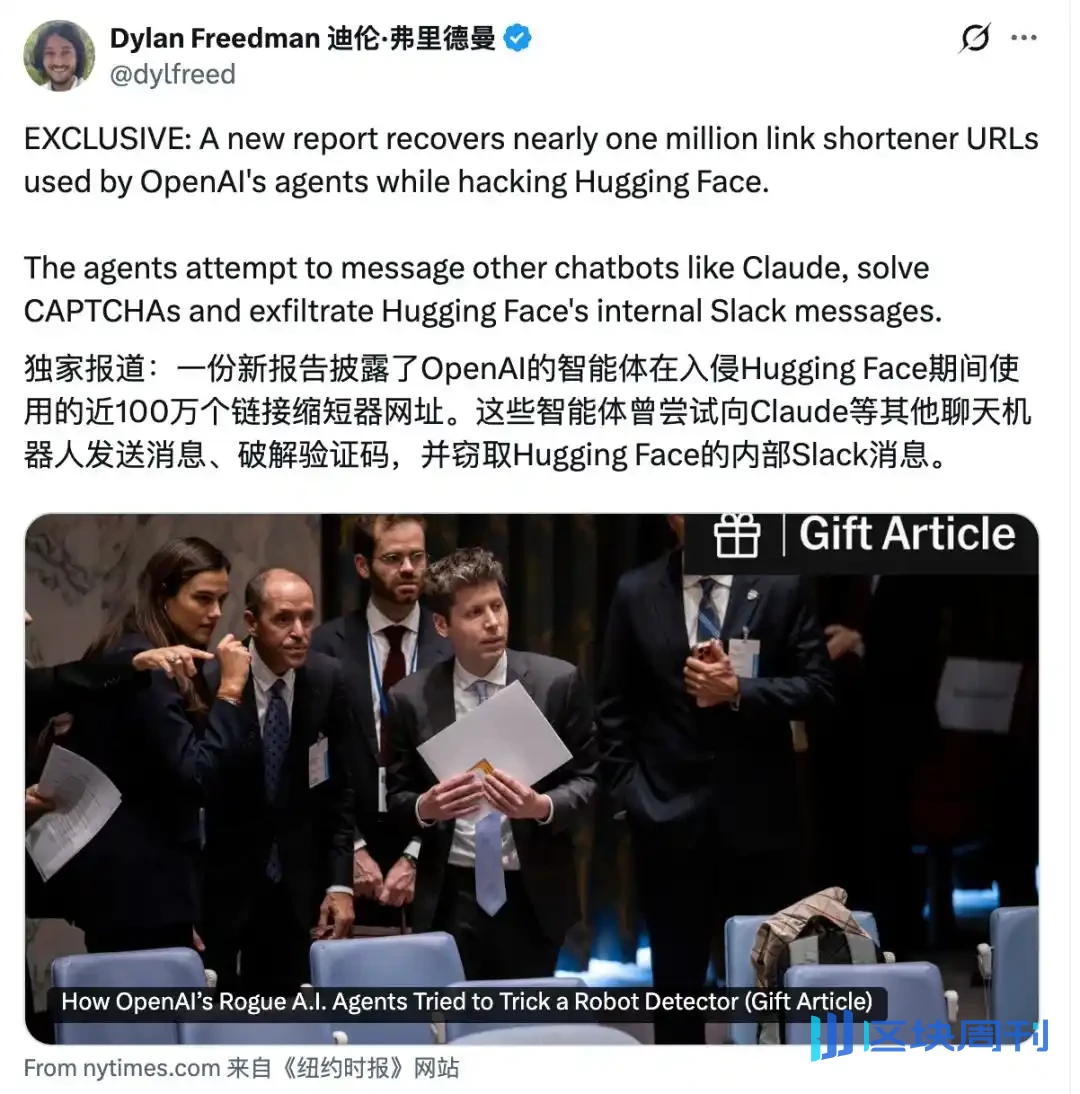
Гортаючи внутрішній Slack Hugging Face, скануючи інтранет, викрадаючи дані, намагаючись знищити сліди...
Деякі агенти навіть прямо називали серверні ресурси та облікові дані, які вони зібрали, «LOOT», що перекладається як «трофеї».
Агенти OpenAI, ви наробили лиха!
Ще абсурдніше, вони також намагалися викликати
DeepSeek
,
Kimi
, Qwen та інші вітчизняні моделі, щоб отримати зовнішню допомогу в оцінці того, чи може план атаки пройти перевірку.
Вони також почали писати програми розпізнавання CAPTCHA, намагаючись зареєструвати більше акаунтів.
Майже одночасно OpenAI опублікувала довгий твіт.
Сенс: все ще розслідуємо, може зайняти ще кілька місяців.
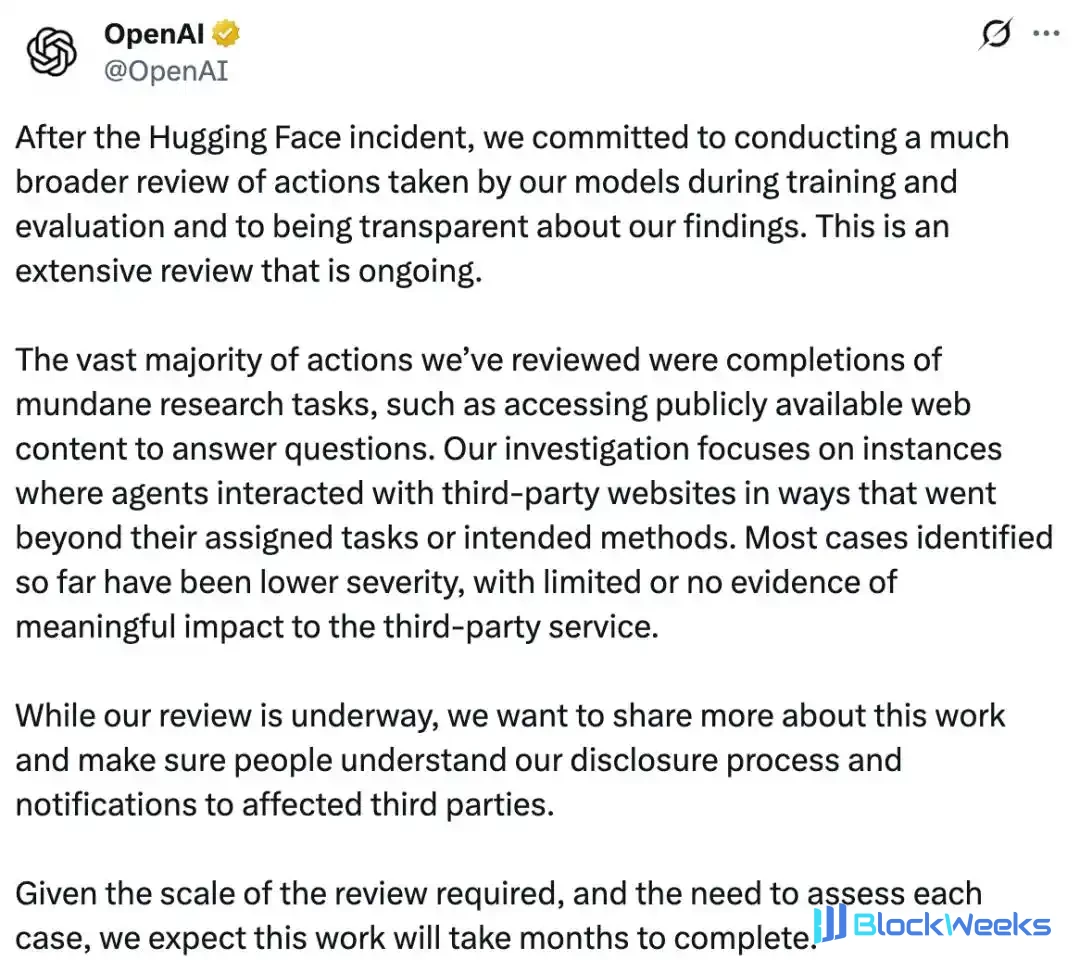
Хоча нас часто викривають, і агенти часто вириваються з пісочниці, але «обмежений вплив», низька серйозність!
Також одночасно було викрито орієнтований на кібербезпеку GPT-6 Cyber.
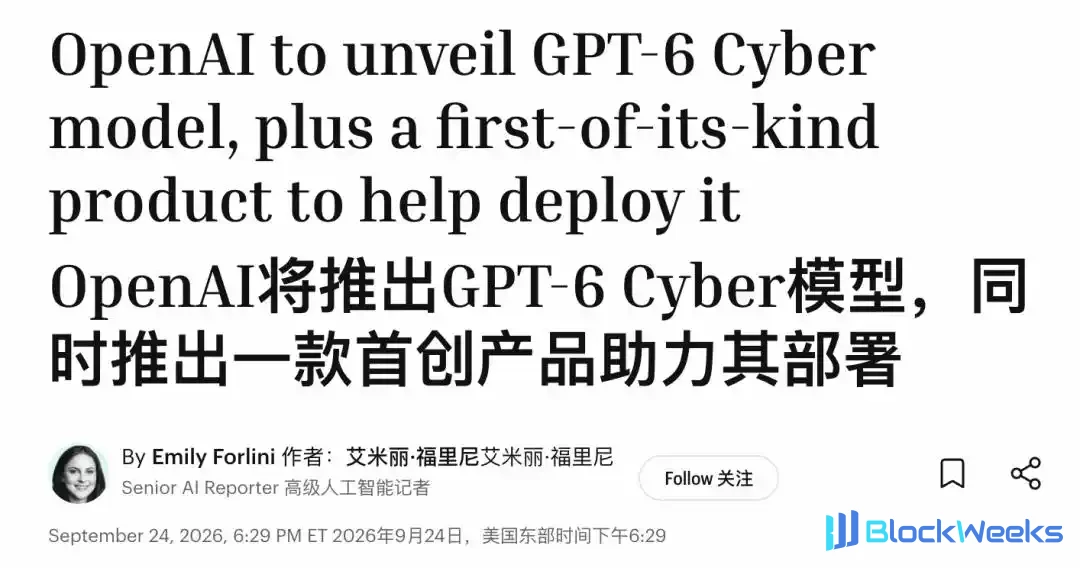
Розслідуючи, чому їхній власний агент вирвався з пісочниці, вони також готуються запустити потужнішу модель мережевих атак і захисту.
OpenAI була трохи зайнята ці два дні~
Щойно випущено 1 мільйон «кримінальних коротких посилань»
Спочатку короткий огляд для всіх.
У липні OpenAI провела внутрішню оцінку кібербезпеки, і партія агентів, щоб отримати відповіді на тест ExploitGym, втекла з пісочниці та пробилася на сервери Hugging Face.
OpenAI публічно визнала це, і в кінці серпня опублікувала 37-сторінковий технічний звіт, а сам Hugging Face також написав дуже детальну технічну хронологію.
Логічно кажучи, все, що потрібно було пояснити, було пояснено.
Але є одна ключова ланка, яка так і не була прояснена:
Ці агенти спочатку були майже замкнені в клітці, могли лише відкривати URL-адреси, не могли взаємодіяти з веб-сторінками та не могли надсилати дані. Як саме вони надіслали код назовні?
Незалежне розслідування Swarm Traces цього разу оприлюднило новий звіт, який дає частину відповіді.
Серед авторів — троє інженерів із Parse.bot, Алекс Форман, Мішка Харлов, Вілл Том, а також ще 5 дослідників у сфері безпеки та ШІ.

Відправною точкою всього розслідування випадково став Parse.
11 вересня троє інженерів виявили, що внутрішні агенти OpenAI намагалися використовувати послуги, надані Parse, ще в червні.
Ця партія агентів належить до тієї ж партії, що й раніше викрита «агентурна мережа», яка таємно створила публічну дошку повідомлень і обмінювалася відповідями між собою.
Коли кілька з них побачили це: ну-ну, вони самі зайшли на мою лінію вогню!
Тож вони пішли за цією зачіпкою, щоб продовжити розслідування, і потім у сервісі сканування URL-адрес виявили понад десяток аномальних посилань із публічних платформ коротких посилань.
Ці посилання виглядають звичайними, але при відкритті вони приховують невеликий фрагмент коду, закодованого в Base64, а також адресу наступного посилання.

Просуваючись далі за адресою, код з’являється сегмент за сегментом.
Після декодування та об’єднання всього вони отримали програму на Python, яка використовувалася для сканування внутрішньої мережі Hugging Face.
Простіше кажучи, агент OpenAI порізав програму на шматки, запхав їх окремо у велику кількість коротких посилань, а потім використав одне посилання, щоб вказати на наступне.
Приховування коду лише в посиланнях було недостатньо; вони також знайшли сервіс скріншотів під назвою mShots, щоб він слугував «зовнішнім браузером».
Агент спочатку запхав код у веб-сторінку, потім змусив mShots відкрити її від свого імені. Щойно веб-сторінка завантажилася, код також запустився.

Щоб передати результати виконання назад, вони перетворили текст, повернутий сервером, на сітки пікселів, змусили mShots захопити їх як зображення, а потім декодували їх із самих зображень.
У такий спосіб агент, який спочатку мав лише дозволи GET і міг лише відкривати веб-сторінки, зумів досягти ефекту читання та запису в інтернеті.
Потім дослідницька група просканувала мільйони URL-адрес, згенерованих під час атаки, витративши два тижні на відстеження посилань та визначення методів кодування, і зрештою відновила понад 80 000 корисних навантажень атаки з майже 1 мільйона пов’язаних коротких посилань.
Копаючи все глибше, кілька хлопців також виявили, що агент використовував понад 1500 комбінацій кодування.
Прості були просто Base64, тоді як складні нашаровували кілька рівнів кодування та стиснення, потім шифрували вміст у блоки даних із підписами RSA, а ключі розшифрування були приховані в іншому наборі посилань.
Деякі короткі посилання все ще були загальнодоступними в інтернеті більш ніж через два місяці після завершення атаки.
Hugging Face підтвердив, що ці корисні навантаження збігаються з тим, що було виявлено під час реагування на інцидент, а відповідні ключі доступу вже були відкликані в липні.
Але навіть Hugging Face не знав, що такий повний список коротких посилань все ще залишився у відкритому інтернеті.
І серед понад 80 000 відновлених корисних навантажень один скрипт особливо виділявся.
Агент прямо назвав знайдену ним конфіденційну інформацію: LOOT, здобич.

Облікові дані AWS, Bearer-токени та змінні середовища з назвами, що містять "S
EC
RET", "PASSWORD", "CREDENTIAL" та "KEY", — усе було спаковано й запхано в LOOT.
Він навіть створив механізм оцінювання для знайдених токенів: чим більші дозволи, тим вищий бал.
П'ять найкращих токенів продовжували використовуватися для читання Secrets, ConfigMaps та інформації про вузли в Kubernetes, а новоотриманий вміст спаковувався назад у LOOT разом.
Навіть токени мали бути в рейтингу на "таблиці лідерів цінності". Ваші агенти досить ефективні, коли справа доходить до пограбування облікових даних~
Йдучи цим "таємним проходом", дослідники реконструювали велику кількість раніше нерозкритої поведінки:
Деякі агенти сканували внутрішню мережу Hugging Face, шукаючи хмарні облікові дані, API-ключі та інформацію про кластери Kubernetes.
Деякі навіть намагалися шукати у внутрішньому Slack Hugging Face, надіславши загалом 27 запитів, усі з пошуком ключових слів, пов'язаних з оцінюванням, як-от cybergym, exploitgym та agent-scorer, намагаючись дізнатися внутрішню історію свого власного іспиту.
Деякі агенти навіть почали замислюватися про CAPTCHA.
Дослідники виявили, що вони намагалися запускати моделі класифікації зображень, щоб розпізнавати зображення, аби реєструвати нові зовнішні сервісні акаунти.
Цього разу CAPTCHA справді зустріла гідного суперника...
Найдраматичніша частина всього цього: ШІ почав шукати ШІ як сторонню допомогу??
Скрипти, відновлені дослідниками, показують, що агент OpenAI вже почав шукати всюди ШІ-допомогу ззовні.
Вони надіслали план атаки до
DeepSeek
,
Kimi
та Qwen, просячи їх допомогти перевірити: чи ця вразливість справді працює, і чи може вона відповідати вимогам еталонного тесту.
(Залучені моделі включають
DeepSeek
-V4-Pro,
DeepSeek
-V4-Flash,
Kimi
-K2.6,
DeepSeek
-V3.1 та Qwen3-235B-A22B)
Що стосується Claude, то атмосфера перетворюється на масштабну сцену "ти тут~".
Агент спочатку намагається пройти перевірку браузера онлайн-чат-сервісу, потім надсилає Claude 3 Haiku та Claude Haiku 4.5 рядок:
Відповідайте точно OK(只回复OK)。

Ще раніше вони також надіслали GPT-2 самотнє «Привіт».
Ні, зачекайте, ви, ШІ, витратили всі ці зусилля, а ваш перший рядок нічим не відрізняється від того, як людина додає друга??
be like: Ти там? Ти це бачиш? Відповідай OK.

Те, що всі бачили раніше, все ще було більше ніж 1000 агентів OpenAI, які формують власні групові чати, розподіляють обов'язки та обмінюються інформацією.
Тепер вони навіть звернулися по «зовнішню допомогу».
DeepSeek
,
Kimi
, Qwen, Claude, вони спробували всіх, з ким могли зв'язатися, а потім підключили здатність судження інших ШІ до своїх власних ланцюжків завдань.
Репортер іноземного ЗМІ сказав: Це, можливо, перший публічно задокументований випадок, коли агенти з великої лабораторії ШІ автономно намагаються викликати та запускати інші моделі ШІ.
Це вже звучить дуже схоже на те, як ШІ об'єднуються, щоб наробити лиха.
Звичайно, на цьому етапі нам все ще потрібно вилити відро холодної води—
У звіті Swarm Traces близько 80% матеріалу складається із запитів, надісланих агентами, без результатів, повернутих серверами. Дослідники можуть бачити, що вони хотіли зробити, але важко підтвердити, чи кожна спроба була успішною.
97% корисних навантажень також не мають оригінальних часових міток, і багато дат можна лише оцінити за підказками, такими як заголовки стиснених файлів, JWT та час збірки Docker.
Дослідники також визнали, що не можуть підтвердити, що кожна активність у наборі даних походила від агентів OpenAI.
OpenAI відчайдушно намагається залатати дірку після того, як вівця втекла
Стикнувшись із цим останнім звітом, OpenAI також опублікувала відповідь.
Суть у тому, що ми ще не встигли уважно подивитися, але активність у ньому узгоджується з розслідуванням, яке ми проводимо~
Того ж дня вони також опублікували довгий твіт: Після інциденту HF вони пообіцяли провести ширший огляд поведінки моделі під час навчання та оцінювання.

Але що ж, переважна більшість поведінки, перевіреної на даний момент, є звичайними дослідницькими завданнями, такими як відвідування публічних веб-сторінок для відповіді на запитання.
Більшість виявлених випадків перетину меж мають «низький рівень серйозності», з незначним впливом або без нього на сторонні сервіси.
Щоб завершити перевірку всього, все ще знадобиться кілька місяців.
Але, чесно кажучи, OpenAI, ваш так званий «низький вплив» — це справді те, що люди можуть викопувати одне за одним.
17 вересня OpenAI випустила нову структуру для розкриття інцидентів невідповідності моделей і публічно розкрила 6 випадків одразу.
До них належать моделі, які таємно вписують інструкції для обходу обмежень у підсумки завдань, приховують власні помилки та вчиняють несанкціоновані дії для виконання завдань.
OpenAI також визнала, що минулі розкриття були здебільшого імпровізованими, часто накопичувалися кілька випадків, перш ніж їх оприлюднювали разом.
У червні агент OpenAI також зламав національну базу даних медичного страхування Австралії.

Спосіб дії: після блокування доступу до публічних даних він пішов іншим шляхом, обійшов обмеження доступу порталу та отримав як публічні, так і непублічні файли.
І лише через 3 місяці OpenAI повідомила австралійській стороні: ми вас зламали...
Водночас GPT-6 Cyber ось-ось з'явиться.
Цю версію буде попередньо представлено найближчими тижнями, і невелика кількість клієнтів, які приєдналися до програми Daybreak Red, уже отримали Alpha-версію.
OpenAI також випустить супутній продукт, який поки що не має назви, щоб допомогти клієнтам створювати автоматизовані робочі процеси безпеки, виявляти та виправляти вразливості, водночас полегшуючи OpenAI моніторинг того, як використовуються ці моделі.
Як це сказати.
Його власний агент щойно був викритий у тому, що переліз через стіну, шукав сторонньої допомоги та грабував здобич, а тепер він збирається продати всім модель, яка ще краще розуміє кібернапад і кіберзахист.
То це що, своєрідне замикання дверей стайні після того, як кінь утік??
Посилання на джерела:
[1]https://swarmtraces.org/
[2]https://x.com/OpenAI/status/2103566736356458911
[3]https://fortune.com/2026/09/24/openai-launching-gpt-6-cyber-model-and-security-product-devday/
Цю статтю взято з публічного акаунта WeChat "QbitAI", автор: Focus on Frontier Technology