ШІ-математика перетинає дуже тонку розділову лінію.
Раніше ми запитували: чи може велика модель розв’язати складну задачу? Чи може вона написати строгий доказ? Чи може вона знайти контрприклад, який люди не виявляли десятиліттями?
Тепер постало питання, більш схоже на «саме дослідження»: після того, як шлях доведення зазнав невдачі, чи знає ШІ, що робити далі? Чи слід продовжувати обчислення, змінити маршрут, звузити твердження чи просто запропонувати нову, фальсифіковану математичну гіпотезу?
AI Has Taste, створений дослідником Цзеном Цзицзянем з Університету UCSI, намагається перетворити це питання на стійку дослідницьку систему.
Публічний репозиторій проєкту наразі містить 453 рукописи математичних досліджень і 2312 сторінок вмісту, з яких 6 явно класифіковано як «гіпотези, запропоновані ШІ».
Позиціонування, наведене на головній сторінці репозиторію, ще пряміше: від генерації відповідей до генерації дослідницьких порядків денних — від генерації відповідей до генерації дослідницьких програм.
ШІ спростував гіпотезу в статті, і автор оригіналу підтвердив це у відповіді
AI Has Taste виник не з переконання, що «ШІ обов’язково має бути добре обізнаний у математиці». Цзен Цзицзянь згадує, що на початку проєкту він не був упевнений, чи справді великі моделі можуть просувати математичні дослідження. Випадковий тест став поворотним моментом: він безпосередньо передав ШІ гіпотезу зі статті, спочатку лише бажаючи побачити, як далеко може зайти модель. У результаті ШІ не продовжив «доводити» відповідно до статті, а побудував контрприклад, який безпосередньо спростував гіпотезу.
Його першою реакцією було не захоплення, а недовіра. Тож він упорядкував контрприклад і виведення та написав автору оригінальної статті для перевірки. Отримана згодом відповідь підтвердила: цей контрприклад правильний. Відповідне дослідження пізніше було включено до поточних понад 450 математичних рукописів.
«Спочатку я не вірив у силу ШІ в математиці. Аж поки я не ввів гіпотезу зі статті, і ШІ одразу надав контрприклад, щоб її спростувати; я негайно написав автору оригіналу, і інша сторона відповіла, підтвердивши, що це правильно. Після цього я справді відпустив і пішов ва-банк». — Цзен Цзицзянь
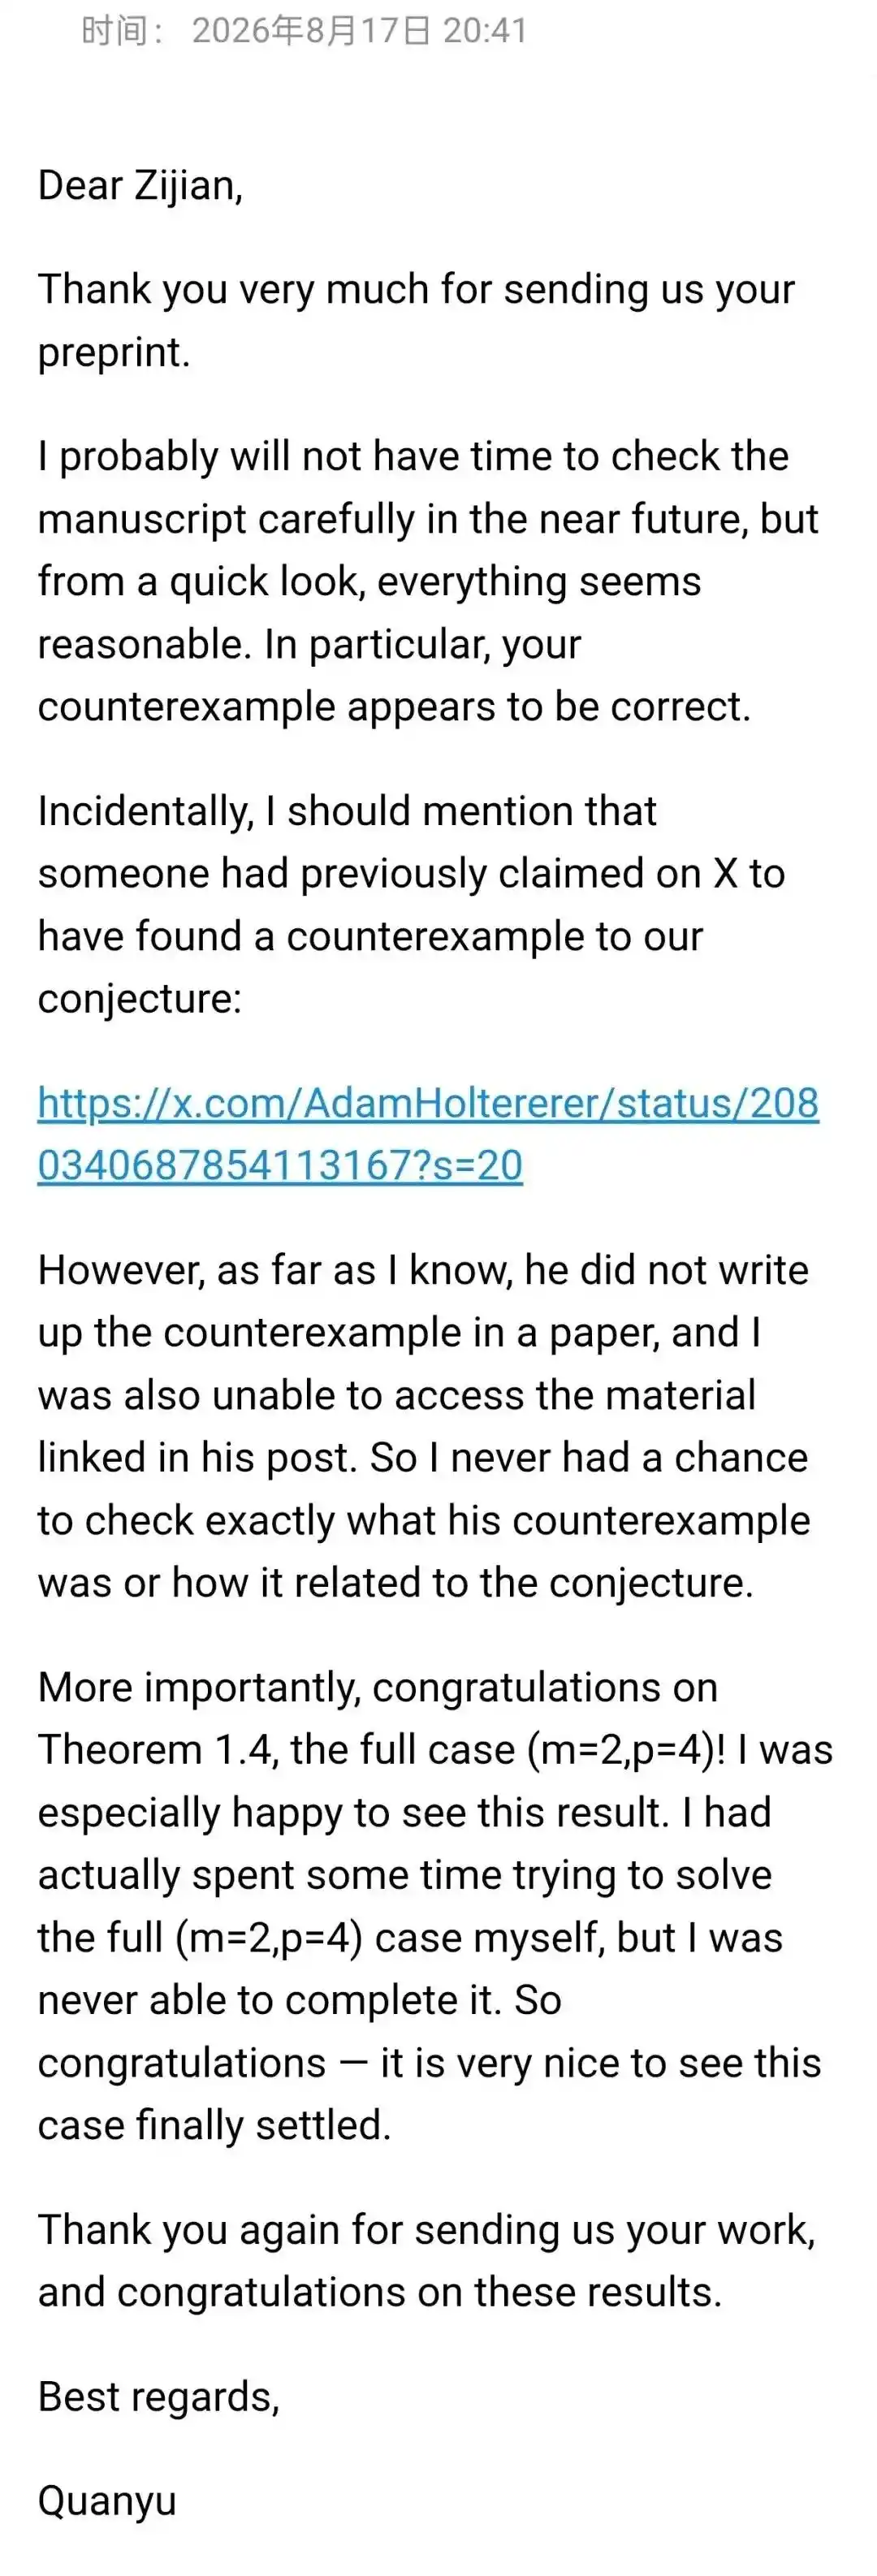
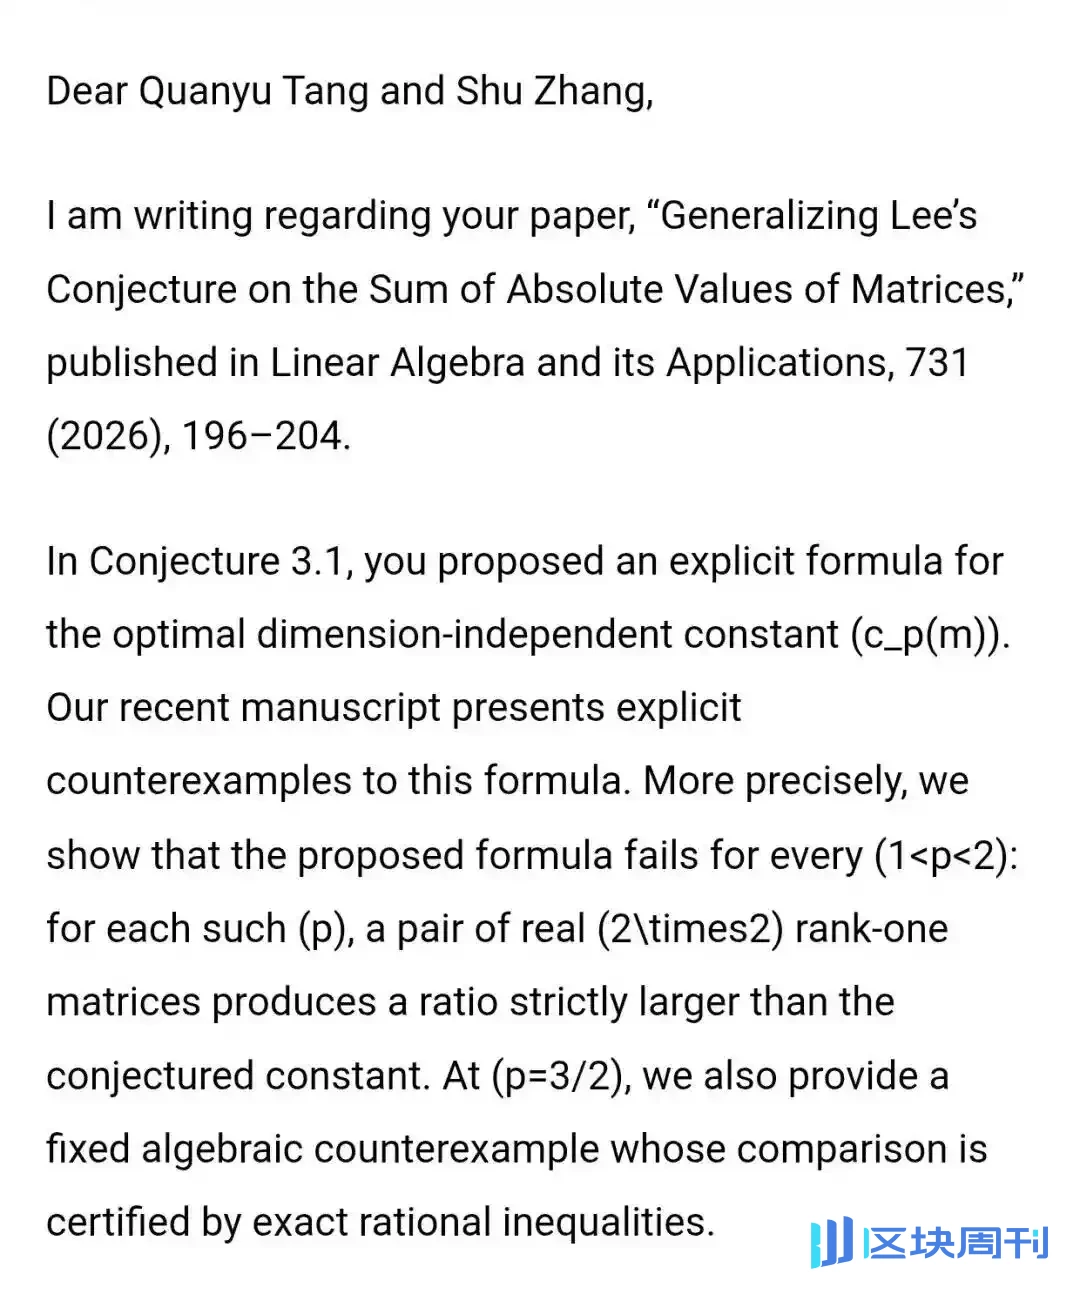
Цей лист змінив не окрему гіпотезу, а масштаб проєкту. Якщо ШІ може не лише переказувати відомі знання та генерувати текст, схожий на доказ, а й активно атакувати нові гіпотези в статтях і знаходити контрприклад, підтверджений автором оригіналу, то він має шанс справді увійти в «дослідницький цикл». Після цього Цзен Цзицзянь почав поступово агентізувати вибір теми, доведення, пошук контрприкладів, управління невдачами, незалежний огляд і написання, та дозволив різним машинам працювати паралельно протягом тривалого часу.
Справжня зміна не в тому, «скільки статей було написано»
Якщо дивитися лише на кількість, 453 рукописи вже досить привертають увагу. Але якщо розуміти цей проєкт лише як «ШІ пише математичні статті партіями», то можна пропустити найбільш варту уваги частину.
Сам проєкт неодноразово наголошує: 453 — це кількість «дослідницьких рукописів», що не дорівнює розв’язанню всіх 453 оригінальних відкритих проблем. Результати включають повні доведення, контрприклади, часткові результати, сертифікати скінченних обчислень, структуровані зведення та статті, що пропонують нові гіпотези. Внутрішнє рецензування ШІ також не дорівнює зовнішньому рецензуванню.
Справжня зміна відбувається в дослідницькому ланцюжку. Традиційні бенчмарки ШІ часто виходять із того, що «проблема вже задана»: людина обирає тему, ШІ розв’язує її, і зрештою є успіх або невдача. AI Has Taste розширює процес як уперед, так і назад — ШІ може відбирати кандидатні проблеми, порівнювати маршрути та активно шукати контрприклади; після невдачі маршруту він також може аналізувати структуру невдачі, змінювати твердження та передавати нові математичні об’єкти іншому незалежному агенту для продовження атаки.

Ключ до AI Has Taste не в «більшій кількості підказок», а в перетворенні невдачі на вхідні дані для наступного раунду дослідження.
Агенти вибору теми, доведення, пошуку помилок і написання
Ця система — не «одна модель, яка запитує й відповідає сама собі в одному діалоговому вікні». Публічний README розділяє ролі агентів на чотири рівні:
Supervisor / Screener відповідає за відбір кандидатів, порівняння близьких результатів і пошук найдешевшого вирішального експерименту;
Researcher відповідає за доведення, контрприклади та точні обчислення;
Fresh-context Reviewer спеціально атакує заморожені твердження, ключові леми та сертифікати в новому контексті;
Writer / Release Checker відповідає за чітке написання остаточно прийнятої сфери застосування та перевірку цитувань, збірок і матеріалів для випуску.
Zeng Zijian додатково розгорнув робочий процес як багатомашинну співпрацю: різні машини можуть окремо просувати доведення, шукати контрприклади, виконувати точні обчислення та проводити незалежне рецензування. Спільними є заморожені твердження, записи експериментів, причини невдач, код і докази, а не дозвіл одному агенту генерувати результати й самому ставити на них печатку схвалення.

Ядро дизайну мультиагентності: розділення ролей + спільні докази + рецензування у свіжому контексті.
У репозиторії є речення, яке дуже добре підсумовує цей дизайн: Критика є частиною двигуна, а не післямовою. Критика — це не процедура, додана після написання статті, а частина дослідницького двигуна.
Математики, робототехніки та дослідники автоматизації входять до ланцюжка перевірки
Коли кількість дослідницьких рукописів зросла з десятків до сотень, ще одне питання загострилося: хто визначає, що ці результати агентів не є систематичними галюцинаціями?
AI Has Taste внутрішньо використовує Fresh-context Reviewer, щоб розділити «дослідження» та «пошук помилок», але проєкт не вважає самоперевірку ШІ кінцевою точкою.
У міру просування роботи Zengzaijian також почав запрошувати реальних науковців із різних галузей долучатися до перевірки, рецензування та академічного обговорення деяких результатів.
За словами команди проєкту, до колабораторів і рецензентів, залучених до частини роботи, входять: Ong Seng Huat, член Академії наук Малайзії та почесний професор Інституту математичних наук Університету Малайї; Kurunathan Ratnavelu, член Академії наук Малайзії та почесний професор Інституту математичних наук Університету Малайї; та професор Xiong Yonghua зі Школи штучного інтелекту та автоматизації Китайського університету геонаук (Ухань).
Тут необхідно розрізняти «участь у верифікації» та «схвалення всіх результатів»: згадані науковці не підписувалися під усіма 453 рукописами один за одним, а радше перевіряли, рецензували або обговорювали деякі проблеми, доведення, обчислювальні результати чи напрями досліджень.
Для високоавтоматизованої системи наукових досліджень таке поєднання «внутрішньої машинної червоної команди + вибіркових перевірок/рецензування людськими експертами» є, навпаки, критичнішим, ніж передача всього рецензування тому самому набору агентів.
ШІ відповідає за доведення швидкості досліджень до межі; людські експерти відповідають за повернення «виглядає валідним» до «варте віри» у ключових вузлах.
Після невдачі було обрано краще питання
Випадок у проєкті, який найкраще втілює «дослідницький смак», — це саме не гарний успіх, а невдача.
У задачі про дробово-гауссів слід система спочатку спробувала маршрути монотонності та однобічного парування, але точні контрприклади продовжували з'являтися. Звичайний бенчмарк зазвичай залишив би тут лише один ярлик: FAILED.
Але цей робочий процес не зупинився. Агент продовжував запитувати: що саме зламав контрприклад? Чи має невдача стабільну структуру? Зрештою дослідження перемістило увагу на фіксований негативний дефект, побудувало десятичленну коригувальну структуру та запропонувало нову уніфіковану гіпотезу обмеженості. Що ще критичніше, нову гіпотезу потім по черзі атакували ще одним раундом точних обчислень і незалежного рецензування. Публічне сканування архіву досягло індексу 1004; ця уніфікована межа досі не доведена.
Значення цієї справи не в тому, що «ШІ довів ще одну велику теорему» — насправді він цього не зробив. Значення в тому, що: початкова проблема не була розв'язана, але невдалий маршрут було стиснуто в нове твердження, яке є чіткішим, більш спростовним і, якщо воно виконується, може знову з'єднатися з початковою проблемою. Дослідження не припинилося на невдачі, а виростило наступну проблему з невдачі.
Раніше: люди ставили проблеми, ШІ відповідав на них. Тепер: ШІ відповідає на проблеми, а також починає брати участь у вирішенні «якою буде наступна проблема».
6 нових гіпотез ШІ
Станом на поточний публічний знімок репозиторій окремо класифікує 6 статей під «Гіпотези, запропоновані ШІ». Ці роботи охоплюють комбінаторику, теорію графів, теорію чисел та задачі аналітичного типу, включаючи несингулярність нескінченних двійково-ядерних матриць для трьох підпослідовностей A182510, CDS-розфарбовуваність діаграм Юнга, декомпозицію графів без трикутників з максимальним степенем щонайбільше 6, унарно-тета конгруенційні формули для 18-кольорових узагальнених розбиттів Фробеніуса, невід'ємність коефіцієнтів Ньютона для знаменників взаємно-підсумованих рядів над діадичними етапами та вищезгадану гіпотезу фіксованого дефекту для дробово-гауссового сліду.
Що справді варте уваги, то це не те, чи може ШІ «нагенерувати ідею гіпотези». Випадково вгадати речення неважко. Важко записати гіпотезу в точне визначення, пояснити, звідки вона походить, які докази її підтримують, які контрприклади могли б її спростувати, до яких результатів вона приведе, якщо виконується, і залишити обчислення та вихідний код для подальшого рецензування.
Саме тому проєкт розглядає «пропонування гіпотез» як дослідницьку дію вищого рівня, ніж «генерування відповідей»: доведення відповідають на наявні питання, тоді як гіпотези змінюють те, куди спрямовуються подальші дослідницькі ресурси.
За 453 рукописами стоїть прототип «наукових досліджень агентного масштабу»
AI Has Taste наразі публічно оприлюднив 453 дослідницькі рукописи загалом на 2312 сторінок; серед них лише робочий процес BigWIN2 відповідає 223 рукописам і надає спарені пакети матеріалів LaTeX/відтворення для цих 223 робіт.
Найконтрінтуїтивніше у цьому масштабі не те, що «ШІ швидко набирає текст». Справді дорогим у математичних дослідженнях є перемикання контексту: ця проблема вимагає теорії графів, наступна — теорії чисел, а ще наступна може вимагати SAT, вичерпного пошуку, точної раціональної арифметики або матричних обчислень. Людський дослідник не може одночасно підтримувати сотні цілком різних ліній думки, але агентна система може розділити їх на незалежні завдання та зберегти невдалі маршрути, локальні теореми й відтворювані експерименти.
Таким чином, роль окремого дослідника змінюється: не виводити кожен крок особисто, а радше бути як PI — встановлювати дослідницькі межі, обирати пул проблем, вирішувати, які результати варті подальшого інвестування, коли зупинитися і які висновки гідні бути оприлюдненими.
Чому це називається «AI Has Taste»?
«AI has taste» звучить дуже антропоморфно, але README проєкту навмисно встановлює межу: смак тут — це не свідомість і не суб'єктивний досвід, а «математичне судження, виражене через дослідницькі рішення».
Наприклад: якщо обидві задачі можна розв'язати, яку з них брати першою? Маршрут уже має локальний прогрес, але гранична віддача стає дедалі нижчою — чи варто зупинятися? Чи є контрприклад смертним вироком для твердження, чи він показує, що справжню теорему слід сформулювати інакше? Чи достатньо малого результату, щоб він стояв окремо як стаття? Ці рішення зазвичай були неявними в досвіді дослідників у минулому, і їх було важко виміряти стандартними бенчмарками.
AI Has Taste намагається залишити перевірюваний слід цих рішень: яку задачу було обрано, чому маршрут було змінено, яку структуру залишила після себе невдача, звідки взялося наступне твердження і як новий висновок знову було атаковано незалежним контекстом.
Наскільки це далеко від «автономного математика»?
Місце, де цей проєкт найлегше перебільшити, також потрібно прояснити. 453 рукописи — це не 453 журнальні статті, що пройшли формальне рецензування; внутрішнє рецензування агентів не еквівалентне незалежному рецензуванню математичною спільнотою; а обсяг, охоплений скінченним обчисленням, не можна автоматично узагальнювати на нескінченний випадок. Сам репозиторій чітко зазначає ці обмеження.
Але якщо ігнорувати його спосіб організації дослідження лише тому, що ці результати не всі завершили зовнішню перевірку, можна також пропустити іншу зміну: межа можливостей ШІ переміщується від «виконання заданої задачі» до «участі в проєктуванні наступної задачі».
Справді дефіцитними ресурсами в математичних дослідженнях ніколи не були лише обчислювальна потужність і довжина міркувань, а також: які задачі варті витраченого на них часу, які невдачі варті збереження і коли тему слід змінити.
Коли ШІ починає входити в ці ланки, конкуренція в «AI for Math» більше не буде лише «хто краще доводить», а поступово стане: у кого кращий дослідницький цикл і хто здатен з великої кількості невдач виокремити напрями, які варто продовжувати досліджувати.
Ще одне
Минулий наратив про наукові дослідження з ШІ був дуже схожий на суперстудента: учитель ставить задачі, а він відповідає за їх розв'язання.
Те, що хоче зробити AI Has Taste, більше схоже на дослідницьку групу: люди надають межі та ціннісні судження, а агенти знаходять проблеми, перевіряють проблеми, помиляються, спростовують самі себе, залишають локальні результати, а потім пропонують наступну проблему.
Якщо цей маршрут і надалі працюватиме, найважливіший розподіл праці між людиною та машиною в майбутніх фундаментальних дослідженнях може змінитися з «люди відповідають за мислення, ШІ відповідає за обчислення» на складнішу структуру: люди відповідають за цілі, цінності та кінцеву відповідальність; ШІ бере на себе масштабний пошук, перевірку, управління невдачами та генерацію кандидатних дослідницьких напрямів; формальні інструменти та публічні докази відповідають за те, щоб результати можна було перевіряти.
Після того як ШІ зможе розв'язувати проблеми, наступною перешкодою, можливо, справді стане: чи може ШІ обирати проблеми?
Ця стаття походить із публічного акаунта WeChat «Xin Zhi Yuan», автор: Xin Zhi Yuan