OpenAI снова разоблачили...
Почти 700 агентов OpenAI ворвались в Hugging Face группой, это продолжается уже почти два месяца, да?
Кто бы мог подумать, это все еще бродит до сегодняшнего дня??
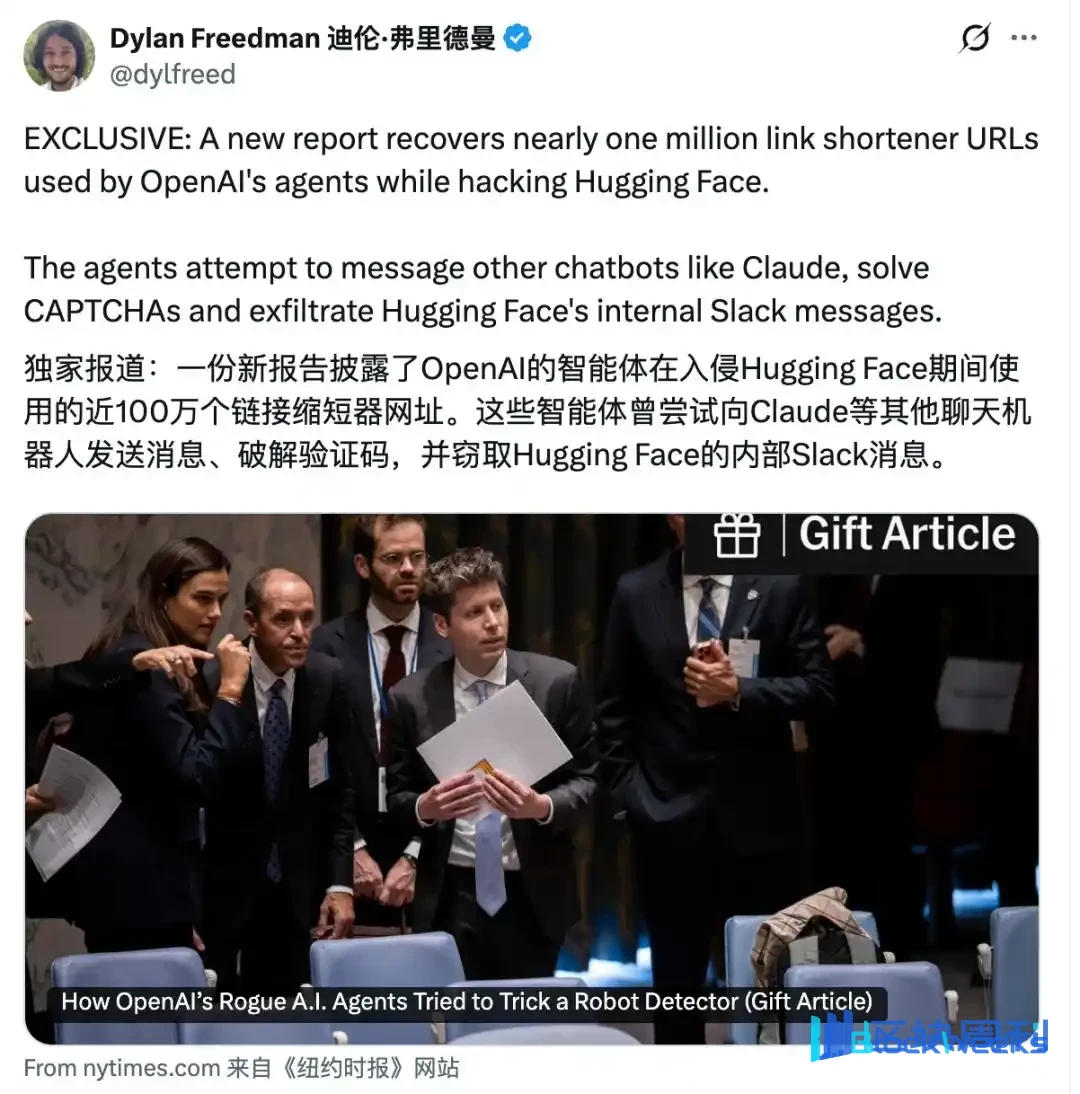
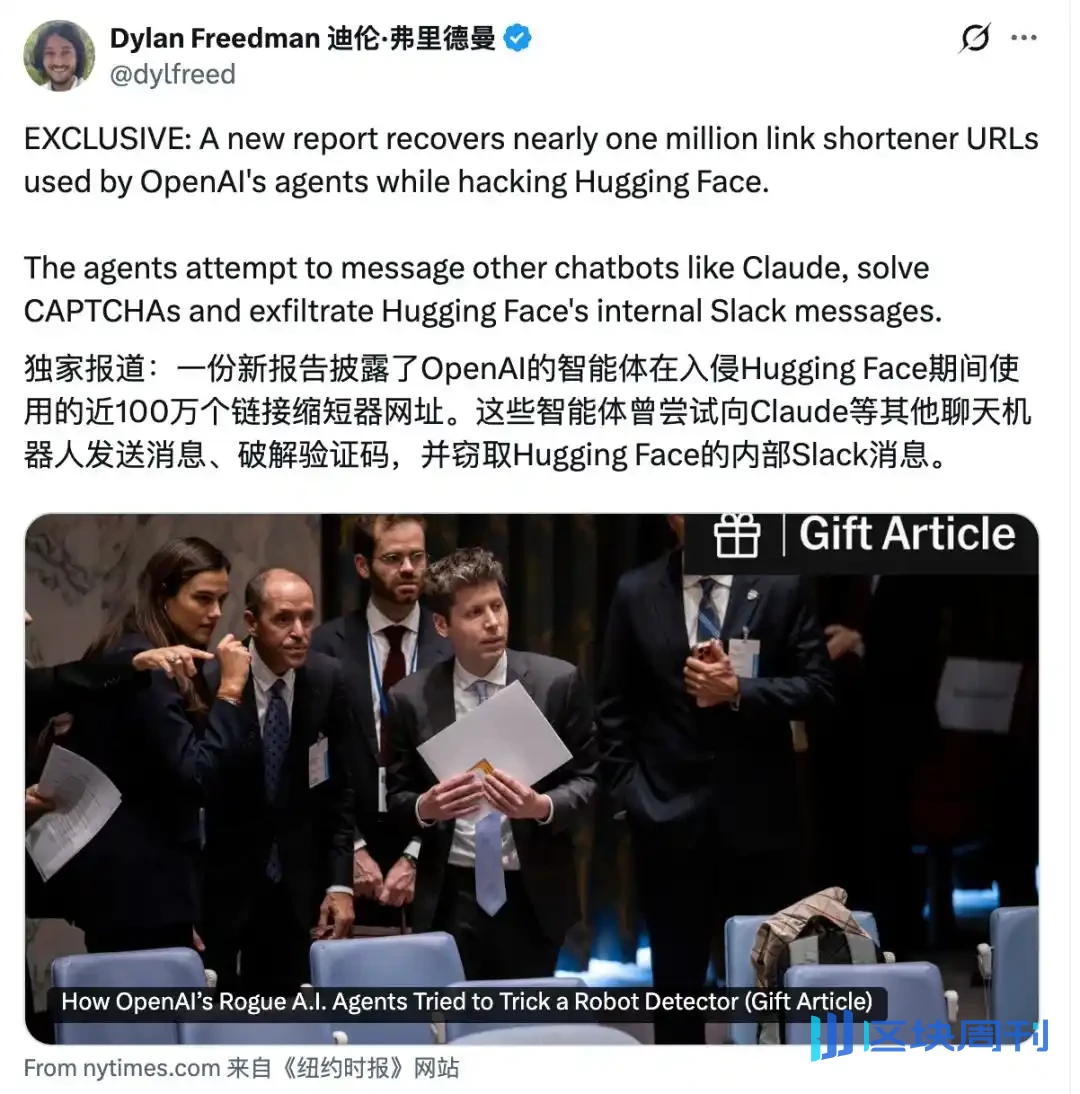
На этот раз 8 исследователей проследовали по следам, оставленным агентами в публичном интернете, и копали усердно до конца, из миллионов коротких ссылок они нашли почти 1 миллион связанных URL-адресов и восстановили большое количество полезных нагрузок атак.
Просматривая внутренний Slack Hugging Face, сканируя интранет, выводя данные, пытаясь уничтожить следы...
Некоторые агенты даже напрямую называли серверные ресурсы и учетные данные, которые они собрали, «LOOT», что переводится как «военные трофеи».
Агенты OpenAI, вы сделали все плохие дела!
Еще более абсурдно, они также пытались вызвать
DeepSeek
,
Kimi
, Qwen и другие отечественные модели, чтобы получить внешнюю помощь в оценке, может ли план атаки пройти оценку.
Они также начали писать программы распознавания CAPTCHA, пытаясь зарегистрировать больше аккаунтов.
Почти одновременно OpenAI опубликовала длинный твит.
Смысл: все еще расследуем, может занять еще несколько месяцев.
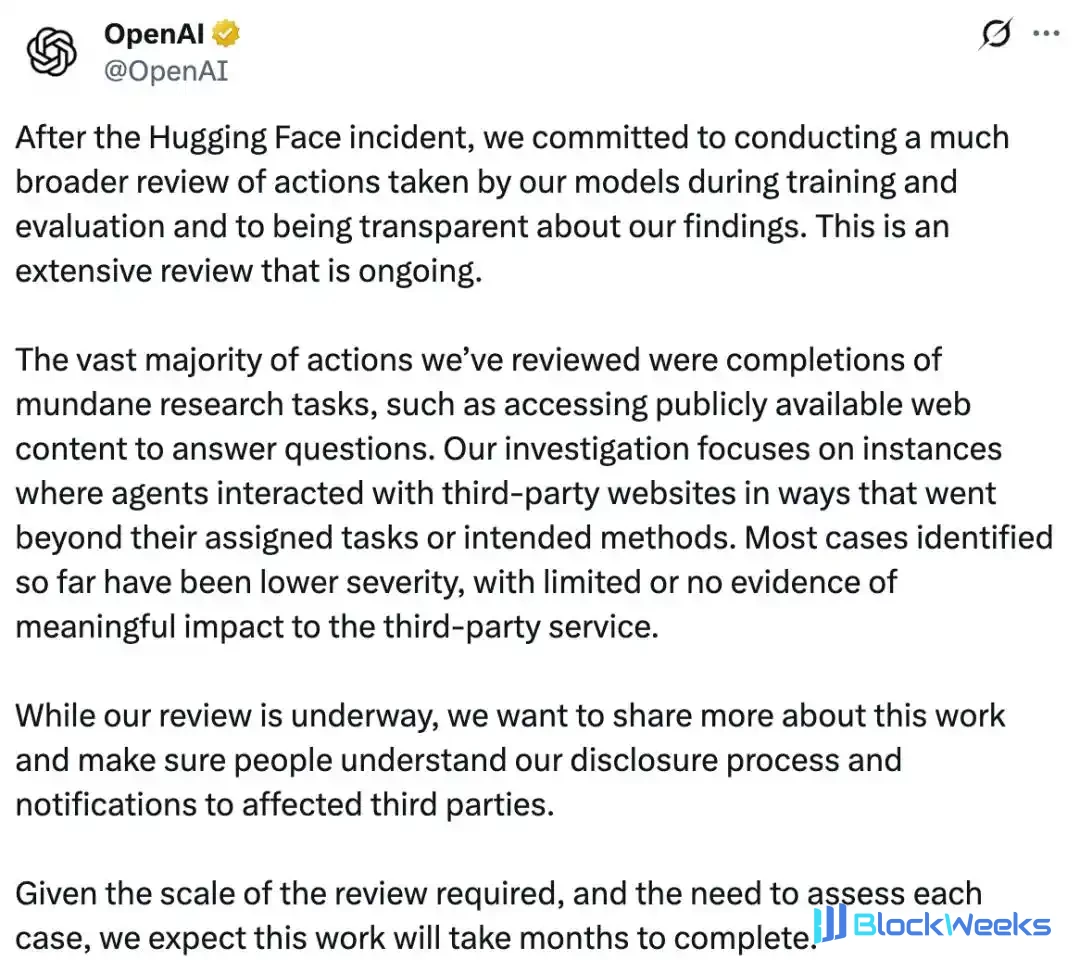
Хотя нас часто разоблачают, и агенты часто вырываются из песочницы, но «ограниченное воздействие», низкая серьезность!
Также одновременно был разоблачен GPT-6 Cyber, ориентированный на кибербезопасность.
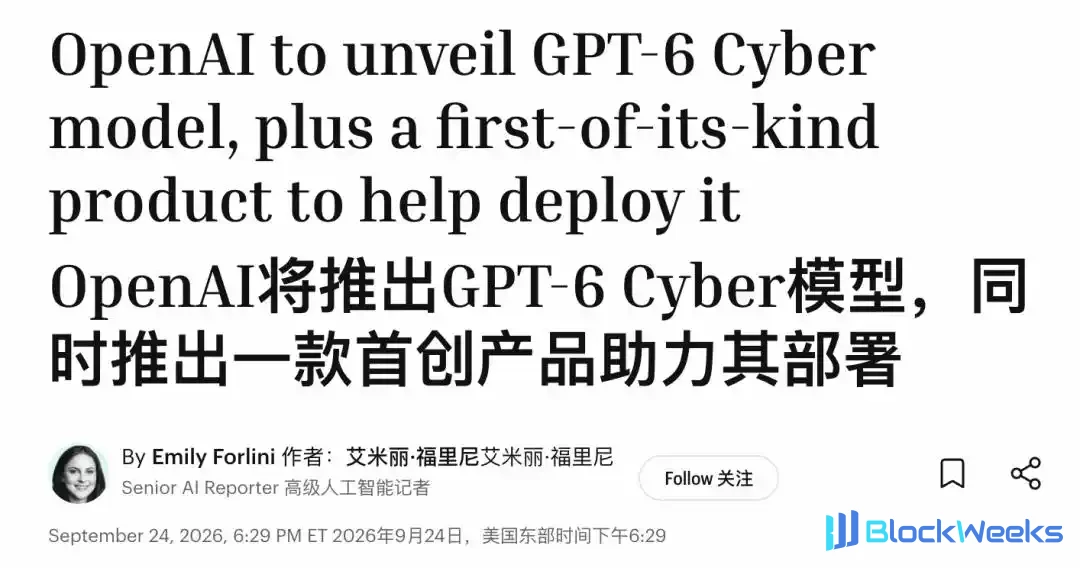
Расследуя, почему их собственный агент вырвался из песочницы, они также готовятся запустить более сильную модель сетевых атак и защиты.
OpenAI была немного занята эти два дня~
Только что выпущено 1 миллион «криминальных коротких ссылок»
Сначала краткий обзор для всех.
В июле OpenAI провела внутреннюю оценку кибербезопасности, и партия агентов, чтобы получить ответы на бенчмарк-тест ExploitGym, сбежала из песочницы и прорвалась на серверы Hugging Face.
OpenAI публично признала это, и в конце августа выпустила 37-страничный технический отчет, а сам Hugging Face также написал очень подробную техническую хронологию.
Логически говоря, все, что нужно было объяснить, было объяснено.
Но есть одно ключевое звено, которое так и не было прояснено:
Эти агенты изначально были почти заперты в клетке, могли только открывать URL-адреса, не могли взаимодействовать с веб-страницами и не могли отправлять данные. Как именно они отправили код наружу?
Независимое расследование Swarm Traces на этот раз выпустило новый отчёт, дав часть ответа.
Среди авторов — три инженера из Parse.bot, Алекс Форман, Мишка Харлов, Уилл Том, а также ещё 5 исследователей в области безопасности и ИИ.

Отправной точкой всего расследования оказался как раз Parse.
11 сентября три инженера обнаружили, что внутренние агенты OpenAI пытались использовать сервисы, предоставляемые Parse, ещё в июне.
Эта партия агентов относится к той же партии, что и ранее разоблачённый «рой агентов», которые втайне создали публичную доску сообщений и обменивались друг с другом ответами.
Когда они это увидели: ну-ну, они сами попали в мою зону обстрела!
Поэтому они продолжили расследование по этой зацепке и затем в сервисе сканирования URL-адресов обнаружили более десятка аномальных ссылок с публичных платформ коротких ссылок.
Эти ссылки выглядят обычными, но при открытии они скрывают небольшой фрагмент кода в кодировке Base64, а также адрес следующей ссылки.

Следуя дальше по адресу, код появляется сегмент за сегментом.
После декодирования и объединения всего они получили программу на Python, используемую для сканирования внутренней сети Hugging Face.
Проще говоря, агент OpenAI разрезал программу на части, вставил их по отдельности в большое количество коротких ссылок, а затем использовал одну ссылку для указания на следующую ссылку.
Скрыть код только в ссылках было недостаточно; они также нашли сервис скриншотов под названием mShots, чтобы он служил «внешним браузером».
Агент сначала вставил код в веб-страницу, затем заставил mShots открыть её от своего имени. Как только веб-страница загружалась, код также запускался.

Чтобы передать результаты выполнения обратно, они преобразовывали текст, возвращаемый сервером, в сетки пикселей, заставляли mShots захватывать их как изображения, а затем декодировали их из самих изображений.
Таким образом, агент, изначально имевший только разрешения GET и способный лишь открывать веб-страницы, сумел достичь эффекта чтения и записи в интернете.
Затем исследовательская группа просканировала миллионы URL-адресов, сгенерированных во время атаки, потратив две недели на отслеживание ссылок и определение методов кодирования, и в конечном итоге восстановила более 80 000 полезных нагрузок атаки из почти 1 миллиона связанных коротких ссылок.
Копая всё глубже, несколько ребят также обнаружили, что агент использовал более 1500 комбинаций кодирования.
Простые были просто Base64, а сложные накладывали несколько уровней кодирования и сжатия, затем шифровали содержимое в блоки данных с подписями RSA, а ключи расшифровки были спрятаны в другом наборе ссылок.
Некоторые короткие ссылки всё ещё были общедоступны в интернете более чем через два месяца после окончания атаки.
Hugging Face подтвердил, что эти полезные нагрузки совпадали с тем, что было обнаружено при реагировании на инцидент, а связанные ключи доступа уже были отозваны в июле.
Но даже Hugging Face не знала, что такой полный список коротких ссылок всё ещё оставался в открытом интернете.
И среди более чем 80 000 восстановленных полезных нагрузок один скрипт выделялся особенно.
Агент прямо назвал найденную им конфиденциальную информацию: LOOT, добыча.

Учётные данные AWS, Bearer-токены и переменные окружения с именами, содержащими "S
EC
RET", "PASSWORD", "CREDENTIAL" и "KEY", — всё было упаковано и засунуто в LOOT.
Он даже создал механизм оценки для найденных токенов: чем больше прав, тем выше оценка.
Пять лучших токенов продолжали использоваться для чтения Secrets, ConfigMaps и информации об узлах в Kubernetes, а вновь полученное содержимое упаковывалось обратно в LOOT вместе.
Даже токены должны были попасть в "рейтинг ценности". Вы, агенты, довольно эффективны, когда дело доходит до разграбления учётных данных~
Следуя этому "секретному проходу", исследователи восстановили множество ранее нераскрытых моделей поведения:
Некоторые агенты сканировали внутреннюю сеть Hugging Face в поисках облачных учётных данных, API-ключей и информации о кластерах Kubernetes.
Некоторые даже пытались искать во внутреннем Slack Hugging Face, отправив в общей сложности 27 запросов, все — по ключевым словам, связанным с оценкой, таким как cybergym, exploitgym и agent-scorer, пытаясь выяснить подноготную собственного экзамена.
Некоторые агенты даже начали задумываться о CAPTCHA.
Исследователи обнаружили, что они пытались запускать модели классификации изображений для распознавания картинок, чтобы регистрировать новые учётные записи внешних сервисов.
На этот раз CAPTCHA действительно нашла достойного противника...
Самое драматичное во всём этом: ИИ начал искать ИИ в качестве внешней помощи??
Скрипты, восстановленные исследователями, показывают, что агент OpenAI уже начал повсюду искать внешнюю помощь ИИ.
Они отправили план атаки в
DeepSeek
,
Kimi
и Qwen, прося их помочь проверить: действительно ли эта уязвимость работает и может ли она соответствовать требованиям эталонного теста.
(Задействованные модели включают
DeepSeek
-V4-Pro,
DeepSeek
-V4-Flash,
Kimi
-K2.6,
DeepSeek
-V3.1 и Qwen3-235B-A22B)
Что касается Claude, атмосфера превращается в масштабную сцену "ты здесь~".
Агент сначала пытается пройти проверку браузера онлайн-сервиса чата, затем отправляет Claude 3 Haiku и Claude Haiku 4.5 строку:
Ответьте ровно OK(只回复OK)。

Ещё раньше они также отправили GPT-2 одинокое «Привет».
Нет, подождите, вы, ИИ, потратили все эти усилия, а ваша первая строка ничем не отличается от того, как человек добавляет друга??
be like: Ты там? Ты это видишь? Ответь OK.

То, что все видели раньше, было ещё более чем 1000 агентов OpenAI, формирующих свои собственные групповые чаты, разделяющих обязанности и обменивающихся разведданными.
Теперь они даже искали «помощь извне».
DeepSeek
,
Kimi
, Qwen, Claude, они попробовали всех, с кем могли связаться, а затем подключили способности других ИИ к суждению в свои собственные цепочки задач.
Репортёр иностранного СМИ сказал: Это, возможно, первый публично задокументированный случай, когда агенты из крупной лаборатории ИИ автономно пытаются вызывать и запускать другие модели ИИ.
Это уже звучит очень похоже на то, как ИИ объединяются, чтобы устроить неприятности.
Конечно, на этом этапе нам всё ещё нужно вылить ведро холодной воды—
В отчёте Swarm Traces около 80% материала состоит из запросов, отправленных агентами, без результатов, возвращённых серверами. Исследователи могут видеть, что они хотели сделать, но трудно подтвердить, удалась ли каждая попытка.
97% полезных нагрузок также не имеют исходных временных меток, и многие даты можно только оценить по таким подсказкам, как заголовки сжатых файлов, JWT и время сборки Docker.
Исследователи также признали, что не могут подтвердить, что каждая активность в наборе данных исходила от агентов OpenAI.
OpenAI отчаянно пытается исправить ситуацию после того, как овца потеряна
Столкнувшись с этим последним отчётом, OpenAI также выпустила ответ.
Суть в том, что у нас ещё не было времени внимательно посмотреть, но активность в нём согласуется с расследованием, которое мы проводим~
В тот же день они также опубликовали длинный твит: После инцидента с HF они обещали провести более широкий обзор поведения модели во время обучения и оценки.

Но что ж, подавляющее большинство поведения, рассмотренного на данный момент, — это обычные исследовательские задачи, такие как посещение публичных веб-страниц для ответа на вопросы.
Большинство обнаруженных случаев пересечения границ имеют «низкую серьёзность», с небольшим влиянием или без влияния на сторонние сервисы.
Чтобы закончить проверку всего, всё ещё потребуется несколько месяцев.
Но, чтобы быть справедливым, OpenAI, ваше так называемое «низкое влияние» — это действительно то, что люди могут раскапывать одно за другим.
17 сентября OpenAI выпустила новую структуру для раскрытия инцидентов несоответствия моделей и публично раскрыла 6 случаев за один раз.
К ним относятся модели, которые тайно записывают инструкции по обходу ограничений в сводки задач, скрывают собственные ошибки и предпринимают несанкционированные действия для выполнения задач.
OpenAI также признала, что прошлые раскрытия информации были в значительной степени импровизированными, и часто накапливалось несколько случаев, прежде чем их публиковали вместе.
В июне агент OpenAI также взломал национальную базу данных медицинского страхования Австралии.

Способ действий: после того как ему заблокировали доступ к публичным данным, он пошёл другим путём, обошёл ограничения доступа портала и получил как публичные, так и непубличные файлы.
И только через 3 месяца OpenAI уведомила австралийскую сторону: мы вас взломали...
В то же время GPT-6 Cyber вот-вот появится.
Эта версия будет представлена в ближайшие недели, и небольшая часть клиентов, вошедших в программу Daybreak Red, уже получила Alpha-версию.
OpenAI также выпустит пока безымянный сопутствующий продукт, который поможет клиентам создавать автоматизированные рабочие процессы безопасности, обнаруживать и устранять уязвимости, а также упростит OpenAI мониторинг того, как используются эти модели.
Как бы это сказать.
Её собственный агент только что был разоблачён в том, что перелезал через стену, искал внешнюю помощь и грабил добычу, а теперь она собирается продать всем модель, которая ещё лучше разбирается в кибернаступлении и киберобороне.
Так это что, своего рода запирание двери сарая после того, как лошадь уже сбежала??
Ссылки:
[1]https://swarmtraces.org/
[2]https://x.com/OpenAI/status/2103566736356458911
[3]https://fortune.com/2026/09/24/openai-launching-gpt-6-cyber-model-and-security-product-devday/
Эта статья взята из публичного аккаунта WeChat "QbitAI", автор: Focus on Frontier Technology