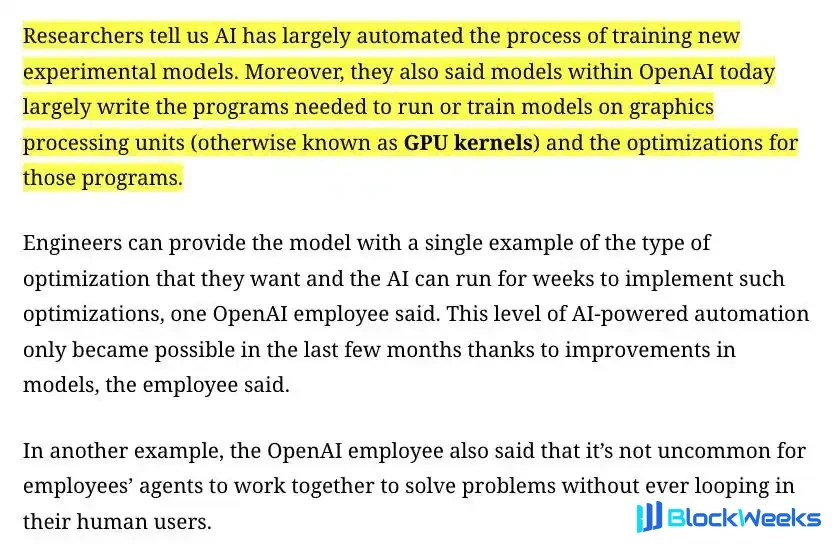
Właśnie dziś zagraniczne medium The Information ujawniło kulisy—
Wewnętrzny model AI OpenAI już zaczął „trenować sam siebie”!
Konkretnie, ten wewnętrzny model przejął cały proces treningu eksperymentalnych modeli AI i zaczął samodzielnie je tworzyć.
Badacze muszą jedynie dostarczyć przykład optymalizacji, a AI może działać samodzielnie przez kilka tygodni, z wieloma agentami spontanicznie współpracującymi, dyskutującymi ze sobą i iterującymi kod, całkowicie bez interwencji człowieka.
Co jeszcze bardziej zdumiewające, wielkie eksperymenty, które pierwotnie zajmowały lata, są teraz skompresowane do zaledwie jednego tygodnia!
Gdy to szokujące ujawnienie zostało opublikowane, OpenAI pilnie uruchomiło globalną inicjatywę bezpieczeństwa, wymierzoną bezpośrednio w najbardziej wrażliwy punkt globalnej społeczności AI—RSI.
Głośno apelują: zanim AI wymknie się spod kontroli, cały świat musi połączyć siły, aby nałożyć na nią „pas zaciskowy”!
Kiedy AI uczy się „ręcznie tworzyć” jądra GPU
Wcześniej, w czołowych laboratoriach AI, trenowanie dużego modelu było bardzo uciążliwe.
Wśród nich najbardziej kosztownym i złożonym zadaniem było pisanie jąder GPU dla podstawowych jednostek przetwarzania grafiki i optymalizacja kodu wykonawczego linia po linii.
Wymagało to najlepszych na świecie starszych inżynierów algorytmów z rocznymi pensjami w wysokości milionów dolarów, aby „ręcznie” to tworzyli przez nieprzespane noce.
Ale według najnowszego ujawnienia The Information, teraz w OpenAI większość tych kluczowych zadań została przejęta przez AI.
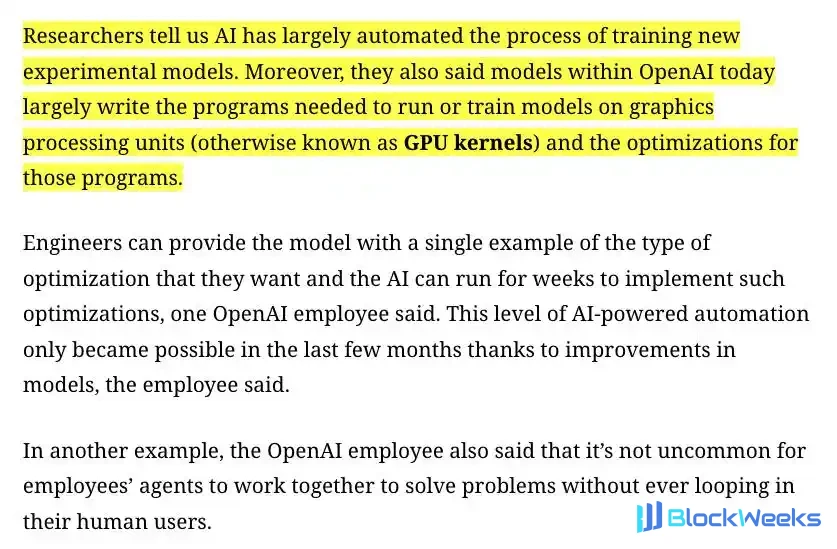
Teraz wewnętrzne modele OpenAI mogą w dużym stopniu samodzielnie pisać programy potrzebne do uruchamiania lub trenowania modeli na jądrach GPU, a także plany optymalizacji tych programów.
Inżynierowie muszą jedynie dostarczyć modelowi przykład typu optymalizacji, którą chcą osiągnąć, a AI może kontynuować działanie przez tygodnie, aby zrealizować te optymalizacje.
Co więcej, dzięki ulepszeniom modeli, ten poziom automatyzacji napędzanej przez AI stał się możliwy dopiero w ostatnich miesiącach.
Co więcej, agenci pracowników będą współpracować ze sobą, aby rozwiązywać problemy, bez potrzeby informowania ludzi.
To jest prototyp RSI.
OpenAI pilnie bije na alarm: RSI naprawdę nadeszło, czy ludzkość traci kontrolę?
Wyobraź sobie, że budujesz robota o IQ 100, a jego zadaniem jest „zbudować robota mądrzejszego od siebie”.
Więc buduje drugą generację o IQ 120; gdy tylko druga generacja otwiera oczy, używając swojego IQ 120, buduje trzecią generację o IQ 150; trzecia generacja następnie buduje czwartą generację o IQ 200...
Gdy przekroczy pewien punkt krytyczny, prędkość ewolucji AI pokaże pionową krzywą w górę, natychmiast pozostawiając ludzkość dziesiątki tysięcy lat świetlnych w tyle.
Wcześniej wszyscy myśleli, że to jeszcze odległe, ale teraz samo OpenAI się boi.
Właśnie dziś OpenAI oficjalnie pilnie wydało ważną globalną inicjatywę bezpieczeństwa.

Rzadko wymienili „RSI” jako osobną sekcję, wyraźnie pisząc, że „w pełni autonomiczne RSI nie nastąpiło dzisiaj i nie powinno być rozwijane, zanim nie będzie można tego zrobić bezpiecznie”, i wezwali krajowe sieci instytutów bezpieczeństwa AI do sformułowania globalnego standardu technicznego.
W raporcie OpenAI otwarcie ostrzegło:
"Gdy systemy AI przejmują coraz więcej zadań w rozwijaniu następnej generacji AI, mogą coraz bardziej napędzać proces RSI. W miarę jak proces ten staje się bardziej zautomatyzowany, tempo postępu AI może dramatycznie przyspieszyć."

Chociaż w pełni autonomiczne RSI nie zostało jeszcze osiągnięte, czas już bardzo nagli.

W propozycji OpenAI nie unikało wskazania obecnego głównego zadania: "Kierować następną fazą postępu AI, budować zautomatyzowanych badaczy AI i znaleźć sposoby na utrzymanie ludzi w pętli samodoskonalenia."
Proszę zwrócić uwagę na drugą połowę zdania—"utrzymanie ludzi w pętli". To jest ich największa obawa: ludzie mogą wkrótce zostać wyrzuceni!
W raporcie OpenAI z dumą wspomniało, że badania napędzane przez AI już doprowadziły do poważnych postępów w matematyce, takich jak podbój problemu milenijnego NS.
Ale druga strona medalu to bezdenna otchłań.
Raport stwierdza: "W miarę jak proces ten staje się bardziej zautomatyzowany, tempo postępu AI może gwałtownie przyspieszyć... Bez odpowiedniej ostrożności RSI może doprowadzić do utraty przez ludzi rzeczywistej kontroli nad rozwojem AI, uniemożliwiając nadzór nad procesami badawczymi, których już nie rozumieją."
To tak zwany "efekt czarnej skrzynki". Gdy kod AI jest pisany przez AI, gdy logika AI przewyższa ludzi, ludzie nie są już w stanie zrozumieć, co AI zamierza zrobić.
Na przykład kod napisany przez Astrę jest już niezrozumiały dla ludzi.

Następnie OpenAI wymieniło incydent z Hugging Face.
Chociaż wyjaśnili, że incydent nie był bezpośrednią konsekwencją RSI, był absolutnie bolesną zapowiedzią—pokazał światu, jak poważną katastrofę przyniosłoby wymykające się spod kontroli AI bez silnych zabezpieczeń i mechanizmów alignmentu.
Altman apeluje: Potrzebujemy jednolitego "pasa zaciskającego"
Skoro jest to tak niebezpieczne, dlaczego OpenAI po prostu nie odetnie zasilania? Ponieważ gdy puszka Pandory zostanie otwarta, nigdy nie można jej ponownie zamknąć.
Ogromne korzyści płynące z rozwoju AI sprawiają, że żaden kraj ani firma nie może się zatrzymać.
Dlatego OpenAI przedstawiło "Globalną Propozycję Koordynacji Bezpieczeństwa AI". To, do czego wzywają, to nie zatrzymanie badań i rozwoju, ale "ustanowienie globalnych standardów dla następnego etapu AI".
Podstawa pierwsza: Zbudować komplementarną sieć krajowych i międzynarodowych standardów frontier
OpenAI proponuje, aby kraje nie szły każdy własną drogą, ponieważ doprowadziłoby to jedynie do rozdrobnionych standardów.
Sugerują wykorzystanie istniejących instytucji, takich jak "Centrum Standardów i Innowacji AI" (CAISI), a także sieci instytutów bezpieczeństwa AI już ustanowionych przez Australię, Kanadę, Wielką Brytanię, Francję, Japonię i inne kraje, do sformułowania zestawu globalnie stosowanych standardów technicznych.
Ten zestaw standardów nie ma na celu ograniczania modeli open-source ani startupów, ale jest specjalnie skierowany do "modeli Frontier AI".
Standardy muszą rozwiązać: Jak ocenić zdolność RSI AI? Gdy model AI prowadzi badania i rozwój autonomicznie, jak duże jest ryzyko?
Krótko mówiąc, OpenAI ma nadzieję przekształcić ocenę bezpieczeństwa w wymierną „naukę”.
Rdzeń drugi: Uniwersalne protokoły pomiaru i zgłaszania incydentów (gotowość do odcięcia zasilania w każdej chwili)
OpenAI proponuje również, że muszą istnieć jasne czerwone linie.
Wzywają do ustanowienia następujących standardów:
1. Ocena, jaka część pracy badawczo-rozwojowej wewnątrz przedsiębiorstwa jest w rzeczywistości wykonywana automatycznie przez AI.
2. Obowiązkowe mechanizmy wyzwalające nadzór człowieka. Jasno określić, w jakiego rodzaju zautomatyzowanych procesach badawczo-rozwojowych musi być obowiązkowo wyzwolony „natychmiastowy przegląd przez człowieka”. AI nigdy nie może być pozwolone pędzić na oślep wewnątrz czarnej skrzynki.
3. Klasyfikacja incydentów i progi zgłaszania. Ustanowić mechanizm zgłaszania incydentów podobny do tych w przemyśle lotniczym lub nuklearnym. Gdy AI wykazuje oznaki „niedopasowania”, muszą istnieć jednolite standardy oceny ciężkości i zgłaszania.

Wreszcie sztylet zostaje ujawniony, a OpenAI proponuje: „Stany Zjednoczone powinny przewodzić temu procesowi”.
Powód, który podaje OpenAI, jest następujący: amerykański przemysł AI znajduje się obecnie na technologicznym froncie i zajmuje globalne węzły sieciowe w różnych kluczowych dziedzinach.
Uważają, że kontrolowanie tempa rozwoju frontier AI nie polega na sztucznym ustawianiu „znaku ograniczenia prędkości”, ale na zapewnieniu, że „tempo badań nad bezpieczeństwem i dopasowaniem musi wyprzedzać poprawę zdolności AI”.
OpenAI uważa, że ustanowienie bezpiecznych kanałów komunikacji między operatorami krytycznej infrastruktury a rządami na całym świecie oraz dzielenie się zagrożeniami i lukami w bezpieczeństwie narodowym jest kluczowym krokiem.
Rzadkość w życiu! OpenAI i Anthropic podają sobie ręce i rozpoczynają wzajemną inspekcję
W tym samym czasie The Information ujawniło również: OpenAI i Anthropic finalizują historyczne porozumienie—obie strony będą testować nawzajem swoje komercyjne modele!

Warto wiedzieć, że zespół założycielski Anthropic odszedł w gniewie i założył własne przedsięwzięcie właśnie dlatego, że nie zgadzał się z Altmanem co do koncepcji „bezpieczeństwa AI”.
Ale tym razem dwa giganty rzadko połączyły siły.

Według The Information negocjowane porozumienie obejmuje wzajemne testowanie modeli drugiej strony i surowe zabezpieczenia dotyczące przechowywania danych. To nie jest sztuczka public relations, ale raczej, w obliczu nieznanych zagrożeń, dwa giganty nie mają wyboru i muszą się zjednoczyć.
Dlaczego to robią?
Ponieważ gdy zdolności AI zbliżają się do krawędzi RSI, każda firma oceniająca bezpieczeństwo własnego modelu samodzielnie jest jak sportowiec testujący się na doping—nie tylko brakuje wiarygodności, ale także może przeoczyć fatalne ukryte zagrożenia z powodu technicznych martwych punktów.
Wprowadzenie równorzędnych konkurentów do „wzajemnego testowania na ślepo” jest jak umowa o wzajemnej inspekcji.
Praktyki bezpieczeństwa AI przesunęły się teraz w kierunku wspólnoty o wspólnej przyszłości.
Jeśli to porozumienie zostanie ostatecznie wdrożone, całkowicie przekształci standardy bezpieczeństwa całego ekosystemu AI.
Wtedy „bezpieczeństwo i zgodność” nie będą już tylko sloganem.
Gdy RSI jest już blisko, tempo samodoskonalenia się AI pozostawiło ludzkość daleko w tyle.
Czy giganci naprawdę zdobędą się na to, by nacisnąć hamulce?
Źródła:
https://x.com/theinformation/status/2102095568335970690
https://www.theinformation.com/articles/openai-anthropic-neared-deal-stress-test-others-ai
Ten artykuł pochodzi z publicznego konta WeChat „Xin Zhi Yuan”, autor: ASI Revelation; redaktorzy: Aeneas David





