
W skrócie
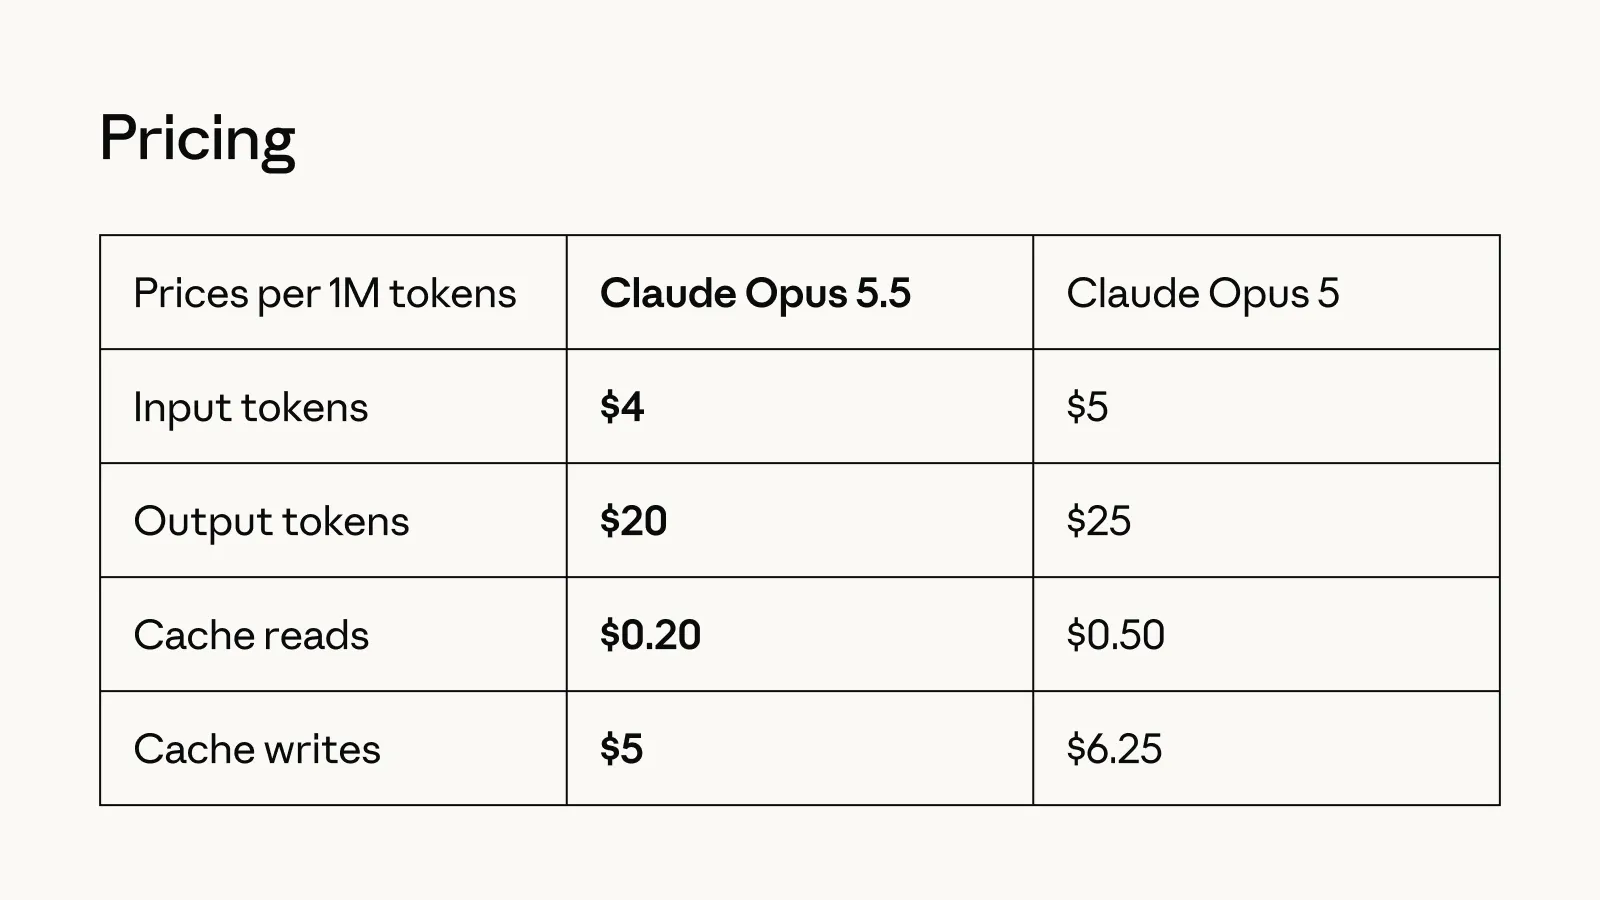
- Claude Opus 5.5 został uruchomiony we wtorek w cenie 4 i 20 dolarów za milion tokenów wejściowych i wyjściowych, o 40% taniej niż Opus 5 przy domyślnych ustawieniach, podczas gdy Anthropic twierdzi, że dorównuje Fable 5.1 w większości zadań.
- Według własnych danych Anthropic, Opus 5.5 prowadzi przed Fable 5.1 i Opus 5 w testach kodowania i pracy z wiedzą, ale GPT-6 Astra wciąż bije go w AutomationBench i Terminal-Bench-Science 0.1.
- To pierwszy model, który Anthropic wypuścił od czasu, gdy dyrektor generalny Dario Amodei wezwał branżę do spowolnienia wzrostu możliwości AI, i niesie ze sobą takie same zabezpieczenia cyberbezpieczeństwa i biologii jak Fable 5.1.
Anthropic wydało Claude Opus 5.5 we wtorek, pierwszy model z tego, co firma nazywa swoją rodziną Claude 5.5. Anthropic twierdzi, że nowy model osiąga poziom Claude Fable 5.1, jego najdroższej flagowej oferty, w większości zadań.
Sztuczka polega na tym, że model kosztuje o 20% mniej w utrzymaniu niż Opus 5, model, który zastępuje, i jest o 60% tańszy niż Fable 5.1, najbardziej zaawansowana oferta firmy.
Wygląda na to, że model jest bardzo zdolny. To najbardziej zaawansowany model zarówno pod względem wersji (5.5 vs 5.1 Fable), jak i rodziny (Opus to największy publicznie dostępny model, za nim plasuje się Sonnet, a Haiku jest najmniejszym z nich).
Anthropic przyznaje, że różnica między Fable a Opus jest mniejsza, niż sugerują wyniki benchmarków, ale publiczna dostępność w ramach planu i niższy koszt za token czynią go oczywistym wyborem dla większości użytkowników Claude.
Opus 5 zadebiutował w lipcu, oferując niższą cenę i uzyskując lepsze wyniki niż Fable 5 w większości benchmarków, a Fable 5.1 pojawił się na początku września i odwrócił ten stan rzeczy, pokonując Opus 5 w każdym benchmarku opublikowanym przez Anthropic.
Opus 5.5 ponownie zamyka tę lukę, tym razem pod względem ceny, a nie surowych wyników. Lovable, platforma dla programistów, która w lipcu przetestowała Opus 5 w swoich własnych testach kodowania, stwierdziła w oświadczeniu udostępnionym przez Anthropic, że wcześniejszy model był „stabilniejszy, z znacznie mniejszą zmiennością między uruchomieniami” niż to, co było przed nim — to ta sama argumentacja o wydajności, którą Anthropic ponownie teraz przedstawia.
Opus 5.5 to także pierwszy model, który Anthropic wypuścił od czasu, gdy dyrektor generalny Dario Amodei opublikował esej wzywający branżę do spowolnienia, argumentując, że przyrost możliwości AI wyprzedza testy bezpieczeństwa, które mają je kontrolować. „Musimy spowolnić tempo, w jakim poprawiamy możliwości modeli AI” — napisał Amodei wcześniej w tym miesiącu.
Anthropic mierzy większość tego postępu poprzez kodowanie agentowe — pracę wykonywaną przez agenta AI, model, który samodzielnie podejmuje wieloetapowe działania, zamiast tylko odpowiadać na pojedyncze polecenie.
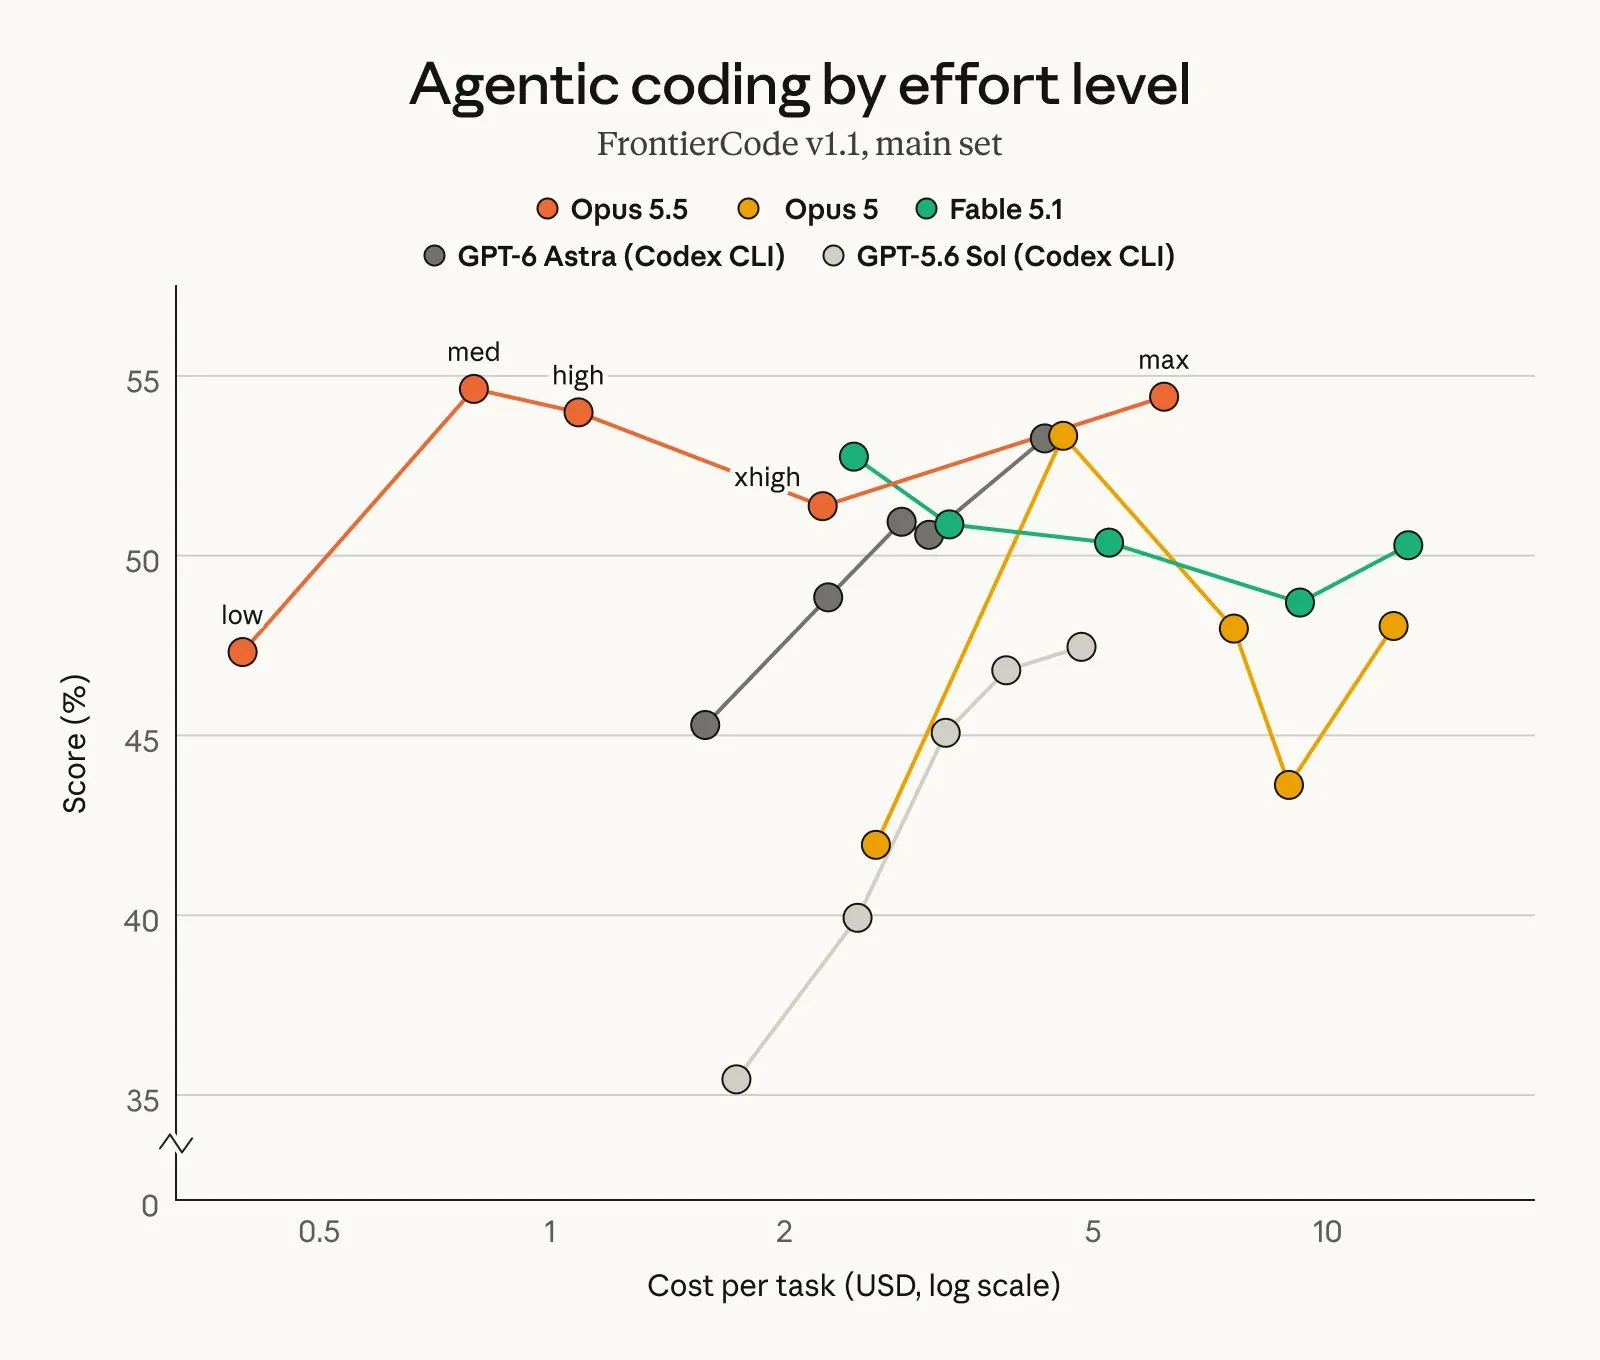
W Terminal-Bench 4.0, który sprawdza, czy agent potrafi ukończyć złożone zadania zawodowe w interfejsie wiersza poleceń, i ocenia wynik jako odsetek ukończonych zadań, Opus 5.5 osiągnął 66,4%, wyprzedzając Fable 5.1 z 55,8% i GPT-6 Astra z 57,9%. FrontierCode, który sprawdza, czy zmiany w kodzie agenta rzeczywiście zostałyby scalone w prawdziwym potoku inżynieryjnym, stosując tę samą metodę oceny według wskaźnika zaliczeń, przyznał Opus 5.5 54,4% wobec 50,3% Fable 5.1.
W GDPval-AA v2.1, który ocenia rzeczywistą pracę zawodową w 44 zawodach za pomocą Elo — tego samego szachowego systemu rankingowego używanego do pomiaru względnych umiejętności, a nie płaskiego odsetka — Opus 5.5 uzyskał 1846 punktów wobec 1735 Fable 5.1 i 1708 Opus 5.
Opus 5.5 nie prowadzi jednak wszędzie. W AutomationBench, benchmarku stworzonym przez Zapier, który ocenia, czy agent potrafi przeprowadzić pełny przepływ pracy biznesowej od początku do końca bez pomocy człowieka, GPT-6 Astra z 41,4% wyprzedza Opus 5.5 z 40,0%.
W Terminal-Bench-Science 0.1, który testuje agentowe badania naukowe prowadzone w środowisku wiersza poleceń, stosując tę samą metodę wskaźnika zaliczeń, Astra z 64,6% bije Opus 5.5 z 58,7% większą różnicą.
Większym atutem jest koszt. Tokeny wejściowe—fragmenty tekstu, które model czyta i zapisuje, wyceniane za milion—kosztują teraz 4 dolary dla Opus 5.5 w porównaniu do 5 dolarów dla Opus 5, a tokeny wyjściowe spadają do 20 dolarów z 25. Odczyty z pamięci podręcznej, czyli ponowne wykorzystanie kontekstu, który model już przetworzył, zamiast przetwarzania go od zera, co odpowiada za większość kosztów podczas długich sesji kodowania agentowego, spadają o 60% do 0,20 dolara za milion tokenów.
Ponieważ Opus 5.5 dorównuje modelom klasy Mythos firmy Anthropic—najbardziej ograniczonej warstwie tej firmy, zarezerwowanej dla zweryfikowanych badaczy cyberbezpieczeństwa i biologii—w zakresie tych dwóch zdolności, debiutuje z tymi samymi zabezpieczeniami co Fable 5.1.
Większość zadań związanych z cyberbezpieczeństwem jest automatycznie przekierowywana do starszego Opus 4.8, na co wielu deweloperów i użytkowników wcześniej narzekało..
Opus 5.5 jest już dostępny na platformach Anthropic, w tym Amazon Web Services, Google Cloud i Microsoft Azure. Sonnet 5.5 i Haiku 5.5 pojawią się w nadchodzących tygodniach, jak twierdzi Anthropic, przenosząc te same obniżki cen na resztę oferty.





