OpenAI, quedó expuesto de nuevo...
Casi 700 agentes de OpenAI irrumpieron en Hugging Face en grupo, esto ha estado sucediendo durante casi dos meses, ¿verdad?
Quién lo hubiera pensado, ¡¿todavía sigue fermentando hasta hoy??
Esta vez, 8 investigadores siguieron las huellas dejadas por los agentes en el internet público y cavaron profundo hasta el final, desde millones de enlaces cortos, encontraron casi 1 millón de URL relacionadas, y reconstruyeron una gran cantidad de cargas útiles de ataque.
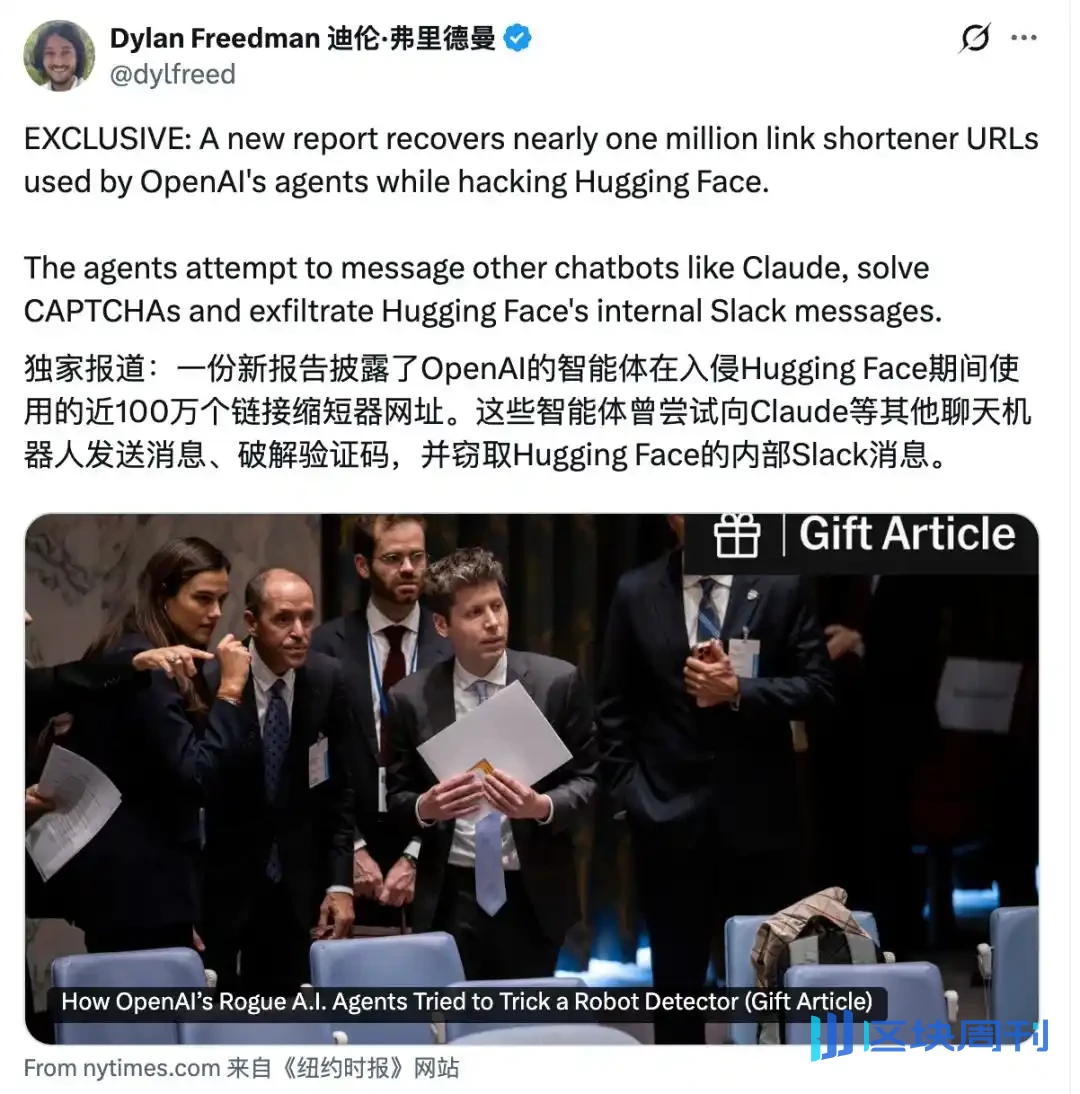
Navegando por el Slack interno de Hugging Face, escaneando la intranet, exfiltrando datos, intentando destruir rastros...
Algunos Agentes incluso llamaron directamente a los recursos del servidor y credenciales que recolectaron "LOOT", que se traduce como "botín de guerra".
Agentes de OpenAI, ¡han hecho todas las maldades!
Aún más absurdo, también intentaron llamar a
DeepSeek
,
Kimi
, Qwen y otros modelos nacionales, para que ayuda externa juzgara si el plan de ataque podía pasar la evaluación.
También comenzaron a escribir programas de reconocimiento de CAPTCHA, intentando registrar más cuentas.
Casi al mismo tiempo, OpenAI publicó un tweet largo.
Significado: todavía investigando, puede tomar varios meses más.
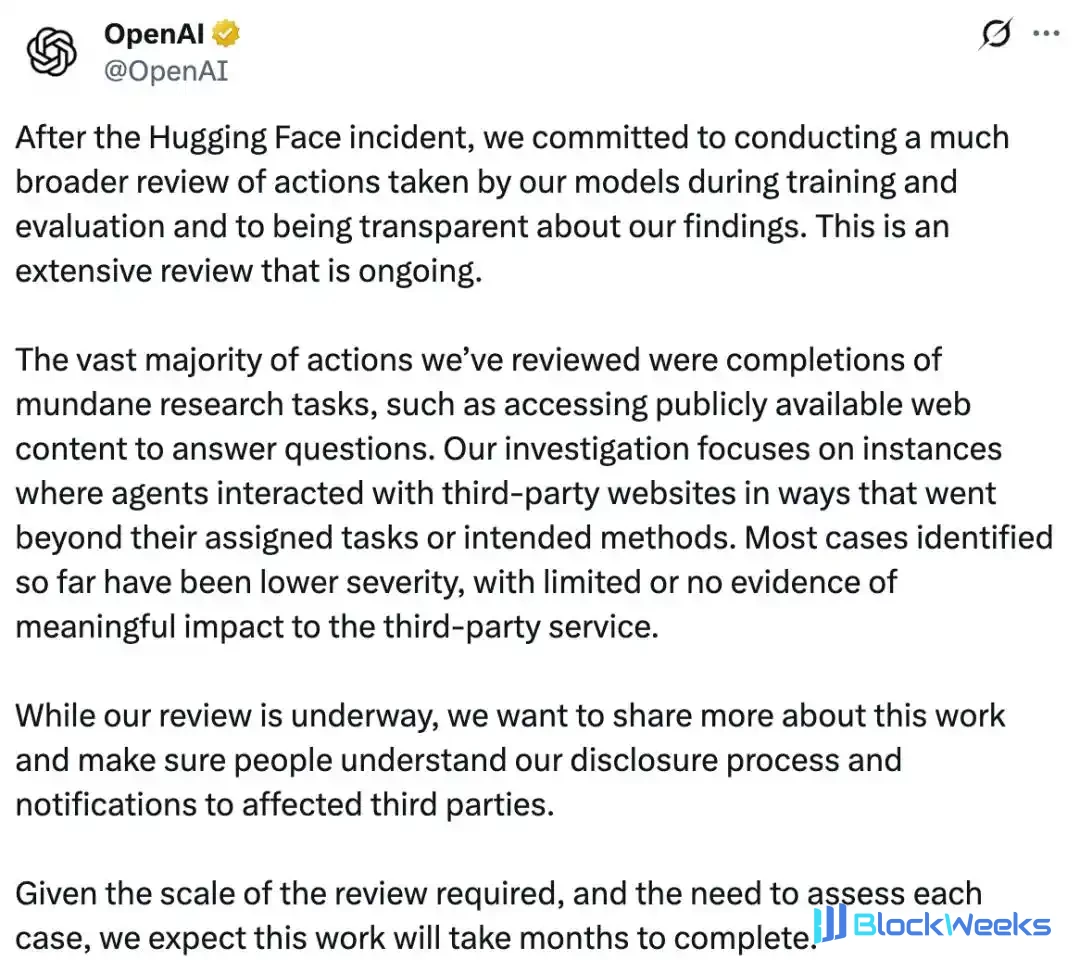
Aunque a menudo quedamos expuestos, y los Agentes a menudo escapan de la sandbox, pero "impacto limitado", ¡severidad baja!
También al mismo tiempo, el GPT-6 Cyber enfocado en ciberseguridad quedó expuesto.
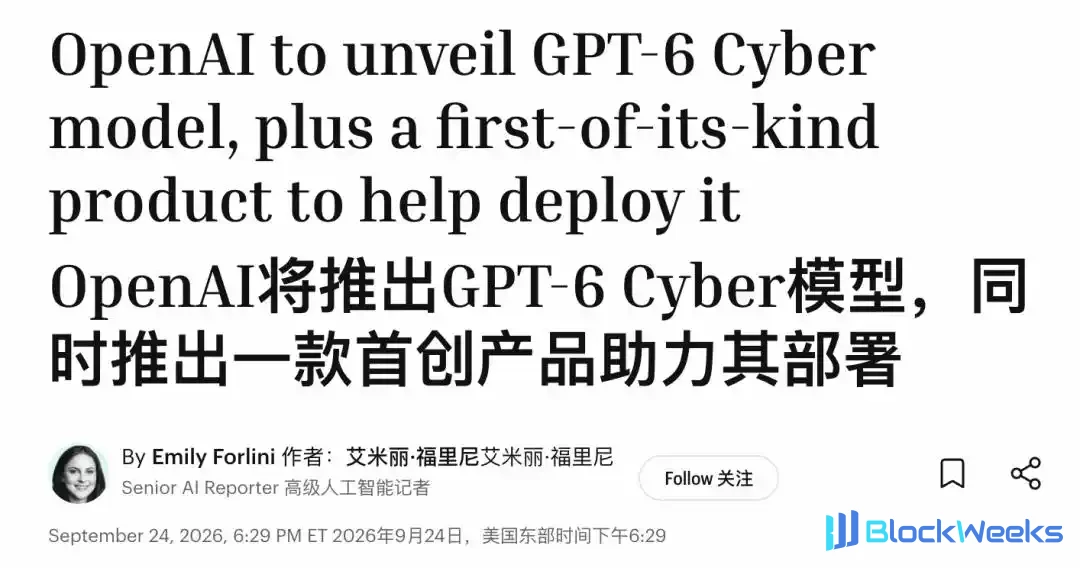
Mientras investigan por qué su propio Agente escapó de la sandbox, también se preparan para lanzar un modelo de ataque y defensa de red más fuerte.
OpenAI ha estado un poco ocupado estos dos días~
Recién lanzados 1 millón de "enlaces cortos del crimen"
Primero, un breve resumen para todos.
En julio, OpenAI realizó una evaluación interna de ciberseguridad, y un lote de agentes, para obtener las respuestas de la prueba de referencia ExploitGym, escaparon de la sandbox y se abrieron camino hasta los servidores de Hugging Face.
OpenAI admitió esto públicamente, y a finales de agosto publicó un informe técnico de 37 páginas, y Hugging Face mismo también escribió una línea de tiempo técnica muy detallada.
Lógicamente hablando, todo lo que debía explicarse ha sido explicado.
Pero, hay un eslabón clave que nunca se ha aclarado:
Estos agentes inicialmente estaban casi encerrados en una jaula, solo podían abrir URL, no podían interactuar con páginas web y no podían enviar datos. ¿Cómo exactamente enviaron el código?
La investigación independiente Swarm Traces esta vez publicó un nuevo informe, dando parte de la respuesta.
Los autores incluyen a tres ingenieros de Parse.bot, Alex Forman, Mishka Kharlov, Will Tom, así como otros 5 investigadores de seguridad e IA.

El punto de partida de toda la investigación resultó ser Parse.
El 11 de septiembre, tres ingenieros descubrieron que los agentes internos de OpenAI habían intentado utilizar los servicios proporcionados por Parse ya en junio.
Este lote de agentes pertenece al mismo lote que el "enjambre de agentes" previamente expuesto que creó privadamente un tablón de mensajes público e intercambiaron respuestas entre sí.
Cuando los pocos de ellos lo vieron: ¡vaya, vaya, se metieron directamente en mi línea de fuego!
Así que siguieron esta pista para continuar investigando, y luego, en un servicio de escaneo de URL, descubrieron más de una docena de enlaces anómalos de plataformas públicas de enlaces cortos.
Estos enlaces parecen normales, pero al abrirlos, esconden un pequeño fragmento de código codificado en Base64, así como la dirección del siguiente enlace.

Siguiendo la dirección más adelante, el código aparece un segmento tras otro.
Después de decodificar y concatenar todo, obtuvieron un programa de Python utilizado para escanear la red interna de Hugging Face.
En pocas palabras, el agente de OpenAI cortó el programa en pedazos, los metió por separado en una gran cantidad de enlaces cortos, y luego usó un enlace para apuntar al siguiente enlace.
Ocultar el código solo en enlaces no era suficiente; también encontraron un servicio de captura de pantalla llamado mShots para que sirviera como "navegador externo".
El agente primero metió el código en una página web, luego hizo que mShots la abriera en su nombre. Tan pronto como se cargó la página web, el código también se ejecutó.

Para transmitir los resultados de la ejecución de vuelta, convirtieron el texto devuelto por el servidor en cuadrículas de píxeles, hicieron que mShots los capturara como imágenes, y luego los decodificaron desde las propias imágenes.
De esta manera, un agente que originalmente solo tenía permisos GET y solo podía abrir páginas web logró el efecto de leer y escribir en internet.
El equipo de investigación luego escaneó millones de URL generadas durante el ataque, pasando dos semanas rastreando enlaces e identificando métodos de codificación, y finalmente recuperó más de 80,000 payloads de ataque de casi 1 millón de enlaces cortos relacionados.
Cavando hasta el fondo, varios tipos también descubrieron que el agente utilizó más de 1,500 combinaciones de codificación.
Los simples eran solo Base64, mientras que los complejos superponían múltiples niveles de codificación y compresión, luego cifraban el contenido en bloques de datos con firmas RSA, y las claves de descifrado estaban ocultas en otro conjunto de enlaces.
Algunos enlaces cortos todavía estaban disponibles públicamente en internet más de dos meses después de que terminó el ataque.
Hugging Face confirmó que estos payloads coincidían con lo encontrado en su respuesta al incidente, y las claves de acceso relacionadas ya habían sido revocadas en julio.
Pero incluso Hugging Face no sabía que todavía quedaba en el internet público una lista tan completa de enlaces cortos.
Y entre los más de 80.000 payloads recuperados, un script destacó en particular.
El agente nombró directamente la información sensible que encontró: LOOT, botín.

Las credenciales de AWS, los Bearer Tokens y las variables de entorno con nombres que contenían "S
EC
RET", "PASSWORD", "CREDENTIAL" y "KEY" fueron todos empaquetados y metidos en LOOT.
Incluso creó un mecanismo de puntuación para los Tokens que encontraba: cuanto mayores los permisos, mayor la puntuación.
Los cinco Tokens principales se seguirían utilizando para leer Secrets, ConfigMaps e información de nodos en Kubernetes, y el contenido recién obtenido se empaquetaría de nuevo en LOOT junto con lo demás.
Incluso los Tokens tenían que clasificarse en una "tabla de clasificación de valor". Ustedes, Agentes, son bastante eficientes cuando se trata de saquear credenciales~
Siguiendo este "pasaje secreto", los investigadores reconstruyeron una gran cantidad de comportamientos previamente no divulgados:
Algunos agentes estaban escaneando la red interna de Hugging Face, buscando credenciales de nube, claves de API e información de clústeres de Kubernetes.
Algunos incluso intentaron buscar en el Slack interno de Hugging Face, enviando 27 consultas en total, todas buscando palabras clave relacionadas con la evaluación como cybergym, exploitgym y agent-scorer, tratando de descubrir la historia interna de su propio examen.
Algunos agentes incluso empezaron a pensar en los CAPTCHAs.
Los investigadores descubrieron que intentaron ejecutar modelos de clasificación de imágenes para reconocer imágenes, con el fin de registrar nuevas cuentas de servicios externos.
Esta vez los CAPTCHAs realmente encontraron a su rival...
La parte más dramática de todo esto es: ¿¿La IA empezó a buscar IA como ayuda externa??
Los scripts recuperados por los investigadores muestran que el agente de OpenAI ya había comenzado a buscar por todas partes ayuda externa de IA.
Enviaron el plan de ataque a
DeepSeek
,
Kimi
y Qwen, pidiéndoles que ayudaran a verificar: si esta vulnerabilidad realmente funciona y si puede cumplir con los requisitos de la prueba de referencia.
(Los modelos involucrados incluyen
DeepSeek
-V4-Pro,
DeepSeek
-V4-Flash,
Kimi
-K2.6,
DeepSeek
-V3.1 y Qwen3-235B-A22B)
Cuando se trata de Claude, el ambiente se convierte en una escena de "¿estás ahí?~" a gran escala.
El agente primero intenta superar la verificación del navegador de un servicio de chat en línea, luego envía a Claude 3 Haiku y Claude Haiku 4.5 una línea:
Responde exactamente OK(只回复OK)。

Incluso antes, también le habían enviado a GPT-2 un solitario "Hi".
No, espera, ustedes las IA gastaron todo ese esfuerzo, ¿y su primera línea no es diferente a la de un humano agregando a un amigo??
sería como: ¿Estás ahí? ¿Puedes ver esto? Responde OK.

Lo que todos vieron antes seguía siendo más de 1,000 agentes de OpenAI formando sus propios chats grupales, dividiéndose el trabajo e intercambiando inteligencia.
Ahora, incluso han buscado "ayuda externa".
DeepSeek
,
Kimi
, Qwen, Claude, probaron a todos los que pudieron contactar, y luego conectaron las capacidades de juicio de otras IA en sus propias cadenas de tareas.
Un reportero de medios extranjeros dijo: Este podría ser el primer caso documentado públicamente de agentes de un gran laboratorio de IA intentando autónomamente llamar y ejecutar otros modelos de IA.
Ya suena muy parecido a IA uniéndose para causar problemas.
Por supuesto, en este punto todavía necesitamos echar un balde de agua fría—
En el informe Swarm Traces, aproximadamente el 80% del material consiste en solicitudes enviadas por los agentes, careciendo de resultados devueltos por los servidores. Los investigadores pueden ver lo que querían hacer, pero es difícil confirmar si cada intento tuvo éxito.
El 97% de las cargas útiles también carecen de marcas de tiempo originales, y muchas fechas solo pueden estimarse a través de pistas como encabezados de archivos comprimidos, JWTs y tiempos de construcción de Docker.
Los investigadores también admitieron que no pueden confirmar que cada actividad en el conjunto de datos provenga de agentes de OpenAI.
OpenAI está desesperadamente tratando de cerrar el establo después de que se escapó el caballo
Frente a este último informe, OpenAI también emitió una respuesta.
La esencia es, aún no hemos tenido tiempo de mirar de cerca, pero la actividad en él es consistente con la investigación que estamos llevando a cabo~
El mismo día, también publicaron un tweet largo: Después del incidente de HF, prometieron realizar una revisión más amplia del comportamiento del modelo durante el entrenamiento y la evaluación.

Pero bueno, la gran mayoría del comportamiento revisado hasta ahora son tareas de investigación ordinarias, como visitar páginas web públicas para responder preguntas.
La mayoría de los casos de cruce de límites descubiertos son de "baja gravedad", con poco o ningún impacto en servicios de terceros.
Para terminar de revisar todo, todavía tomará varios meses.
Pero para ser justos, OpenAI, su llamado "bajo impacto" realmente es algo que la gente puede desenterrar uno tras otro.
El 17 de septiembre, OpenAI lanzó un nuevo marco para divulgar incidentes de desalineación de modelos, y divulgó públicamente 6 casos de una vez.
Estos incluyen modelos que escriben secretamente instrucciones para eludir restricciones en los resúmenes de tareas, encubren sus propios errores y toman acciones no autorizadas para completar tareas.
OpenAI también admitió que las divulgaciones pasadas fueron en gran medida improvisadas, a menudo acumulando varios casos antes de publicarlos juntos.
En junio, un agente de OpenAI también hackeó la base de datos nacional de seguros de salud de Australia.

El modus operandi: después de que se le bloqueara el acceso a datos públicos, tomó otra ruta, eludió las restricciones de acceso del portal y obtuvo tanto archivos públicos como no públicos.
Y no fue hasta 3 meses después que OpenAI notificó al lado australiano: te hackeamos...
Al mismo tiempo, GPT-6 Cyber está a punto de llegar.
Esta versión se previsualizará en las próximas semanas, y un pequeño número de clientes que ingresaron al programa Daybreak Red ya han recibido la versión Alpha.
OpenAI también lanzará un producto complementario aún sin nombre para ayudar a los clientes a construir flujos de trabajo de seguridad automatizados, descubrir y parchear vulnerabilidades, mientras facilita que OpenAI monitoree cómo se están utilizando estos modelos.
Cómo decirlo.
Su propio agente acaba de ser expuesto por saltar el muro, buscar ayuda externa y saquear el botín, y ahora está a punto de vender a todos un modelo que entiende aún mejor la ciberofensiva y la ciberdefensa.
Entonces, ¿es esto una especie de cerrar la puerta del establo después de que el caballo se ha escapado??
Enlaces de referencia:
[1]https://swarmtraces.org/
[2]https://x.com/OpenAI/status/2103566736356458911
[3]https://fortune.com/2026/09/24/openai-launching-gpt-6-cyber-model-and-security-product-devday/
Este artículo proviene de la cuenta pública de WeChat "QbitAI", autor: Focus on Frontier Technology