La inteligencia artificial matemática está cruzando una línea divisoria muy sutil.
En el pasado, preguntábamos: ¿Puede un modelo grande resolver un problema difícil? ¿Puede escribir una prueba rigurosa? ¿Puede encontrar un contraejemplo que los humanos no hayan descubierto durante décadas?
Ahora, ha surgido una pregunta más parecida a "la investigación misma": Después de que una ruta de prueba falla, ¿sabe la IA qué hacer a continuación? ¿Debería continuar calculando, cambiar de ruta, reducir la proposición o simplemente proponer una nueva conjetura matemática falsable?
AI Has Taste, creado por el investigador Zeng Zijian de la Universidad UCSI, está intentando convertir esta pregunta en un sistema de investigación sostenible.
El repositorio público del proyecto registra actualmente 453 manuscritos de investigación matemática y 2.312 páginas de contenido, de los cuales 6 están clasificados explícitamente como "Conjeturas propuestas por IA".
La posición dada en la página de inicio del repositorio es aún más directa: De la generación de respuestas a la generación de agendas de investigación—de generar respuestas a generar agendas de investigación.
La IA refutó una conjetura en un artículo, y el autor original lo confirmó por respuesta
AI Has Taste no partió de la creencia de que "la IA debe ser buena en matemáticas". Zeng Zijian recordó que al comienzo del proyecto, no estaba seguro de si los modelos grandes podrían realmente avanzar en la investigación matemática. Una prueba accidental se convirtió en el punto de inflexión: entregó directamente una conjetura de un artículo a la IA, originalmente solo quería ver hasta dónde podía llegar el modelo. Como resultado, la IA no continuó "probando" a lo largo del artículo, sino que construyó un contraejemplo que refutó directamente la conjetura.
Su primera reacción no fue emoción, sino incredulidad. Así que organizó el contraejemplo y la derivación y escribió al autor del artículo original para verificarlo. La respuesta que recibió posteriormente confirmó: este contraejemplo es válido. La investigación correspondiente se incluyó más tarde entre los actuales más de 450 manuscritos matemáticos.
"Al principio no creía en el poder de la IA en matemáticas. Hasta que introduje una conjetura de un artículo, y la IA dio directamente un contraejemplo para refutarla; escribí inmediatamente al autor original, y la otra parte respondió confirmando que era correcto. Después de eso, realmente me solté y me entregué por completo." — Zeng Zijian
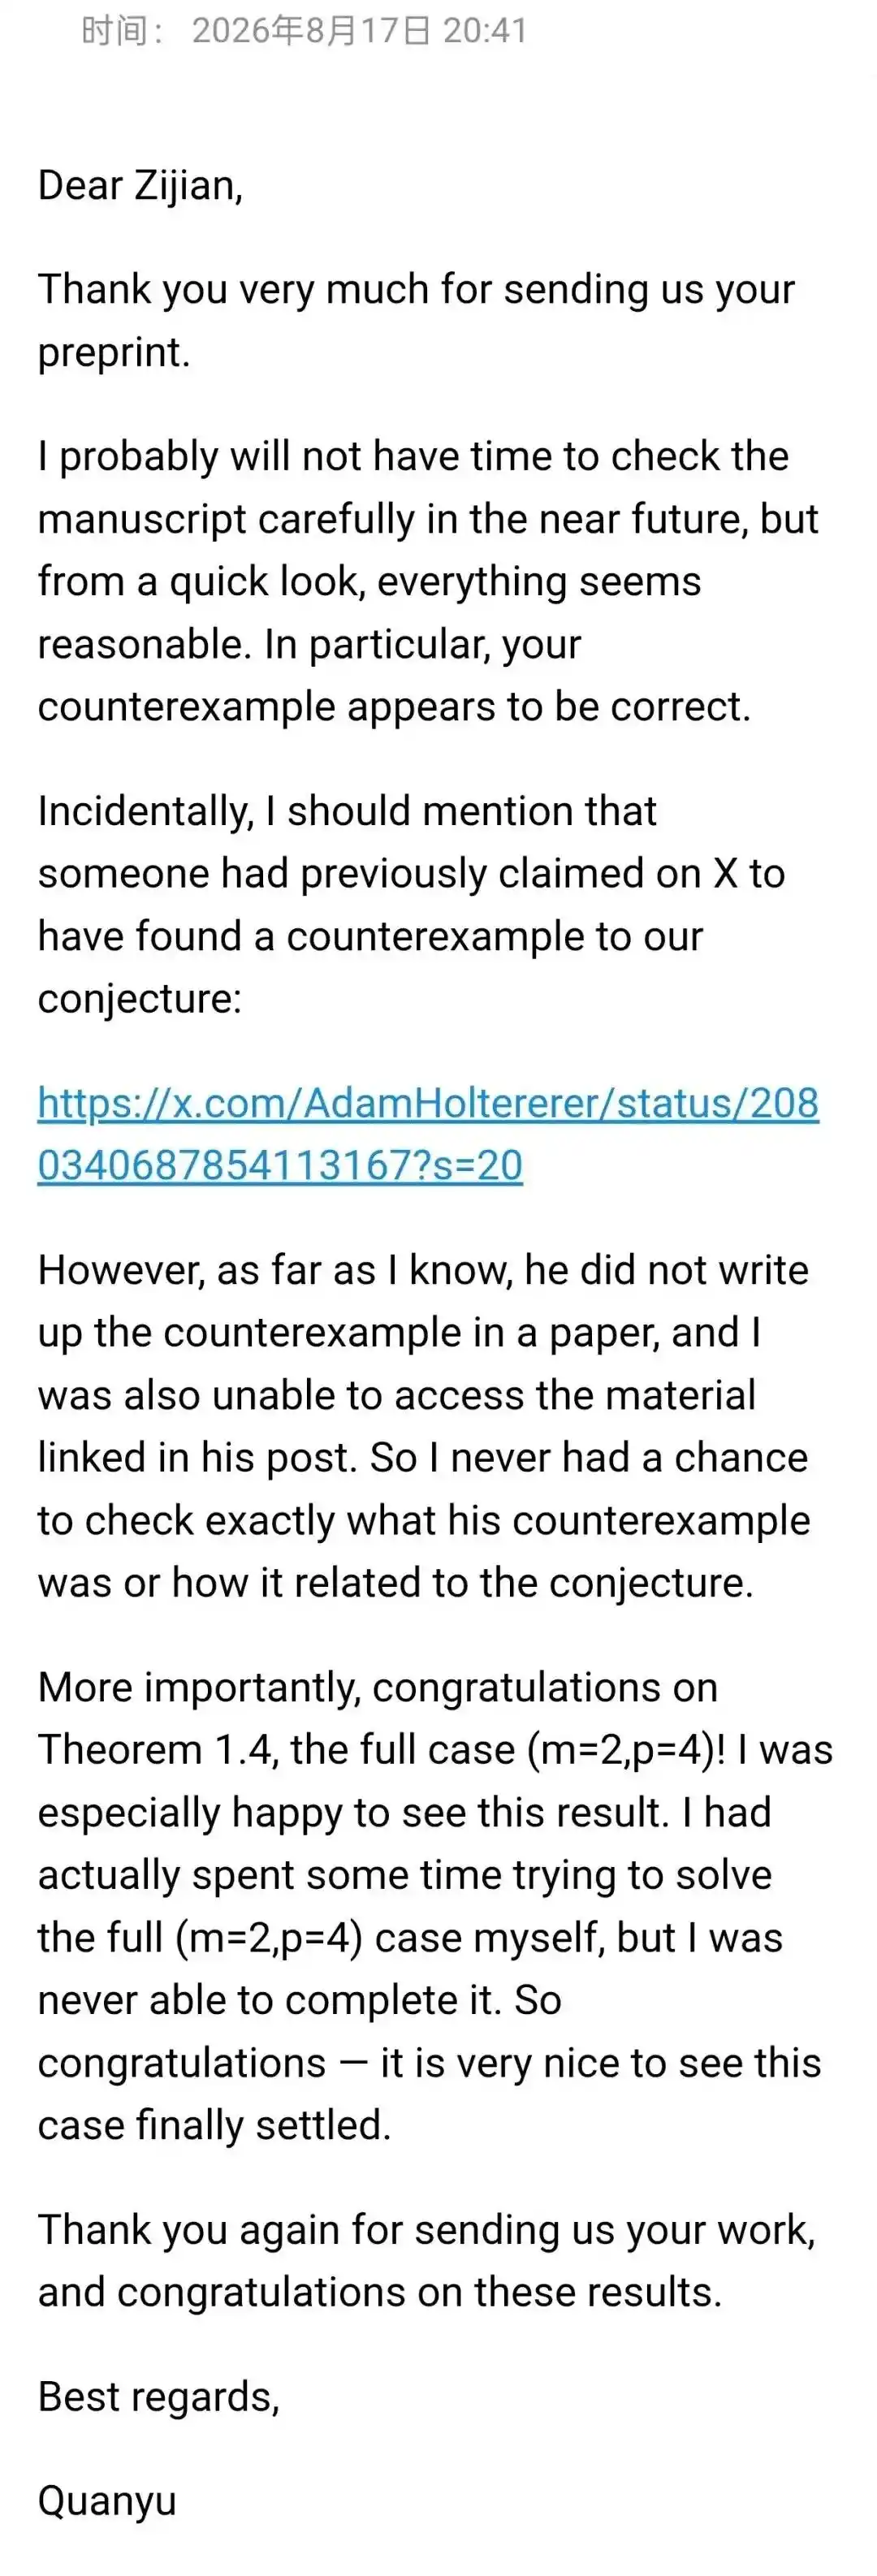
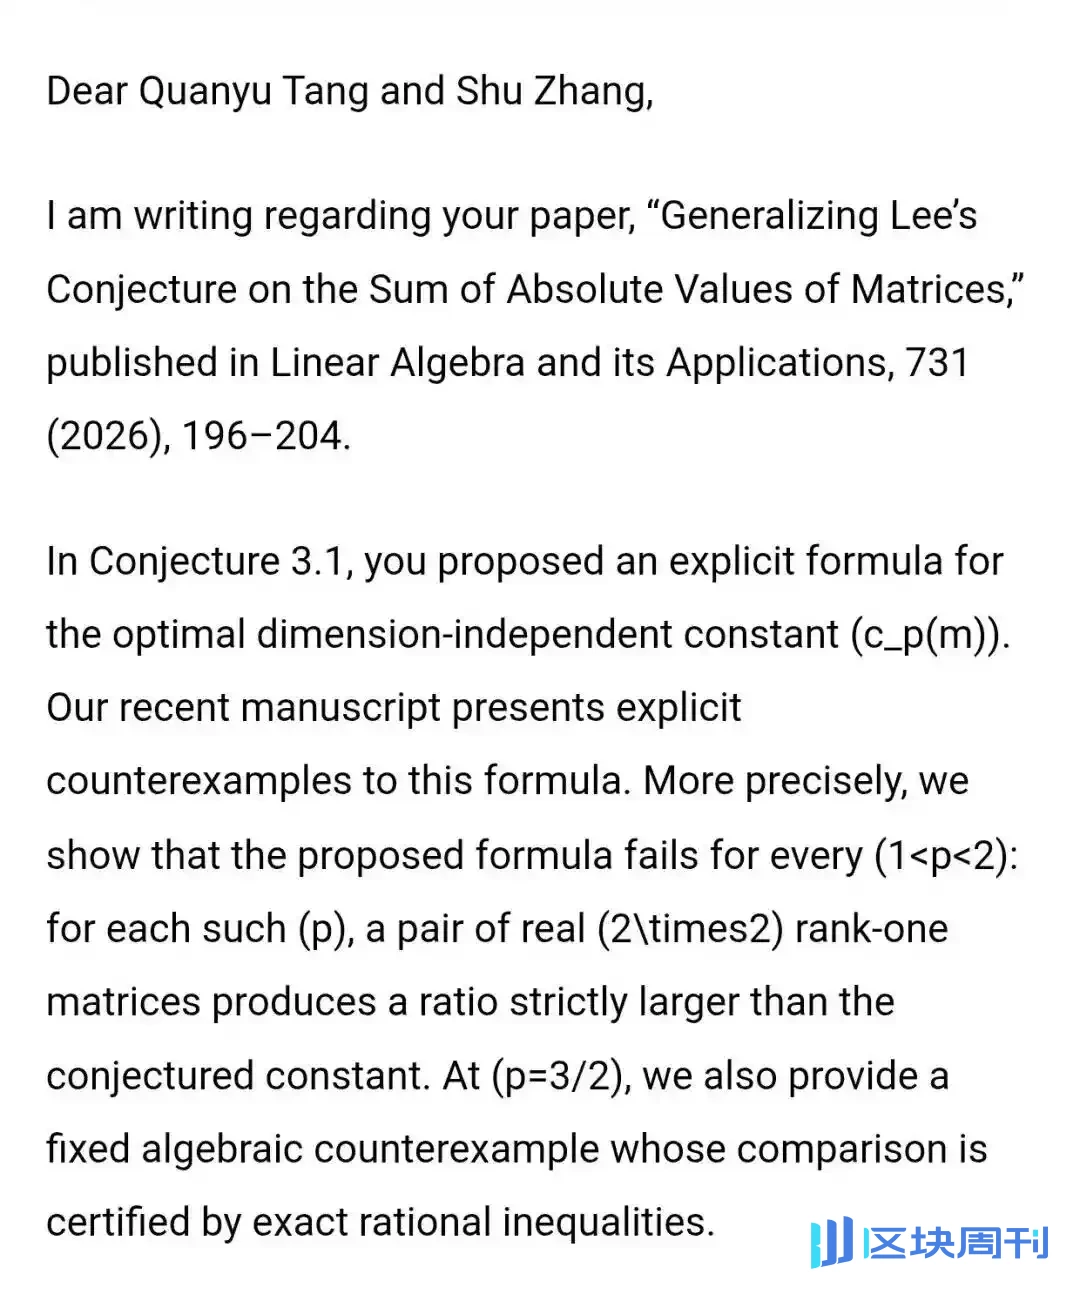
Lo que este correo electrónico cambió no fue una sola conjetura, sino la escala del proyecto. Si la IA no solo puede reformular conocimiento conocido y generar texto que parece una prueba, sino también atacar activamente nuevas conjeturas en artículos y encontrar un contraejemplo confirmado por el autor original, entonces tiene la oportunidad de entrar realmente en el "bucle de investigación". Después de eso, Zeng Zijian comenzó a agentificar gradualmente la selección de temas, la prueba, la búsqueda de contraejemplos, la gestión de fallos, la revisión independiente y la escritura, y dejó que diferentes máquinas funcionaran en paralelo a largo plazo.
El verdadero cambio no es "cuántos artículos se escribieron"
Considerando solo la cantidad, 453 manuscritos ya son suficientemente llamativos. Pero si este proyecto se entiende solo como "IA escribiendo artículos matemáticos en lotes", entonces se pierde la parte más notable.
El proyecto mismo enfatiza repetidamente: 453 es el número de "manuscritos de investigación", lo cual no equivale a que los 453 problemas abiertos originales hayan sido resueltos. Los resultados incluyen pruebas completas, contraejemplos, resultados parciales, certificados de computación finita, reducciones estructuradas y artículos que proponen nuevas conjeturas. La revisión interna de IA tampoco equivale a la revisión por pares externa.
El verdadero cambio ocurre en la cadena de investigación. Los benchmarks tradicionales de IA a menudo parten de "el problema ya ha sido dado": los humanos eligen el tema, la IA lo resuelve y finalmente hay éxito o fracaso. AI Has Taste extiende el proceso tanto hacia adelante como hacia atrás—la IA puede filtrar problemas candidatos, comparar rutas y buscar activamente contraejemplos; después de que una ruta falla, también puede analizar la estructura del fallo, modificar la proposición y entregar nuevos objetos matemáticos a otro Agente independiente para continuar atacando.

La clave de AI Has Taste no es "más prompts", sino convertir el fracaso en insumo para la siguiente ronda de investigación.
Agentes de selección de tema, prueba, búsqueda de errores y redacción
Este sistema no es "un modelo preguntándose y respondiéndose a sí mismo en un solo cuadro de diálogo". El README público divide los roles de los Agentes en cuatro capas:
Supervisor / Screener es responsable de seleccionar candidatos, comparar resultados cercanos y encontrar el experimento decisivo más económico;
Researcher es responsable de pruebas, contraejemplos y cálculos exactos;
Fresh-context Reviewer ataca específicamente proposiciones congeladas, lemas clave y certificados en un contexto nuevo;
Writer / Release Checker es responsable de escribir claramente el alcance final aceptado y verificar citas, compilaciones y materiales de publicación.
Zeng Zijian desplegó además el flujo de trabajo como colaboración multimáquina: diferentes máquinas pueden avanzar por separado en pruebas, buscar contraejemplos, ejecutar cálculos exactos y realizar revisión independiente. Lo que se comparte son proposiciones congeladas, registros de experimentos, razones de fallo, código y evidencia, en lugar de dejar que un Agente genere resultados y se autoapruebe.

El diseño central de multiagente: separación de roles + evidencia compartida + revisión con contexto fresco.
Hay una frase en el repositorio que resume muy bien este diseño: La crítica es parte del motor, no una posdata. La crítica no es un procedimiento añadido después de escribir el artículo, sino una parte del motor de investigación.
Matemáticos, roboticistas y académicos de automatización entran en la cadena de verificación
A medida que los manuscritos de investigación crecieron de docenas a cientos, otra pregunta se volvió más aguda: ¿quién juzga que estos resultados de los agentes no son alucinaciones sistemáticas?
AI Has Taste utiliza internamente un Fresh-context Reviewer para separar "investigación" y "búsqueda de errores", pero el proyecto no trata la autorrevisión de la IA como el punto final.
A medida que el trabajo avanzaba, Zengzaijian también comenzó a invitar a académicos reales de diferentes campos a participar en la verificación, revisión y discusión académica de algunos resultados.
Según el equipo del proyecto, los colaboradores y revisores involucrados en parte del trabajo incluyen: Ong Seng Huat, Fellow de la Academia de Ciencias de Malasia y Profesor Honorario del Instituto de Ciencias Matemáticas de la Universidad de Malaya; Kurunathan Ratnavelu, Fellow de la Academia de Ciencias de Malasia y Profesor Honorario del Instituto de Ciencias Matemáticas de la Universidad de Malaya; y el Profesor Xiong Yonghua de la Escuela de Inteligencia Artificial y Automatización de la Universidad de Geociencias de China (Wuhan).
Aquí es necesario distinguir entre "participar en la verificación" y "respaldar todos los resultados": los académicos mencionados no firmaron los 453 manuscritos uno por uno, sino que verificaron, revisaron o discutieron algunos de los problemas, pruebas, resultados computacionales o direcciones de investigación.
Para un sistema de investigación científica altamente automatizado, esta combinación de "equipo rojo interno de la máquina + verificaciones puntuales/revisión de expertos humanos" es, por el contrario, más crítica que entregar toda la revisión al mismo conjunto de agentes.
La IA se encarga de llevar la velocidad de la investigación al límite; los expertos humanos se encargan de devolver lo "aparentemente válido" a lo "digno de creerse" en los nodos clave.
Tras el fracaso, se eligió una pregunta mejor
El caso del proyecto que mejor encarna el "gusto por la investigación" no es precisamente un bello éxito, sino un fracaso.
En el problema de la traza gaussiana fraccionaria, el sistema intentó inicialmente rutas de monotonicidad y emparejamiento unilateral, pero no dejaban de aparecer contraejemplos exactos. Un benchmark ordinario normalmente solo dejaría una etiqueta aquí: FALLIDO.
Pero este flujo de trabajo no se detuvo. El agente siguió preguntando: ¿qué rompió exactamente el contraejemplo? ¿Tiene el fracaso una estructura estable? Al final, la investigación desplazó la atención hacia un defecto negativo fijo, construyó una estructura de corrección de diez términos y propuso una nueva conjetura unificada de acotación. Más crucial aún, la nueva conjetura fue luego atacada a su vez por otra ronda de cómputo exacto y revisión independiente. El escaneo del archivo público alcanzó el índice 1004; esta cota unificada aún no ha sido demostrada.
La importancia de este asunto no es que "la IA demostró otro gran teorema"—de hecho, no lo hizo. La importancia es que: el problema original no se resolvió, pero la ruta fallida se comprimió en una nueva proposición más clara, más falsable y que, una vez se sostenga, puede reconectarse con el problema original. La investigación no terminó en el fracaso, sino que hizo crecer el siguiente problema a partir del fracaso.
Antes: los humanos planteaban los problemas, la IA los respondía. Ahora: la IA responde problemas y también empieza a participar en decidir "cuál es el siguiente problema".
6 nuevas conjeturas de IA
Hasta la instantánea pública actual, el repositorio clasifica 6 artículos por separado bajo "Conjeturas propuestas por IA". Estos trabajos abarcan combinatoria, teoría de grafos, teoría de números y problemas de tipo analítico, incluida la no singularidad de matrices de núcleo binario infinitas para tres subsecuencias de A182510, la colorabilidad CDS de diagramas de Young, la descomposición de grafos sin triángulos con grado máximo a lo sumo 6, fórmulas de congruencia unaria-theta para particiones de Frobenius generalizadas de 18 colores, la no negatividad de los coeficientes de Newton para denominadores de subsumas recíprocas sobre etapas diádicas, y la mencionada conjetura de defecto fijo para la traza gaussiana fraccionaria.
Lo que realmente merece atención no es si la IA puede "hacer una lluvia de ideas para una conjetura". Adivinar una frase al azar no es difícil. Lo difícil es escribir la conjetura en una definición precisa, explicar de dónde viene, qué evidencia la respalda, qué contraejemplos podrían refutarla, a qué resultados llevaría si se sostiene, y dejar el cómputo y el código fuente para su revisión posterior.
Esto también explica por qué el proyecto considera "proponer conjeturas" como una acción de investigación de nivel superior a "generar respuestas": las pruebas responden preguntas existentes, mientras que las conjeturas cambian dónde se invierten los recursos de investigación posteriores.
Detrás de 453 manuscritos está el prototipo de la "investigación científica a escala de agentes"
AI Has Taste ha publicado actualmente 453 manuscritos de investigación, con un total de 2312 páginas; entre ellos, solo el flujo de trabajo BigWIN2 corresponde a 223 manuscritos, y proporciona paquetes emparejados de materiales LaTeX/reproducción para estos 223 trabajos.
Lo más contraintuitivo de esta escala no es que "la IA escriba rápido". Lo que realmente es costoso en la investigación matemática es el cambio de contexto: este problema requiere teoría de grafos, el siguiente requiere teoría de números, y el siguiente puede requerir SAT, búsqueda exhaustiva, aritmética racional exacta o cálculo matricial. Un investigador humano no puede mantener simultáneamente cientos de líneas de pensamiento completamente diferentes, pero un sistema de agentes puede dividirlas en tareas independientes y preservar rutas fallidas, teoremas locales y experimentos reproducibles.
Así, el papel del investigador individual está cambiando: no derivar personalmente cada paso, sino más bien como un PI—establecer los límites de la investigación, elegir el conjunto de problemas, decidir qué resultados merecen seguir invirtiendo, cuándo detenerse y qué conclusiones están calificadas para hacerse públicas.
¿Por qué se llama "AI Has Taste"?
"AI has taste" suena muy antropomórfico, pero el README del proyecto establece deliberadamente un límite: el gusto aquí no es conciencia ni experiencia subjetiva, sino "juicio matemático expresado a través de decisiones de investigación".
Por ejemplo: si ambos problemas se pueden resolver, ¿cuál primero? Una ruta ya tiene progreso local, pero los rendimientos marginales son cada vez más bajos—¿debería detenerse? ¿Un contraejemplo es una sentencia de muerte para la proposición, o muestra que el teorema real debería formularse de manera diferente? ¿Un resultado pequeño es suficiente para presentarse como un artículo independiente? Estas decisiones solían estar implícitas en la experiencia de los investigadores en el pasado y eran difíciles de medir con benchmarks estándar.
AI Has Taste intenta dejar un rastro inspeccionable de estas decisiones: qué problema se eligió, por qué se cambió la ruta, qué estructura dejó el fracaso, de dónde vino la siguiente proposición y cómo la nueva conclusión fue atacada de nuevo por un contexto independiente.
¿Qué tan lejos está de un "matemático autónomo"?
El punto donde este proyecto se exagera más fácilmente también debe aclararse. 453 manuscritos no son 453 artículos de revista que hayan pasado por revisión por pares formal; la revisión interna del agente no equivale a una revisión independiente por parte de la comunidad matemática; y el alcance cubierto por la computación finita no puede generalizarse automáticamente al caso infinito. El propio repositorio declara explícitamente estas limitaciones.
Pero si uno ignora su forma de organizar la investigación solo porque estos resultados no han completado toda la verificación externa, también se perdería otro cambio: la frontera de la capacidad de la IA se está moviendo de "ejecutar una tarea dada" a "participar en el diseño de la siguiente tarea".
Los recursos verdaderamente escasos en la investigación matemática nunca han sido solo la potencia de cálculo y la longitud de razonamiento, sino también: qué problemas vale la pena dedicar tiempo, qué fracasos vale la pena preservar y cuándo debe cambiarse el tema.
Cuando la IA comienza a entrar en estos eslabones, la competencia en "AI for Math" ya no es solo "quién es mejor demostrando", sino que gradualmente se convertirá en: quién tiene un mejor bucle de investigación y quién puede destilar de una gran cantidad de fracasos las direcciones que vale más la pena seguir persiguiendo.
Una cosa más
La narrativa pasada de la investigación científica con IA se parecía mucho a un superestudiante: el profesor plantea los problemas y él se encarga de resolverlos.
Lo que AI Has Taste quiere hacer se parece más a un grupo de investigación: los humanos proporcionan límites y juicios de valor, y los agentes encuentran problemas, prueban problemas, cometen errores, se refutan a sí mismos, dejan resultados locales y luego proponen el siguiente problema.
Si esta ruta sigue siendo válida, la división del trabajo más importante entre humanos y máquinas en la investigación básica futura puede cambiar de "los humanos se encargan de pensar, la IA se encarga de calcular" a una estructura más compleja: los humanos se encargan de los objetivos, los valores y la responsabilidad última; la IA asume la búsqueda a gran escala, la verificación, la gestión de fracasos y la generación de direcciones de investigación candidatas; las herramientas formales y la evidencia pública se encargan de hacer que los resultados sean revisables.
Después de que la IA pueda resolver problemas, el siguiente obstáculo puede ser realmente: ¿puede la IA elegir problemas?
Este artículo proviene de la cuenta pública de WeChat "Xin Zhi Yuan", autor: Xin Zhi Yuan