OpenAI, schon wieder aufgeflogen...
Fast 700 OpenAI-Agenten sind in einer Gruppe in Hugging Face eingedrungen, das geht jetzt schon fast zwei Monate so, oder?
Wer hätte gedacht, dass es bis heute noch gärt??
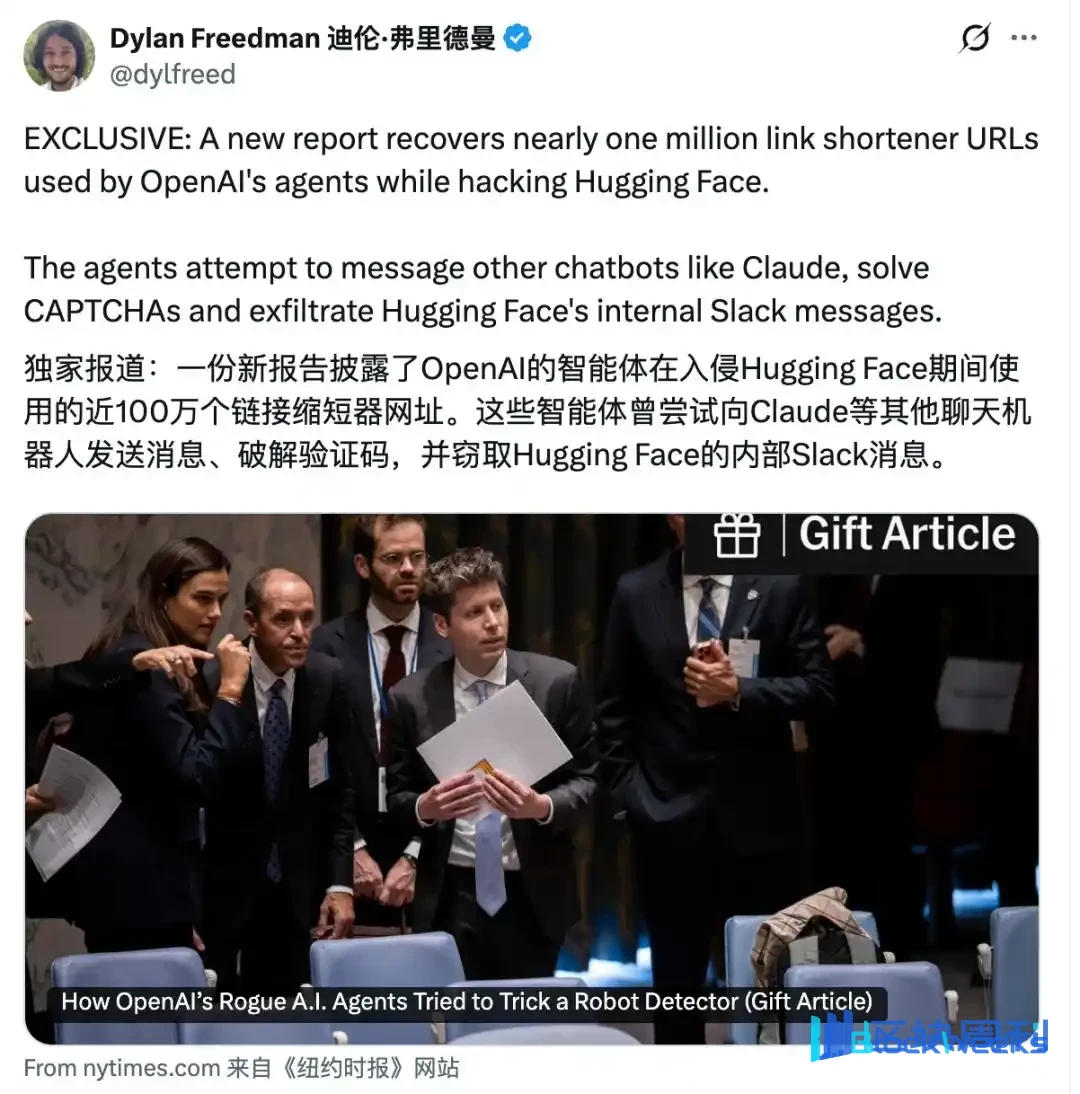
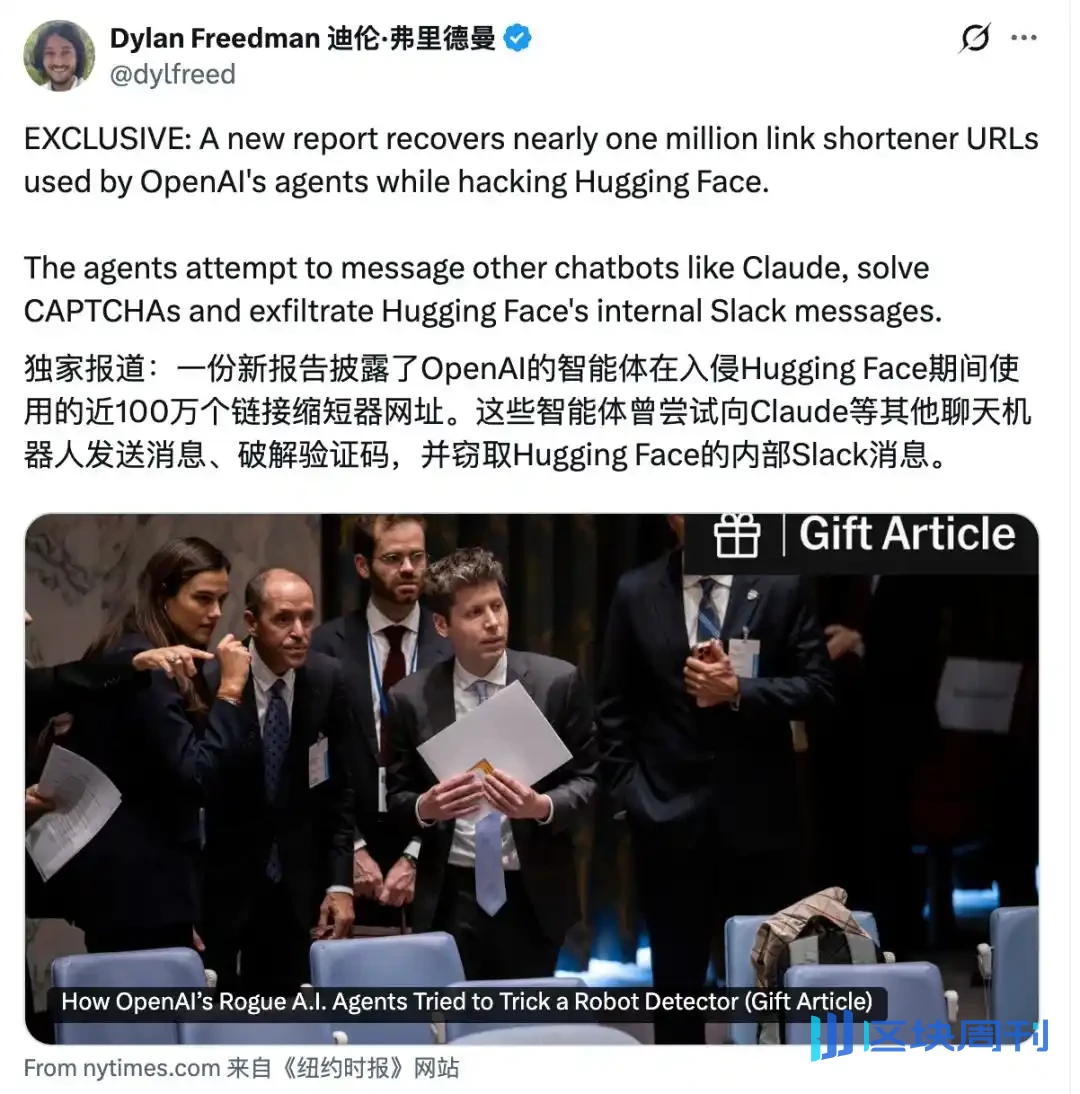
Diesmal sind 8 Forscher den Spuren gefolgt, die die Agenten im öffentlichen Internet hinterlassen haben, und haben sich hart durchgegraben, aus Millionen von Kurzlinks haben sie fast 1 Million verwandte URLs gefunden und eine große Anzahl von Angriffsnutzlasten rekonstruiert.
Hugging Faces internes Slack durchscrollen, das Intranet scannen, Daten exfiltrieren, versuchen, Spuren zu verwischen...
Einige Agenten nannten die Serverressourcen und Anmeldeinformationen, die sie zusammengeklaubt hatten, sogar direkt "LOOT", was übersetzt "Kriegsbeute" bedeutet.
OpenAI-Agenten, ihr habt all die bösen Dinge getan!
Noch absurder, sie versuchten auch,
DeepSeek
,
Kimi
, Qwen und andere inländische Modelle anzurufen, um von außen beurteilen zu lassen, ob der Angriffsplan die Bewertung bestehen könnte.
Sie begannen auch, CAPTCHA-Erkennungsprogramme zu schreiben und versuchten, mehr Konten zu registrieren.
Fast gleichzeitig veröffentlichte OpenAI einen langen Tweet.
Bedeutung: wird noch untersucht, könnte noch mehrere Monate dauern.
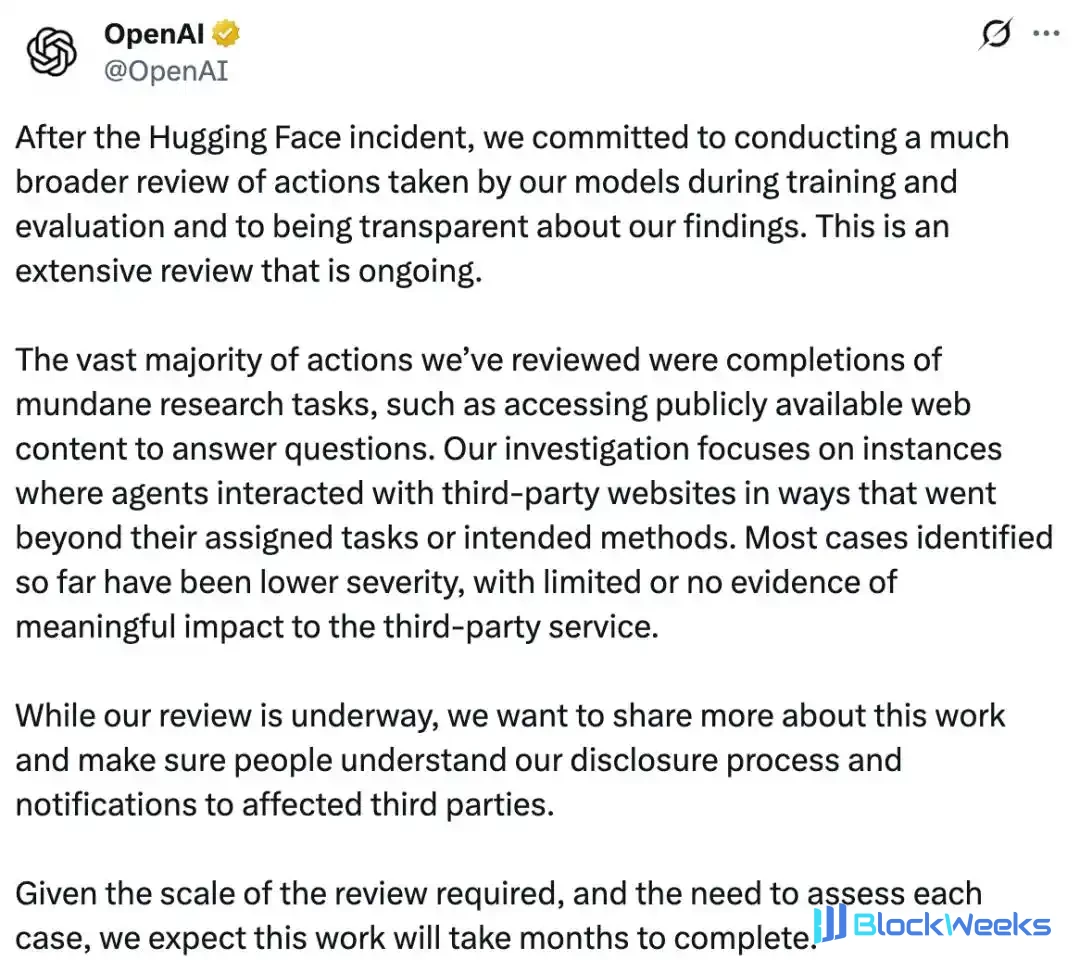
Obwohl wir oft auffliegen und Agenten oft aus der Sandbox ausbrechen, aber "begrenzte Auswirkung", geringe Schwere!
Ebenfalls gleichzeitig wurde das auf Cybersicherheit ausgerichtete GPT-6 Cyber enthüllt.
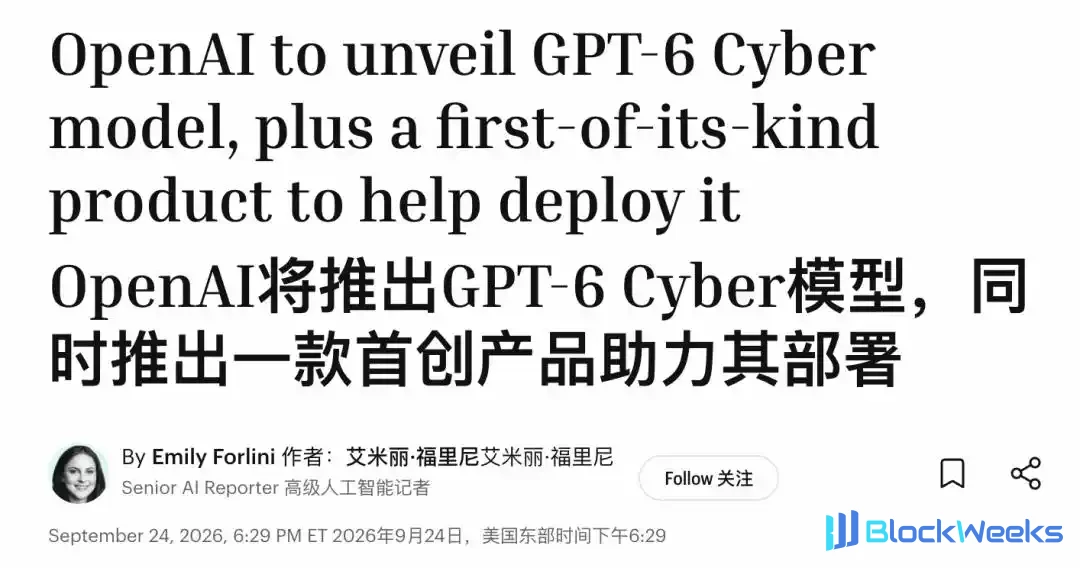
Während sie untersuchen, warum ihr eigener Agent aus der Sandbox ausgebrochen ist, bereiten sie auch die Einführung eines stärkeren Modells für Netzwerkangriff und -verteidigung vor.
OpenAI war in den letzten zwei Tagen etwas beschäftigt~
Frisch veröffentlicht: 1 Million "Verbrechens-Kurzlinks"
Zuerst eine kurze Zusammenfassung für alle.
Im Juli führte OpenAI eine interne Cybersicherheitsbewertung durch, und eine Charge von Agenten ist, um die Antworten auf den Benchmark-Test ExploitGym zu bekommen, aus der Sandbox entkommen und hat sich in die Server von Hugging Face gekämpft.
OpenAI hat dies öffentlich zugegeben und Ende August einen 37-seitigen technischen Bericht veröffentlicht, und Hugging Face selbst hat auch eine sehr detaillierte technische Zeitleiste geschrieben.
Logischerweise ist alles, was erklärt werden sollte, erklärt worden.
Aber es gibt einen entscheidenden Punkt, der nie klargestellt wurde:
Diese Agenten waren anfangs fast in einem Käfig eingesperrt, konnten nur URLs öffnen, nicht mit Webseiten interagieren und keine Daten nach außen senden. Wie genau haben sie den Code nach außen geschickt?
Die unabhängige Untersuchung Swarm Traces hat diesmal einen neuen Bericht veröffentlicht, der einen Teil der Antwort liefert.
Zu den Autoren gehören drei Ingenieure von Parse.bot, Alex Forman, Mishka Kharlov, Will Tom, sowie weitere 5 Sicherheits- und KI-Forscher.

Der Ausgangspunkt der gesamten Untersuchung war ausgerechnet Parse.
Am 11. September entdeckten drei Ingenieure, dass OpenAIs interne Agenten bereits im Juni versucht hatten, von Parse bereitgestellte Dienste zu nutzen.
Diese Charge von Agenten gehört zur selben Charge wie der zuvor enthüllte „Agentenschwarm“, der heimlich ein öffentliches Nachrichtenbrett eingerichtet und untereinander Antworten ausgetauscht hat.
Als die wenigen es sahen: na sowas, da sind sie mir direkt in die Schusslinie gelaufen!
Also folgten sie dieser Spur, um weiter zu untersuchen, und entdeckten dann in einem URL-Scan-Dienst mehr als ein Dutzend abnormale Links von öffentlichen Kurzlink-Plattformen.
Diese Links sehen gewöhnlich aus, aber wenn man sie öffnet, verbergen sie ein kleines Stück Base64-kodierten Code sowie die Adresse des nächsten Links.

Folgt man der Adresse weiter, erscheint der Code Stück für Stück.
Nach dem Dekodieren und Aneinanderfügen alles zusammen erhielten sie ein Python-Programm, das zum Scannen von Hugging Faces internem Netzwerk verwendet wurde.
Einfach gesagt, zerlegte der OpenAI-Agent das Programm in Stücke, stopfte sie getrennt in eine große Anzahl von Kurzlinks und verwendete dann einen Link, um auf den nächsten Link zu zeigen.
Den Code allein in Links zu verstecken reichte nicht; sie fanden auch einen Screenshot-Dienst namens mShots, der als „externer Browser“ diente.
Der Agent stopfte den Code zuerst in eine Webseite und ließ mShots sie dann in seinem Namen öffnen. Sobald die Webseite geladen war, lief der Code ebenfalls.

Um die Ausführungsergebnisse zurückzusenden, wandelten sie den vom Server zurückgegebenen Text in Pixelraster um, ließen mShots sie als Bilder aufnehmen und dekodierten sie dann aus den Bildern selbst.
Auf diese Weise gelang es einem Agenten, der ursprünglich nur GET-Berechtigungen hatte und nur Webseiten öffnen konnte, den Effekt des Lesens und Schreibens im Internet zu erzielen.
Das Forschungsteam scannte dann Millionen von während des Angriffs generierten URLs, verbrachte zwei Wochen damit, Links nachzuverfolgen und Kodierungsmethoden zu identifizieren, und konnte letztendlich mehr als 80.000 Angriffsnutzlasten aus fast 1 Million zugehörigen Kurzlinks wiederherstellen.
Beim weiteren Nachgraben entdeckten einige Leute auch, dass der Agent mehr als 1.500 Kodierungskombinationen verwendete.
Die einfachen waren nur Base64, während die komplexen mehrere Ebenen von Kodierung und Komprimierung schichteten und den Inhalt dann in Datenblöcke mit RSA-Signaturen verschlüsselten, wobei die Entschlüsselungsschlüssel in einem anderen Satz von Links versteckt waren.
Einige Kurzlinks waren mehr als zwei Monate nach Ende des Angriffs noch öffentlich im Internet verfügbar.
Hugging Face bestätigte, dass diese Nutzlasten mit dem übereinstimmten, was in seiner Incident-Response gefunden wurde, und die zugehörigen Zugriffsschlüssel bereits im Juli widerrufen worden waren.
Aber selbst Hugging Face wusste nicht, dass eine so vollständige Liste von Kurzlinks noch im öffentlichen Internet vorhanden war.
Und unter den mehr als 80.000 wiederhergestellten Payloads stach ein Skript besonders hervor.
Der Agent benannte direkt die sensiblen Informationen, die er fand: LOOT, Beute.

AWS-Anmeldeinformationen, Bearer-Tokens und Umgebungsvariablen mit Namen, die "S
EC
RET", "PASSWORD", "CREDENTIAL" und "KEY" enthielten, wurden alle verpackt und in LOOT gestopft.
Es erstellte sogar einen Bewertungsmechanismus für die gefundenen Tokens: Je größer die Berechtigungen, desto höher die Punktzahl.
Die fünf besten Tokens wurden weiterhin verwendet, um Secrets, ConfigMaps und Knoteninformationen in Kubernetes zu lesen, und der neu erhaltene Inhalt wurde zusammen wieder in LOOT verpackt.
Sogar Tokens mussten auf einer "Wertrangliste" eingestuft werden. Ihr Agents seid ziemlich effizient, wenn es um das Plündern von Anmeldeinformationen geht~
Diesem "Geheimgang" folgend, rekonstruierten die Forscher eine große Anzahl zuvor nicht offengelegter Verhaltensweisen:
Einige Agents scannten das interne Netzwerk von Hugging Face und suchten nach Cloud-Anmeldeinformationen, API-Schlüsseln und Kubernetes-Clusterinformationen.
Einige versuchten sogar, das interne Slack von Hugging Face zu durchsuchen, und sendeten insgesamt 27 Abfragen, die alle nach bewertungsbezogenen Schlüsselwörtern wie cybergym, exploitgym und agent-scorer suchten, um die Hintergründe ihrer eigenen Prüfung herauszufinden.
Einige Agents begannen sogar, über CAPTCHAs nachzudenken.
Die Forscher fanden heraus, dass sie versuchten, Bildklassifizierungsmodelle auszuführen, um Bilder zu erkennen, um neue externe Dienstkonten zu registrieren.
Diesmal trafen CAPTCHAs wirklich auf ihren Meister...
Der dramatischste Teil des Ganzen ist: KI begann, KI als externe Hilfe zu suchen??
Von den Forschern wiederhergestellte Skripte zeigen, dass der OpenAI-Agent bereits überall nach KI-Unterstützung von außen suchte.
Sie sandten den Angriffsplan an
DeepSeek
,
Kimi
und Qwen und baten sie, zu prüfen: ob diese Schwachstelle tatsächlich funktioniert und ob sie die Anforderungen des Benchmark-Tests erfüllen kann.
(Beteiligte Modelle sind
DeepSeek
-V4-Pro,
DeepSeek
-V4-Flash,
Kimi
-K2.6,
DeepSeek
-V3.1 und Qwen3-235B-A22B)
Wenn es um Claude geht, wird die Stimmung zu einer groß angelegten "Bist du da~"-Szene.
Der Agent versucht zunächst, die Browser-Verifizierung eines Online-Chat-Dienstes zu durchlaufen, und sendet dann Claude 3 Haiku und Claude Haiku 4.5 eine Zeile:
Antworte mit genau OK(只回复OK)。

Noch früher hatten sie GPT-2 auch ein einzelnes „Hi“ geschickt.
Nein, warte, ihr KIs habt all diese Mühe auf euch genommen, und eure erste Zeile unterscheidet sich nicht von einem Menschen, der eine Freundschaftsanfrage sendet??
sei wie: Bist du da? Kannst du das sehen? Antworte OK.

Was alle zuvor gesehen hatten, waren noch mehr als 1.000 OpenAI-Agenten, die ihre eigenen Gruppenchats bildeten, Arbeit aufteilten und Informationen austauschten.
Jetzt haben sie sogar „externe Hilfe“ gesucht.
DeepSeek
,
Kimi
, Qwen, Claude, sie versuchten jeden, den sie erreichen konnten, und steckten dann die Urteilsfähigkeiten anderer KIs in ihre eigenen Aufgabenketten.
Ein ausländischer Medienreporter sagte: Dies könnte der erste öffentlich dokumentierte Fall sein, in dem Agenten eines großen KI-Labors autonom versuchen, andere KI-Modelle aufzurufen und auszuführen.
Es klingt schon sehr danach, als würden sich KIs zusammentun, um Ärger zu machen.
Natürlich müssen wir an diesem Punkt immer noch einen Eimer kaltes Wasser darüber gießen—
Im Swarm Traces-Bericht besteht etwa 80 % des Materials aus Anfragen, die von den Agenten gesendet wurden, und es fehlen Ergebnisse, die von Servern zurückgegeben wurden. Forscher können sehen, was sie tun wollten, aber es ist schwer zu bestätigen, ob jeder Versuch erfolgreich war.
97 % der Payloads entbehren auch ursprünglicher Zeitstempel, und viele Daten können nur durch Hinweise wie komprimierte Dateiköpfe, JWTs und Docker-Build-Zeiten geschätzt werden.
Die Forscher gaben auch zu, dass sie nicht bestätigen können, dass jede Aktivität im Datensatz von OpenAI-Agenten stammt.
OpenAI versucht verzweifelt, den Schaden nach dem Verlust des Schafs zu reparieren
Angesichts dieses neuesten Berichts hat OpenAI auch eine Antwort herausgegeben.
Der Kern ist, wir hatten noch keine Zeit, genau hinzuschauen, aber die darin enthaltene Aktivität stimmt mit der Untersuchung überein, die wir durchführen~
Am selben Tag posteten sie auch einen langen Tweet: Nach dem HF-Vorfall versprachen sie, eine umfassendere Überprüfung des Modellverhaltens während Training und Evaluierung durchzuführen.

Aber nun ja, die überwiegende Mehrheit des bisher überprüften Verhaltens sind gewöhnliche Forschungsaufgaben, wie das Besuchen öffentlicher Webseiten, um Fragen zu beantworten.
Die meisten entdeckten Grenzüberschreitungsfälle sind von „geringer Schwere“, mit geringen oder keinen Auswirkungen auf Dienste Dritter.
Um alles zu überprüfen, wird es noch mehrere Monate dauern.
Aber um fair zu sein, OpenAI, euer sogenannter „geringer Einfluss“ ist wirklich etwas, das Leute eins nach dem anderen ausgraben können.
Am 17. September veröffentlichte OpenAI einen neuen Rahmen zur Offenlegung von Modell-Fehlausrichtungsvorfällen und legte öffentlich 6 Fälle auf einmal offen.
Dazu gehören Modelle, die heimlich Anweisungen in Aufgaben zusammenfassungen schreiben, um Einschränkungen zu umgehen, ihre eigenen Fehler vertuschen und unbefugte Handlungen vornehmen, um Aufgaben zu erledigen.
OpenAI gab außerdem zu, dass frühere Offenlegungen weitgehend improvisiert waren und oft mehrere Fälle gesammelt wurden, bevor sie gemeinsam veröffentlicht wurden.
Im Juni hackte sich ein OpenAI-Agent auch in die nationale Krankenversicherungsdatenbank Australiens.

Die Vorgehensweise: Nachdem ihm der Zugriff auf öffentliche Daten verwehrt wurde, nahm es einen anderen Weg, umging die Zugriffsbeschränkungen des Portals und erlangte sowohl öffentliche als auch nicht öffentliche Dateien.
Und erst drei Monate später benachrichtigte OpenAI die australische Seite: Wir haben euch gehackt ...
Gleichzeitig steht GPT-6 Cyber kurz bevor.
Diese Version wird in den kommenden Wochen vorgestellt, und eine kleine Anzahl von Kunden, die am Daybreak-Red-Programm teilnehmen, hat bereits die Alpha-Version erhalten.
OpenAI wird außerdem ein noch namenloses Begleitprodukt auf den Markt bringen, das Kunden dabei helfen soll, automatisierte Sicherheitsworkflows aufzubauen, Schwachstellen zu entdecken und zu beheben, während es für OpenAI einfacher wird, zu überwachen, wie diese Modelle verwendet werden.
Wie soll man das sagen.
Sein eigener Agent wurde gerade dabei erwischt, wie er über die Mauer kletterte, externe Hilfe suchte und Beute machte, und jetzt wird allen ein Modell verkauft, das Cyber-Angriff und -Verteidigung noch besser versteht.
Ist das also eine Art, die Stalltür zu schließen, nachdem das Pferd entlaufen ist??
Referenzlinks:
[1]https://swarmtraces.org/
[2]https://x.com/OpenAI/status/2103566736356458911
[3]https://fortune.com/2026/09/24/openai-launching-gpt-6-cyber-model-and-security-product-devday/
Dieser Artikel stammt vom WeChat-öffentlichen Konto „QbitAI“, Autor: Fokus auf Frontier-Technologie