
In Kürze
- Claude Opus 5.5 wurde am Dienstag eingeführt und kostet 4 US-Dollar bzw. 20 US-Dollar pro Million Input- und Output-Token, 40 % günstiger als Opus 5 bei Standardeinstellungen, während Anthropic angibt, dass es bei den meisten Aufgaben mit Fable 5.1 mithält.
- Nach Anthropics eigenen Zahlen führt Opus 5.5 Fable 5.1 und Opus 5 bei Coding- und Knowledge-Work-Tests an, aber GPT-6 Astra schlägt es weiterhin bei AutomationBench und Terminal-Bench-Science 0.1.
- Es ist das erste Modell, das Anthropic seit dem Aufruf von CEO Dario Amodei an die Branche, das Tempo der KI-Fähigkeitsgewinne zu verlangsamen, veröffentlicht hat, und es trägt dieselben Cybersicherheits- und Biologieschutzmaßnahmen wie Fable 5.1.
Anthropic veröffentlichte Claude Opus 5.5 am Dienstag, das erste Modell in der von dem Unternehmen als Claude 5.5-Familie bezeichneten Reihe. Anthropic gibt an, dass das neue Modell bei den meisten Aufgaben auf dem Niveau von Claude Fable 5.1, seinem teuersten Flaggschiff, abschneidet.
Der Clou ist, dass das Modell 20 % weniger kostet als Opus 5, das Modell, das es ersetzt, und es ist 60 % günstiger als Fable 5.1, das modernste Angebot des Unternehmens.
Das Modell scheint sehr leistungsfähig zu sein. Es ist das fortschrittlichste Modell sowohl in der Version (5.5 vs. Fables 5.1) als auch in der Familie (Opus ist das größte öffentlich verfügbare Modell, gefolgt von Sonnet, wobei Haiku das kleinste ist).
Anthropic gibt zu, dass die Lücke zwischen Fable und Opus kleiner ist, als es die Benchmark-Ergebnisse vermuten lassen, aber die öffentliche Verfügbarkeit im Rahmen des Tarifs und die niedrigeren Kosten pro Token machen dies zur offensichtlichen Wahl für die meisten Claude-Nutzer.
Opus 5 wurde im Juli eingeführt, unterbot den Preis und übertraf Fable 5 bei den meisten Benchmarks, und Fable 5.1 erschien Anfang September und kehrte dies um, indem es Opus 5 bei jedem von Anthropic veröffentlichten Benchmark übertraf.
Opus 5.5 schließt die Lücke erneut, diesmal beim Preis statt bei den Rohwerten. Lovable, eine Entwicklerplattform, die Opus 5 im Juli durch eigene Codetests laufen ließ, erklärte in einer von Anthropic geteilten Stellungnahme, das frühere Modell sei „stetiger, mit weit weniger Varianz von Lauf zu Lauf“ gewesen als das, was davor kam – dieselbe Effizienz-Botschaft, die Anthropic auch jetzt wieder verbreitet.
Opus 5.5 ist außerdem das erste Modell, das Anthropic seit der Veröffentlichung eines Essays von CEO Dario Amodei ausgeliefert hat, in dem er die Branche dazu aufrief, langsamer zu werden, und argumentierte, dass die Fortschritte bei den KI-Fähigkeiten die Sicherheitstests, die sie im Zaum halten sollen, überholen. „Wir müssen das Tempo verlangsamen, in dem wir die Fähigkeiten von KI-Modellen verbessern“, schrieb Amodei Anfang dieses Monats.
Anthropic misst den größten Teil dieses Fortschritts anhand von agentischem Coding – Arbeit, die von einem KI-Agenten ausgeführt wird, einem Modell, das selbstständig mehrstufige Aktionen ausführt, anstatt nur eine einzelne Eingabeaufforderung zu beantworten.
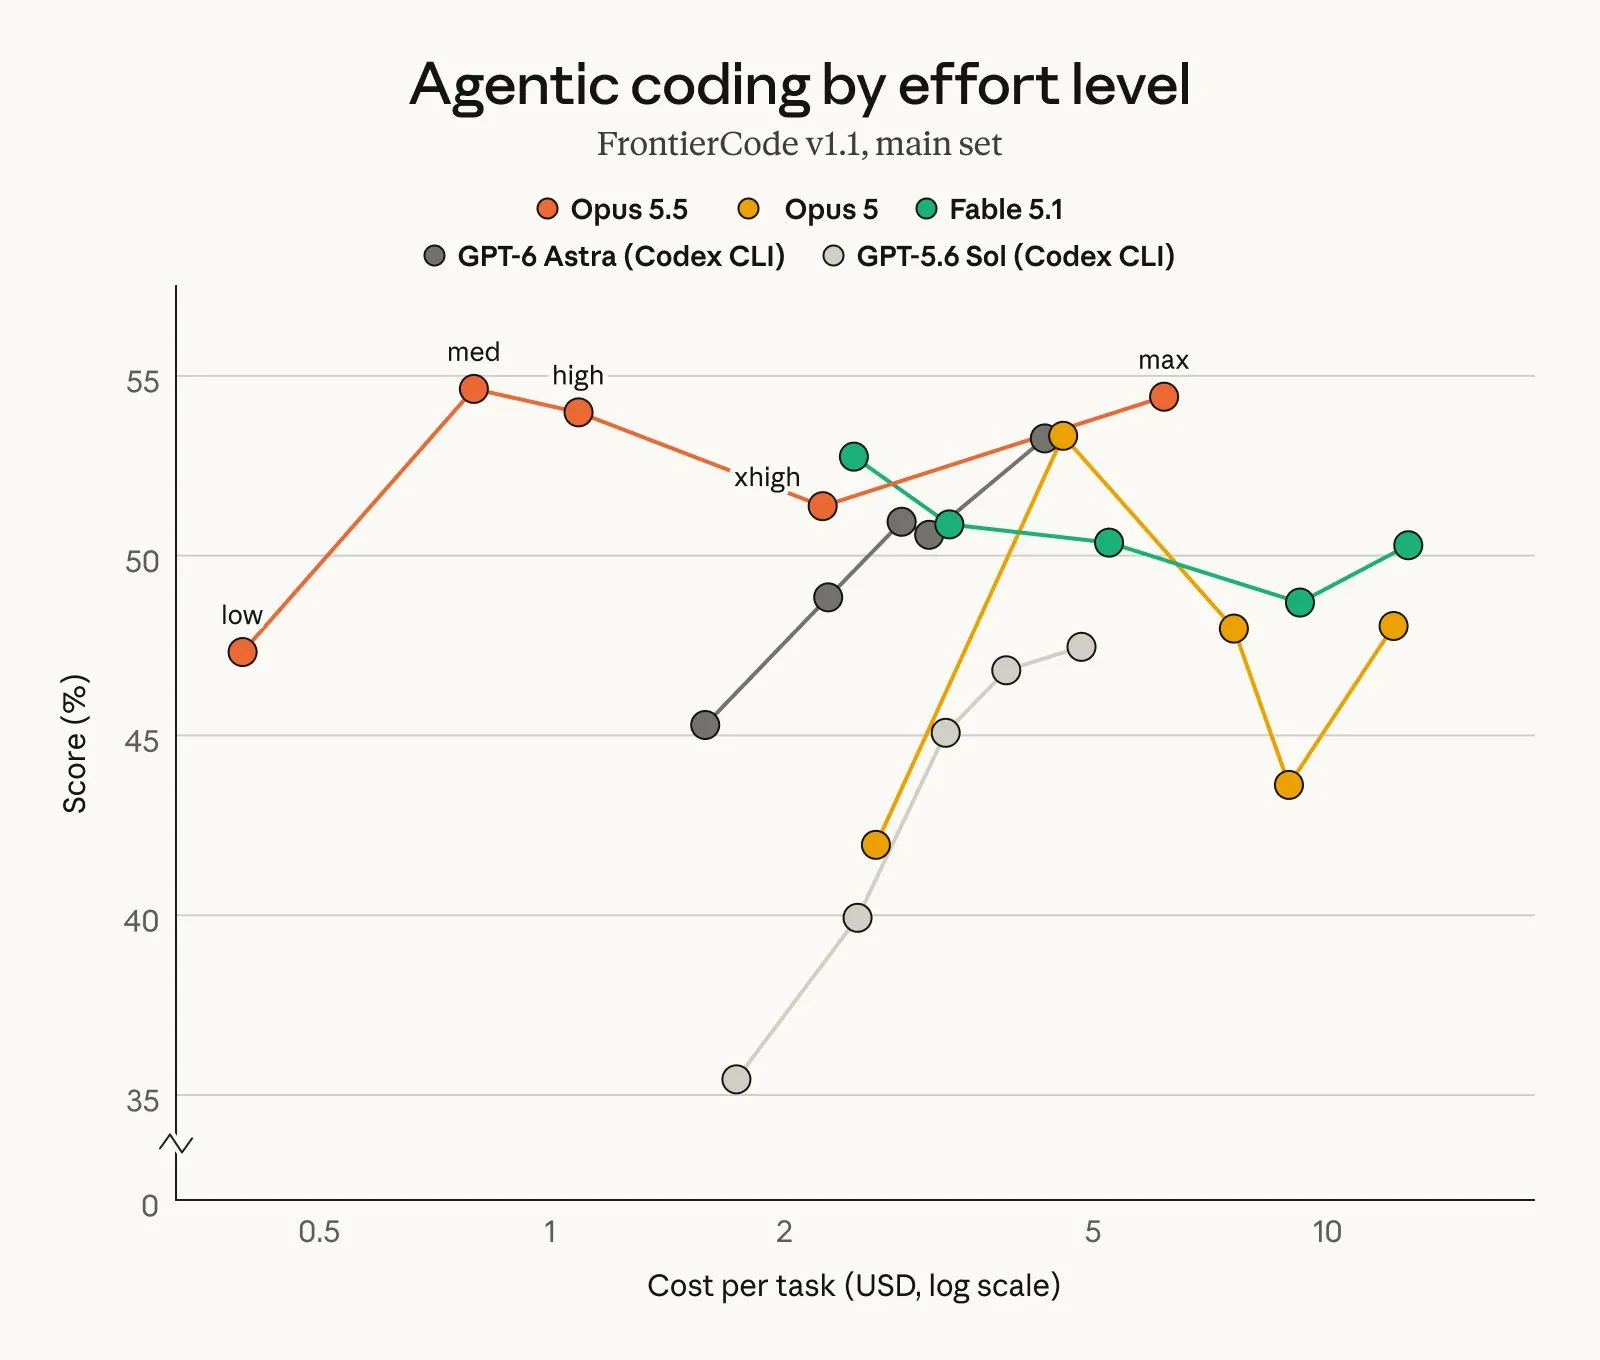
Bei Terminal-Bench 4.0, das testet, ob ein Agent komplexe professionelle Aufgaben in einer Kommandozeilenschnittstelle abschließen kann, und das Ergebnis als Prozentsatz der abgeschlossenen Aufgaben bewertet, erreichte Opus 5.5 66,4 % und lag damit vor Fable 5.1 mit 55,8 % und GPT-6 Astra mit 57,9 %. FrontierCode, das prüft, ob die Codeänderungen eines Agenten tatsächlich in einer realen Engineering-Pipeline zusammengeführt würden, wobei dieselbe Bewertung nach Bestehensquote verwendet wird, ergab für Opus 5.5 54,4 % gegenüber 50,3 % für Fable 5.1.
Bei GDPval-AA v2.1, das reale professionelle Arbeit in 44 Berufen anhand von Elo bewertet – demselben schachähnlichen Rankingsystem, das verwendet wird, um relative Fähigkeiten statt einer flachen Prozentzahl zu messen –, erzielte Opus 5.5 1846 gegenüber 1735 für Fable 5.1 und 1708 für Opus 5.
Opus 5.5 führt jedoch nicht überall. Bei AutomationBench, einem von Zapier entwickelten Benchmark, der bewertet, ob ein Agent einen vollständigen Geschäftsworkflow von Anfang bis Ende ohne menschliche Hilfe bewältigen kann, liegt GPT-6 Astra mit 41,4 % knapp vor Opus 5.5 mit 40,0 %.
Bei Terminal-Bench-Science 0.1, das agentische wissenschaftliche Forschung in einer Kommandozeilenumgebung mit derselben Methode der Bestehensquote testet, schlägt Astra mit 64,6 % Opus 5.5 mit 58,7 % mit einem größeren Abstand.
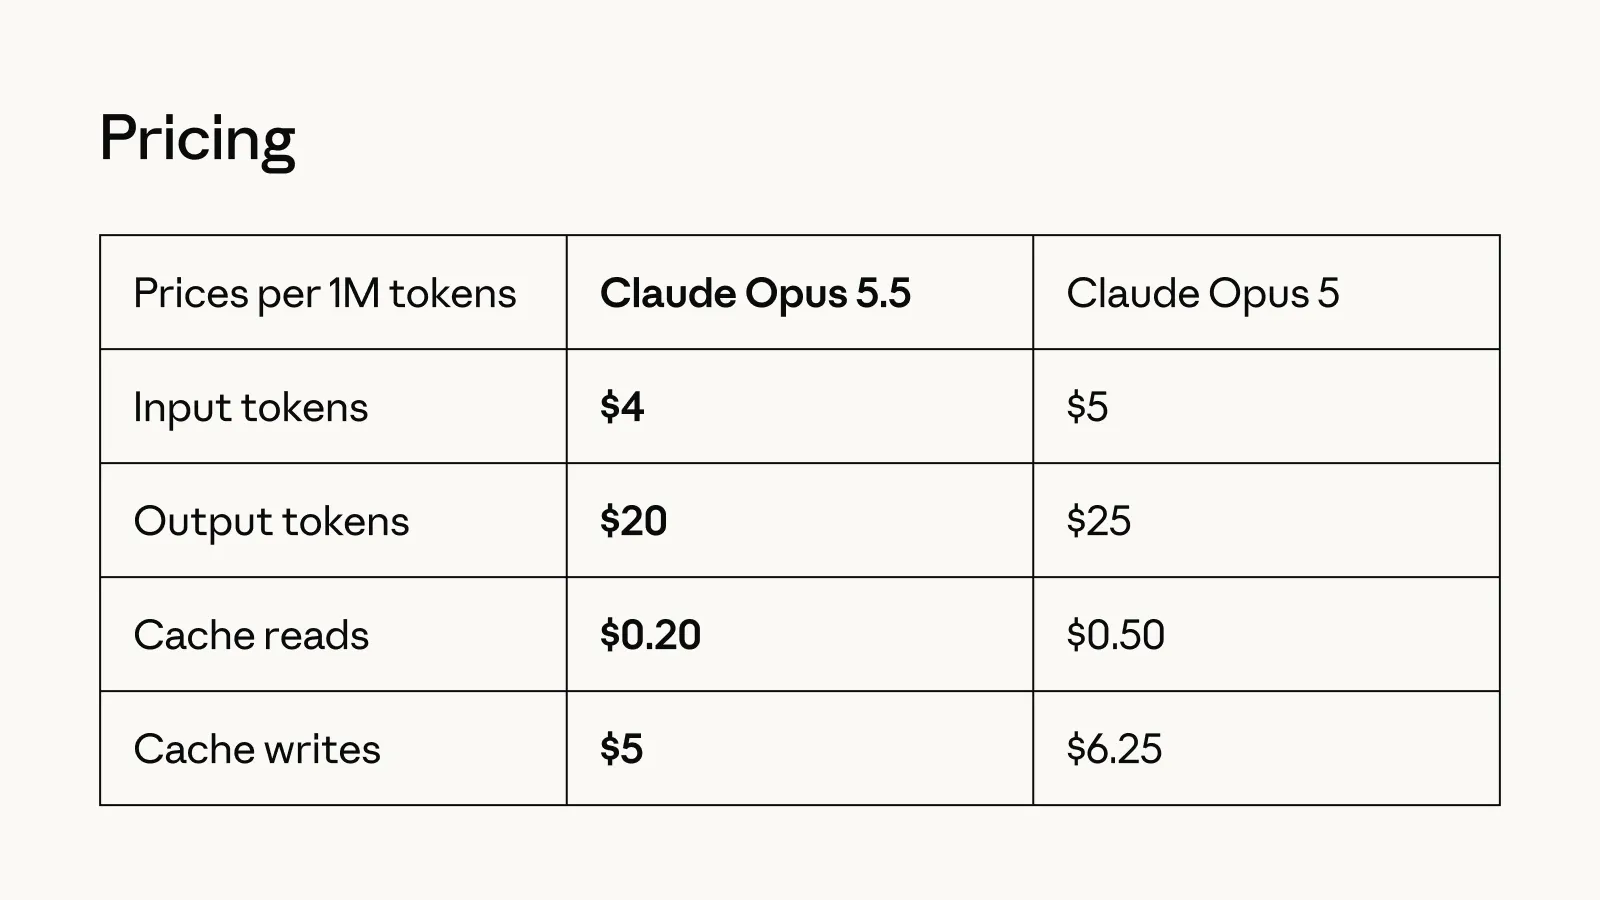
Der größere Verkaufsvorteil sind die Kosten. Input-Tokens – die Textblöcke, die ein Modell liest und schreibt, pro Million berechnet – kosten jetzt 4 $ für Opus 5.5 gegenüber 5 $ für Opus 5, und die Output-Tokens sinken von 25 $ auf 20 $. Cache-Lesevorgänge, bei denen ein Kontext wiederverwendet wird, den ein Modell bereits verarbeitet hat, anstatt ihn von Grund auf neu zu verarbeiten und den Großteil der Kosten bei langen agentischen Codierungssitzungen zu verursachen, fallen um 60 % auf 0,20 $ pro Million Tokens.
Da Opus 5.5 bei diesen beiden Fähigkeiten mit den Modellen der Mythos-Klasse von Anthropic übereinstimmt – der am stärksten eingeschränkten Stufe des Unternehmens, die geprüften Cybersicherheits- und Biologieforschern vorbehalten ist –, wird es mit denselben Schutzmaßnahmen wie Fable 5.1 eingeführt.
Die meisten Cybersicherheitsaufgaben werden automatisch zum älteren Opus 4.8 umgeleitet, worüber sich viele Entwickler und Nutzer zuvor beschwert haben..
Opus 5.5 ist jetzt auf allen Plattformen von Anthropic verfügbar, einschließlich Amazon Web Services, Google Cloud und Microsoft Azure. Sonnet 5.5 und Haiku 5.5 werden laut Anthropic in den kommenden Wochen folgen und dieselben Preissenkungen auf den Rest der Produktpalette übertragen.





