「從全球資源配置的角度來看,讓每個人把緊缺的 DRAM 囤在自己電腦裡大部分時間閒置,是『相當糟糕』(quite terrible)的安排,記憶體應該集中到雲端資料中心去。」

話都說到這份上了。
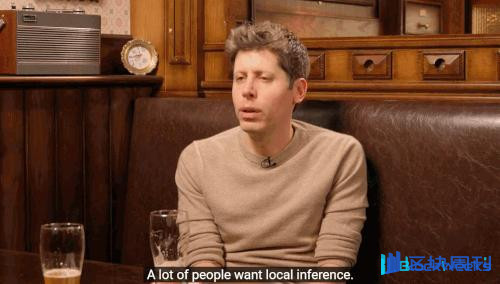
本週四在接受 YouTube 頻道 Cheeky Pint 的採訪時,OpenAI CEO 山姆・奧特曼(Sam Altman)全程喝著啤酒,氣氛輕鬆地聊了聊 AI 大模型的本機推理,以及由此延伸出的家用電腦記憶體不足的問題,不經意間爆典了。
我們知道,目前全球 AI 浪潮引發的記憶體漲價,已經讓 PC 和手機的價格暴漲了一圈,個人消費者早已難以承受。與此同時,各家記憶體大廠的產能擴張還要等一陣子。就在前沿 AI 公司吃下記憶體大頭的同時,他們卻已經開始討論起個人電腦中的記憶體是否得到充分利用。
奧特曼提到一個假設,即人們能夠在自己的電腦上執行本機人工智慧,這些電腦可能是他們已經擁有的,也可能是因為 AI 大模型技術興起,他們想要組裝的。他認為這是一個糟糕的想法。
「從全球資源分配的角度來看,讓每個人都把全球有限的 DRAM 記憶體閒置在自己的電腦裡,而使用率只有 5%,這其實非常糟糕,」奧特曼說道。「如果你想在這種資源供應極其緊張的環境下工作,那麼在雲端就應該盡可能提高資源利用率。但不知為何,很多人的直覺卻恰恰相反。」
如今,OpenAI 的主要業務基於在大規模資料中心執行的閉源模型,他為自家商業模式的辯護引發了 AI 社群的一片爭論。
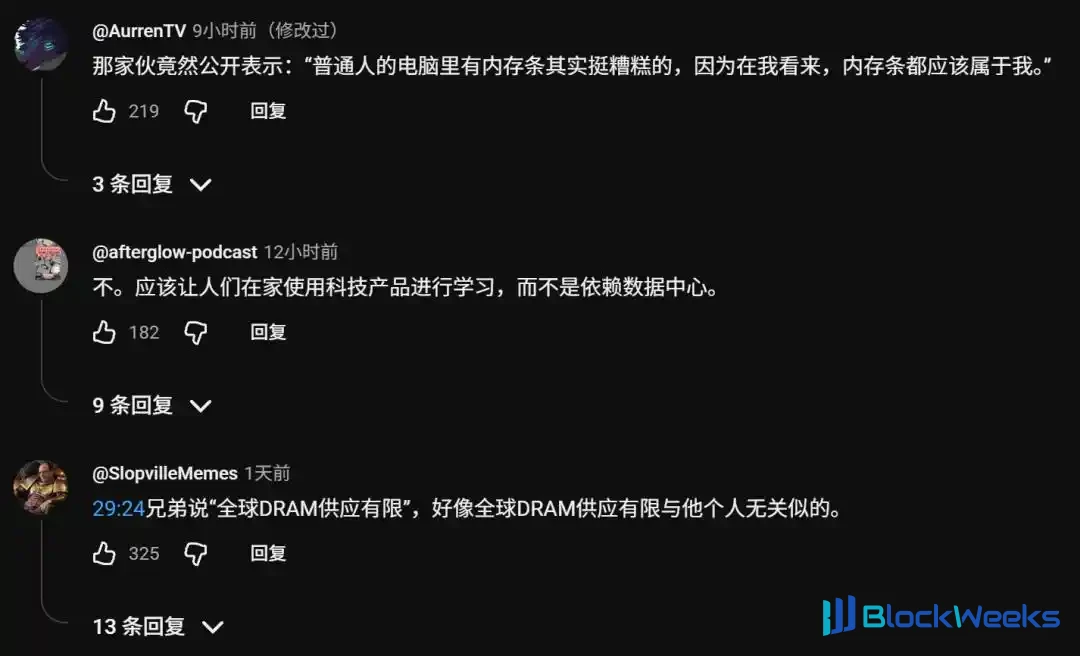
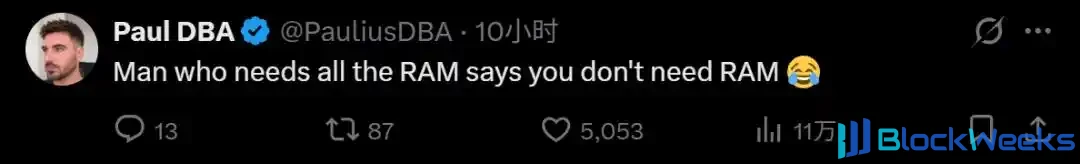
這也引發了不少人的擔憂:未來我們可能更難擁有自己的硬體或軟體,只能考慮去租用雲端的智慧體和電腦。
雖然普通 PC、手機和 AI 加速卡使用的記憶體並不相同,但它們的生產會競爭部分上游晶圓產能。奧特曼討論的是全球 DRAM 的資源配置,要說到誰有資格決定記憶體產能用在哪裡,大多數時候自然是下更大訂單的那個使用者。
奧特曼的部分觀點基於資料中心建設不會放緩的假設。此外他還假設,全天候用於 AI 資料中心的記憶體比用於電子表格、網頁瀏覽、遊戲,甚至偶爾用於本機 AI 的記憶體更有價值。
其實這次的訪談很長,奧特曼聊的還包括這兩週引爆全球恐慌的 PHP 漏洞、訓練模型的沙箱化以及 AI 在數學領域的研究。
看看他主要說了什麼:
AI 正在引爆漏洞潮
有關 PHP 超級巨大的漏洞,奧特曼的判斷是:大模型發現漏洞的能力持續快速提升,而網際網路上的程式碼面極其龐大,當人們開始系統性地用 AI 掃描所有程式碼,「我們會發現自己身處一個嚴重漏洞遠超預期的世界」。他認為光打補丁不夠,必須重構架構,路由器、作業系統、應用層都需要為「漏洞會越來越智慧」的世界重新設計。兩年前「重寫整個技術棧」還像瘋話,現在已出現要做全新 stack 的創業公司。
他罕見地做了行業自我批評:「我不認為我們很好地向人們解釋了,為什麼這項技術所有潛在的下行風險是值得的。」他說 AI 行業的敘事是糟糕的銷售話術,一邊承諾治癒癌症、降低成本,一邊又描繪失業、失控、需要強力監管的未來。他重申 OpenAI 堅持迭代部署(iterative deployment)、對抗能力懸置(capability overhang),理由是不能讓「舊金山幾平方英里的人做所有決定」。
當被問及能否給模型建一個「最高安全級別的監獄」,奧特曼給出了悲觀回答:沙箱只在一定程度內有效,監控(包括思維鏈審查和激活監控)能再進一步,但最終必須高度信任對齊。他反問道,面對一個比最聰明的安全研究員還聰明百萬倍、能發現人類尚不懂的新科學的模型,你真敢信任那個沙箱嗎?
他明確說自己討厭「agent swarms(蜂群)」這個詞,因為 swarm 讓人聯想到蝗蟲,堅持叫 agent teams(智慧體團隊),並認為團隊之間互相制衡的屬性,恰好對應靠多元主義實現魯棒性的機制,是值得推進的安全方向。
智力爆炸與科學發現的代價
奧特曼勾勒了一條曲線:GPT-4 時代,往單個問題上有效投入 1 美元算力都難;思維鏈(chain of thought)讓模型能「用力思考」,如今我們卻可以把整支智慧體團隊並行上萬次。普通使用者和最先進使用者之間的使用差距,正在不斷拉大。
關於 OpenAI 內部如何分配算力,他說員工享有很大自由度,但從不獎勵高 token 消耗,「token 排行榜高其實有點丟人,肯定不是晉升理由」。納維 – 斯托克斯(Navier-Stokes)方程的證明被他拿來當案例:單個證明約耗資 1000 萬美元,期間「失控了一週」,因為當時大家對智慧體團隊的擴展律一無所知。但他預計一年後用更聰明的模型和方法,1/100 的成本就能重做。
他還罕見地流露了情緒:當時的情況真是絕了,某個新模型內部上線的週末,大家把各種最棘手的難題拋給這個模型,而它竟然都能一一解決。人們原本根本沒指望模型能做到這些。大家共同見證了許多人學術生涯中最難攻克的科研難題被這個模型一個接一個地解決了,而且涵蓋了多個不同的領域,那場面簡直令人驚嘆。
「有兩晚我幾乎徹夜未眠,因為實在太興奮了,根本睡不著。我們後來發表的很多成果,其實就是當時解決的那些難題。」
奧特曼當時感到無比興奮和快樂,同時也湧現出一種意想不到的憂傷、惆悵,以及一種「某個時代正在終結」的感覺。不止是懷舊,還有一種對於對人類科學家們「朝聞道,夕死可矣」的共情。他堅持人類理應獲得基礎知識,但行業欠這些領域的從業者一個解決方案。
雖然現在談論超級智慧還為時尚早,不過奧特曼認為萬億個小超人類,勝過一個萬億 IQ:
“I would much rather intuitively have a trillion AIs of slightly superhuman intelligence join society than one AI of one trillion IQ join society.”
「直覺上,我更願意讓一萬億個略具超人類智能的 AI 加入社會,而不是一個萬億 IQ 的 AI 加入社會。」
他的論證是:社會的強大魯棒性來自大量成員互相制衡、協作,「單腦」世界沒有這種韌性。但他強調這不會自動發生,必須主動推動。
市場調節,到 AI 時代玩不轉了?
有關全球記憶體緊缺的問題,奧特曼介紹了 OpenAI 的佈局:自研晶片(提升每瓦智能性能)、自建資料中心、機器人專案,以及一個更大膽的概念「自我複製的資料中心」,要用 AI 控制機器人去營運晶圓廠、造渦輪和太陽能板、建資料中心。他表示「這已在我們掌握之中」。
談到「市場自己調節」為何遲遲不兌現,他認為當前的進展很糟糕,並給出記憶體廠商的行為邏輯:這個行業長期是投 200 億美元 capex 賺 19 億的苦生意,歷史上多次有巨頭因過度建廠而差點破產。如今每家一年能賺約 1000 億美元自由現金流,但慘痛記憶讓他們擴產極度保守。他由此斷言「看不見的手現在失靈了」。
他區分了晶片產業的兩類能力:光刻「地球上似乎只有一家公司知道怎麼做」,但晶片設計(最終送給晶圓廠的檔案)已是 AI 的絕佳用武之地。
談到遞迴自我改進(RSI)的真實水平,奧特曼表示,現在模型能完成「找 5% 計算效率提升」這類任務,但還沒有人知道如何讓 AI 發現像 transformer 那樣級別的新架構,缺的是更聰明的模型。他甚至預告,社會可能需要在一段時間內同意限制單模型的智商,「若未來的進展不足,那將源於這個決定,而非 AI 做研究的能力」。
他亮出了自己的通縮信仰:當前每 GW 領先 AI 算力的 5 年總擁有成本約 700 億美元,若能降到 200 億會更理想,同時模型每年還要再提升 10 倍性能。實現的路徑是讓能源更便宜、壓縮「從沙子到產出 token」之間層層堆疊的毛利。
針對企業的 token 預算焦慮,他認為當前更普遍的問題是 AI 用得不够多,而不是用太多。
個人智能體怎麼定價?
關於最近火熱的個人智能體產品(如 Muse),奧特曼當前的判斷是「Macintosh 時刻還沒有到來」。人們喜歡這些產品,但還沒到「無法想像沒有它的生活」,贏家的形態會像現在的產品,但「it’ll just work」,可靠、能接住更複雜的任務。computer use 的貓鼠遊戲,他認為最終會收斂在「你有權讓 AI 代表你操作自己的電腦」的程度。
有關智能體的商業化方式,奧特曼認為,企業死守自己產品裡的 AI 彈窗和 HTML,擔心失去客戶關係,但消費者想在自己的主聊天應用裡面讓 AI 代辦一切。他認為真正的護城河來自品牌、選品和履約網路,而非 HTML。他主動自曝說:自己 10 次有 10 次選 Amazon Pay,哪怕價格更高,並盛讚亞馬遜的履約網路,同時承認 ChatGPT 內的合作平台做得還不够好。他還把所有網頁表單稱為「假工作」(fake work),並把當下類比為當年的 App Store 時代。
也正是因為如此,在設計定價時,OpenAI 差點學 AWS 按任務報價、徹底拋棄 token 計費的方式,但遭到了客戶們的強烈反對:「我需要知道自己在為什麼付錢」,哪怕付更多也要 token 這種可理解的單位。
參考內容:
https://www.tomshardware.com/tech-industry/data-centers/openai-ceo-says-its-quite-terrible-for-your-pc-to-have-ram-sam-altman-says-data-centers-offer-better-utilization
https://www.youtube.com/watch?v=iMsUcCYNKqY
本文來自微信公眾號 「機器之心」(ID:almosthuman2014),作者:澤南