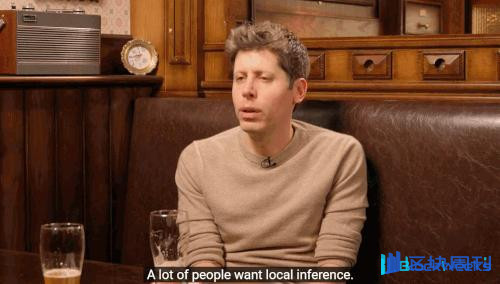
"З точки зору глобального розподілу ресурсів, ситуація, коли кожен зберігає дефіцитну DRAM у своєму власному комп'ютері, який більшість часу простоює, є «досить жахливою»; пам'ять має бути зосереджена в хмарних центрах обробки даних."

Він справді туди пішов.
Цього четверга в інтерв'ю для YouTube-каналу Cheeky Pint генеральний директор OpenAI Сем Альтман увесь час пив пиво, у розслабленій атмосфері розмовляв про локальний інференс великих ШІ-моделей і спричинену цим проблему недостатнього обсягу пам'яті в домашніх комп'ютерах, і ненароком скинув бомбу.
Як відомо, стрибок цін на пам'ять, спричинений нинішньою глобальною хвилею ШІ, вже призвів до різкого зростання цін на ПК і смартфони, зробивши їх недоступними для окремих споживачів. Водночас розширення потужностей провідними виробниками пам'яті потребує часу. Саме тоді, коли передові ШІ-компанії забирають левову частку пам'яті, вони вже почали обговорювати, чи повністю використовується пам'ять у персональних комп'ютерах.
Альтман згадав гіпотетичний сценарій, у якому люди могли б запускати локальний ШІ на своїх власних комп'ютерах — комп'ютерах, які вони, можливо, вже мають, або які хочуть зібрати через піднесення технології великих ШІ-моделей. Він вважає, що це погана ідея.
«З точки зору глобального розподілу ресурсів, ситуація, коли кожен залишає обмежену світову DRAM простоювати у своєму власному комп'ютері з використанням лише на 5%, насправді є досить жахливою,» — сказав Альтман. «Якщо ви хочете працювати в середовищі, де пропозиція цього ресурсу надзвичайно обмежена, то в хмарі ви повинні максимізувати використання ресурсів. Але чомусь інтуїція багатьох людей є прямо протилежною».
Сьогодні основний бізнес OpenAI базується на моделях із закритим кодом, що працюють у великомасштабних центрах обробки даних, і його захист бізнес-моделі своєї компанії викликав дискусію в усій ШІ-спільноті.
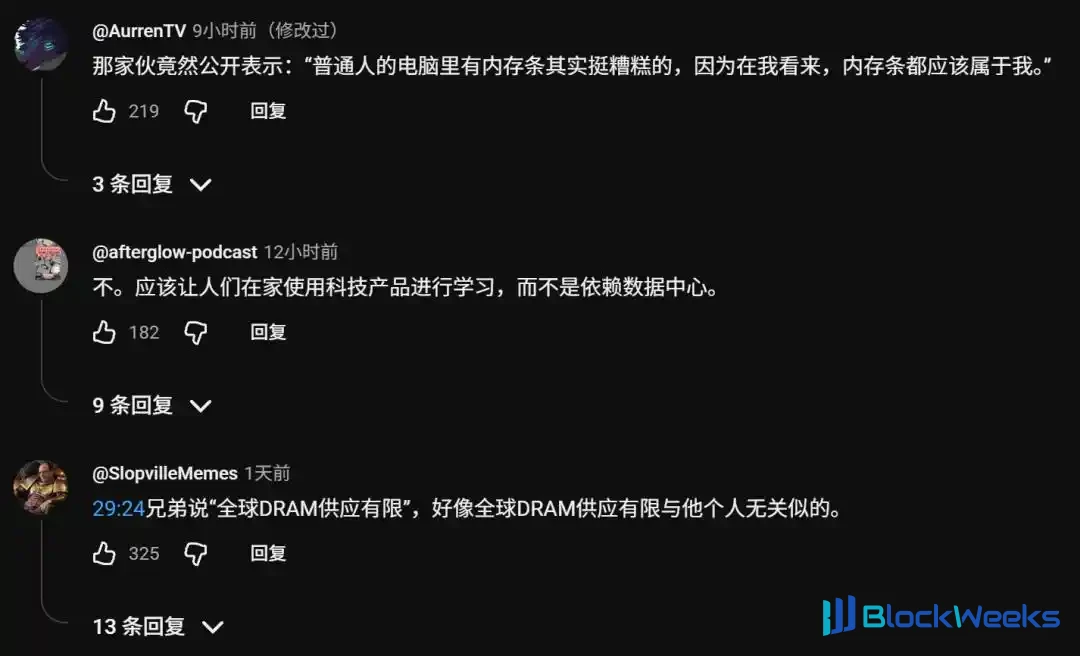
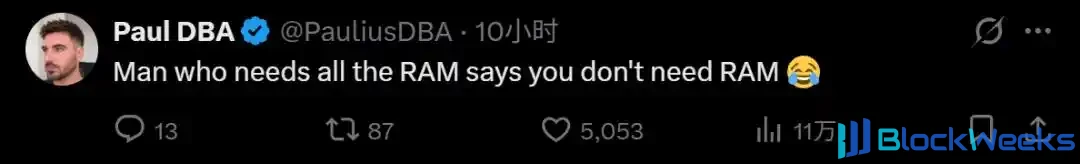
Це також викликало занепокоєння в багатьох: у майбутньому нам може стати ще важче володіти власним апаратним чи програмним забезпеченням, і ми, можливо, зможемо лише розглядати оренду хмарних агентів і комп'ютерів.
Хоча пам'ять, яку використовують звичайні ПК, смартфони та карти ШІ-прискорювачів, не є однаковою, їхнє виробництво конкурує за частину потужностей верхнього рівня з виробництва пластин. Альтман обговорює розподіл глобальних ресурсів DRAM, і коли йдеться про те, хто має право вирішувати, де використовуватимуться потужності з виробництва пам'яті, здебільшого це, природно, клієнт, який розміщує більше замовлення.
Деякі погляди Альтмана ґрунтуються на припущенні, що будівництво центрів обробки даних не сповільниться. Він також припускає, що пам'ять, яка використовується цілодобово для ШІ-центрів обробки даних, є ціннішою, ніж пам'ять, яка використовується для електронних таблиць, перегляду вебсторінок, ігор або навіть для випадкового локального ШІ.
Насправді це інтерв'ю було дуже довгим, і Альтман також говорив про вразливість PHP, яка спричинила глобальну паніку протягом останніх двох тижнів, про пісочниці для навчання моделей і про дослідження ШІ в математиці.
Погляньмо, про що він переважно говорив:
ШІ спричиняє хвилю вразливостей
Щодо величезної вразливості PHP, судження Альтмана таке: здатність великих моделей виявляти вразливості продовжує швидко зростати, а поверхня коду в інтернеті надзвичайно велика. Коли люди почнуть систематично використовувати ШІ для сканування всього коду, «ми опинимося у світі, де серйозних вразливостей набагато більше, ніж очікувалося». Він вважає, що самого лише виправлення недостатньо і що архітектури потрібно перебудовувати — маршрутизатори, операційні системи та прикладний рівень — усе потрібно перепроєктувати для світу, де «вразливості ставатимуть дедалі розумнішими». Два роки тому «переписати весь технологічний стек» ще звучало божевіллям; тепер уже з'явилися стартапи, які прагнуть побудувати цілком нові стеки.
Він рідко вдавався до самокритики галузі: «Я не думаю, що ми добре пояснили людям, чому всі потенційні ризики цієї технології варті того». Він сказав, що наратив ШІ-індустрії — це поганий продаж: з одного боку, обіцяють вилікувати рак і знизити витрати, а з іншого — малюють майбутнє безробіття, втрати контролю та потреби в жорсткому регулюванні. Він повторив, що OpenAI наполягає на ітеративному розгортанні та протистоянні надлишку можливостей, тому що «кілька квадратних миль людей у Сан-Франциско» не повинні ухвалювати всі рішення.
На запитання, чи можна побудувати для моделей «в'язницю максимально суворого режиму», Альтман дав песимістичну відповідь: пісочниці ефективні лише до певної міри, а моніторинг (включно з перевіркою ланцюжка думок і моніторингом активацій) може зайти далі, але зрештою має бути високий рівень довіри до вирівнювання.Він запитав у відповідь: коли ви стикаєтеся з моделлю, яка в мільйони разів розумніша за найрозумнішого дослідника безпеки, здатною відкривати нову науку, якої люди ще не розуміють, чи справді ви наважилися б довіряти цій пісочниці?
Він прямо сказав, що ненавидить термін «рої агентів», тому що рій викликає асоціації з сараною, і наполягав на тому, щоб називати їх командами агентів. Він вважає, що взаємне стримування та противаги між командами точно відповідають механізму досягнення стійкості через плюралізм, і що це напрям безпеки, вартий того, щоб його досліджувати.
Вибух інтелекту та ціна наукових відкриттів
Альтман окреслив криву: в епоху GPT-4 було важко ефективно витратити навіть 1 долар обчислень на одну проблему; ланцюжок думок дозволив моделям «напружено думати», а тепер ми можемо запускати цілу команду агентів паралельно десятки тисяч разів. Розрив у використанні між звичайними користувачами та найпросунутішими користувачами постійно зростає.
Щодо того, як OpenAI розподіляє обчислення всередині компанії, він сказав, що працівники мають велику свободу, але високе споживання токенів ніколи не винагороджується: «Бути високо в таблиці лідерів за токенами насправді трохи незручно; це точно не причина для підвищення». Він навів як приклад доведення рівнянь Нав'є — Стокса: одне доведення коштувало близько 10 мільйонів доларів, і протягом того періоду все «вийшло з-під контролю на тиждень», тому що на той час ніхто нічого не знав про закони масштабування команд агентів. Але він очікує, що через рік, із розумнішими моделями та методами, це можна буде повторити за 1/100 вартості.
Він також рідко виявляв емоції: ситуація на той час була справді неймовірною. У вихідні, коли певна нова модель запускалася всередині компанії, усі закидали моделі найрізноманітніші найскладніші проблеми, і вона справді розв'язувала їх одну за одною. Люди зовсім не очікували, що модель здатна на такі речі. Разом вони стали свідками того, як багато найскладніших науково-дослідницьких проблем у наукових кар'єрах людей були одна за одною розв'язані цією моделлю, охоплюючи кілька різних галузей, і сцена була просто приголомшливою.
«Дві ночі я майже не спав, бо був настільки схвильований, що просто не міг заснути. Багато результатів, які ми згодом опублікували, насправді були тими проблемами, розв'язаними тоді».
Тоді Альтман відчував надзвичайне хвилювання й радість, водночас переживаючи несподіваний смуток, меланхолію та відчуття «епоха добігає кінця». Це була не просто ностальгія, а й співпереживання духу людських науковців «почути Шлях уранці — і померти задоволеним увечері». Він наполягає, що людство заслуговує на доступ до базових знань, але галузь заборгувала фахівцям у цих сферах рішення.
Хоча говорити про надінтелект ще зарано, Альтман вважає, що трильйон трохи надлюдських ШІ кращі за один із трильйонним IQ:
«Я набагато радше інтуїтивно хотів би, щоб до суспільства приєднався трильйон ШІ з трохи надлюдським інтелектом, ніж один ШІ з трильйонним IQ».
"Інтуїтивно, я б радше мав трильйон ШІ з трохи надлюдським інтелектом, які приєдналися до суспільства, ніж один ШІ з IQ у трильйон, який приєднався до суспільства."
Його аргумент такий: міцна стійкість суспільства походить від великої кількості членів, які стримують і врівноважують одне одного та співпрацюють між собою; світ "єдиного мозку" не має такої стійкості. Але він наголошує, що це не станеться автоматично і це потрібно активно просувати.
Ринкове регулювання більше не працює в епоху ШІ?
Щодо глобального дефіциту пам'яті Альтман представив плани OpenAI: власні розробки чипів (підвищення продуктивності інтелекту на ват), власні центри обробки даних, проєкти робототехніки та ще сміливішу концепцію — "самовідтворювані центри обробки даних", які використовуватимуть ШІ для керування роботами для експлуатації фабрик, будівництва турбін і сонячних панелей та зведення центрів обробки даних. Він заявив, що "це вже в межах нашої досяжності".
На запитання, чому "ринок сам себе регулює" так повільно втілюється, він сказав, що поточний прогрес досить поганий, і навів логіку поведінки виробників пам'яті: ця галузь довгий час була важким бізнесом — інвестувати 20 мільярдів доларів у капітальні витрати, щоб заробити 1,9 мільярда доларів, і історично гіганти неодноразово були близькі до банкрутства через надмірне будівництво заводів. Сьогодні кожна компанія може заробляти близько 100 мільярдів доларів вільного грошового потоку на рік, але болісні спогади роблять їх надзвичайно консервативними щодо розширення виробництва. Тому він стверджував, що "невидима рука зараз дає збій".
Він розрізнив два типи можливостей у напівпровідниковій галузі: щодо літографії "здається, лише одна компанія на Землі знає, як це робити", але проєктування чипів (файли, які зрештою надсилаються на фабрику) вже є чудовим випадком використання ШІ.
Говорячи про реальний рівень рекурсивного самовдосконалення (RSI), Альтман сказав, що моделі тепер можуть виконувати такі завдання, як "знайти 5% покращення обчислювальної ефективності", але ніхто ще не знає, як змусити ШІ відкрити нову архітектуру рівня трансформера; бракує розумніших моделей. Він навіть передбачив, що суспільству, можливо, доведеться протягом певного часу погодитися обмежувати IQ окремої моделі, "і якщо майбутній прогрес буде недостатнім, це походитиме від цього рішення, а не від здатності ШІ проводити дослідження".
Він виклав свою дефляційну віру: поточна п'ятирічна сукупна вартість володіння кожним ГВт провідних обчислювальних потужностей ШІ становить близько 70 мільярдів доларів, і було б ще краще, якби вона могла впасти до 20 мільярдів доларів, тоді як моделі все ще потребують покращення продуктивності ще в 10 разів щороку. Шлях до досягнення цього — зробити енергію дешевшою та стиснути накопичені націнки між "від піску до вихідних токенів".
Щодо занепокоєння підприємств щодо бюджетів на токени, він вважає, що сьогодні поширеніша проблема — не надмірне використання ШІ, а недостатнє його використання.
Як має формуватися ціна персональних агентів?
Щодо нещодавно популярних продуктів персональних агентів (таких як Muse), поточне судження Альтмана таке: "момент Macintosh ще не настав". Людям подобаються ці продукти, але вони ще не досягли точки "я не уявляю життя без цього". Переможна форма буде схожа на поточні продукти, але "вона просто працюватиме", надійна і здатна виконувати складніші завдання. Щодо гри в кішки-мишки з використанням комп'ютера, він вважає, що вона зрештою зійдеться до того, що "ви маєте право дозволити ШІ керувати вашим власним комп'ютером від вашого імені".
Щодо комерціалізації агентів Альтман вважає, що підприємства чіпляються за ШІ-спливаючі вікна та HTML всередині своїх продуктів, боячись втратити стосунки з клієнтами, але споживачі хочуть, щоб ШІ робив усе від їхнього імені в їхньому основному чат-додатку. Він вважає, що справжній рів захисту походить від бренду, вибору продукту та мереж виконання замовлень, а не від HTML. Він добровільно сказав, що обирає Amazon Pay 10 разів із 10, навіть за вищою ціною, і похвалив мережу виконання замовлень Amazon, водночас визнавши, що партнерські платформи всередині ChatGPT недостатньо хороші. Він також назвав усі веб-форми "фальшивою роботою" і порівняв сучасність з епохою App Store тоді.
Саме з цієї причини, розробляючи ціноутворення, OpenAI майже наслідувала AWS, встановлюючи ціни за завданням і повністю відмовившись від оплати на основі токенів, але зіткнулася з сильним опором клієнтів: "Мені потрібно знати, за що я плачу", навіть якщо вони платять більше, вони хочуть зрозумілу одиницю токенів.
Довідковий вміст:
https://www.tomshardware.com/tech-industry/data-centers/openai-ceo-says-its-quite-terrible-for-your-pc-to-have-ram-sam-altman-says-data-centers-offer-better-utilization
https://www.youtube.com/watch?v=iMsUcCYNKqY
Ця стаття походить з публічного акаунта WeChat "Machine Heart" (ID: almosthuman2014), автор: Zenan