Кратко
- Anthropic выпустила Claude Sonnet 5.5 в понедельник по цене $2 за миллион входных токенов и $10 за миллион выходных токенов — без изменений по сравнению с Sonnet 5 и вдвое дешевле Opus 5.5.
- Sonnet 5.5 набрал 70,6% в Terminal-Bench 4.0 против 66,4% у Opus 5.5, по данным Anthropic; независимый тестировщик Artificial Analysis также ставит его впереди — 63,6% против 59,6%.
- Artificial Analysis ставит его на второе место после Opus 5.5, но отмечает, что он использовал больше токенов на задачу, чем любая протестированная ими модель.
Anthropic выпустила Claude Sonnet 5.5 в понедельник — обновление Sonnet 5 от июня. Anthropic утверждает, что эта модель среднего уровня работает более чем на 30% быстрее своей предшественницы.
«Sonnet 5.5 сильнее всего в чётко очерченных повседневных задачах, исправлении ошибок и создании отточенных документов, слайдов и электронных таблиц. У него также острый глаз на дизайн», — написала Anthropic.
Цена остаётся на уровне $2 за миллион входных токенов и $10 за миллион выходных токенов. Токены — это фрагменты текста, которые ИИ читает и записывает, немного короче слова, и компании выставляют счета за миллионы. Это вдвое меньше того, что берёт Opus 5.5. Однако он использует почти на треть меньше токенов на задачу, что означает, что в итоге его эксплуатация обходится дешевле, чем Sonnet 5.
Тем не менее, эта модель блистает в программировании. На Terminal-Bench 4.0 — тесте на то, может ли ИИ-агент выполнить сложные профессиональные задачи, самостоятельно вводя команды, оцениваемом как доля выполненных задач — Sonnet 5.5 достиг 70,6%. Opus 5.5 набрал 66,4%, а Sonnet 5 смог набрать 10,3%.
Проще говоря, более дешёвая модель выполнила больше задач. Artificial Analysis, независимая фирма по тестированию, провела собственное исследование и согласна: 63,6% для Sonnet 5.5, 59,6% для Opus 5.5 и 59,1% для GPT-6 Astra от OpenAI.
Claude Sonnet 5.5 (max) делает большие успехи на Terminal-Bench, занимая место среди лучших моделей как для Terminal-Bench 4.0, так и для Terminal-Bench-Science. В Terminal-Bench 4.0 он набирает 64%, что на 50 пунктов больше, чем Claude Sonnet 5 (max), и немного выше 60% для Opus 5.5 и GPT-6… pic.twitter.com/7CPrhgmfxe
— Artificial Analysis (@ArtificialAnlys) 28 сентября 2026 г.
Оценки также зависят от настройки усилий — регулятора, который заставляет модель думать дольше для лучшего ответа и большего счёта. Anthropic утверждает, что Sonnet 5.5 при высоких усилиях соответствует GPT-6 Sol на FrontierCode примерно за пятую часть стоимости за задачу.
На GDPval-AA, который оценивает реальную профессиональную работу по 44 профессиям с использованием Elo — шахматной системы, ранжирующей относительное мастерство, — Sonnet 5.5 набрал 1844 против 1846 у Opus 5.5, что фактически является ничьей. GPT-6 Sol набрал 1487.
Конкуренты сравнивают цену. OpenAI снизила цену GPT-6 Sol до $2 и $10 на прошлой неделе, а GPT-5.6 Terra, её модель среднего уровня, стоит $2 и $12. Anthropic не опубликовала бенчмарки Terra.
Подвох
Sonnet 5.5 — большой болтун. При максимальных усилиях он написал около 193 000 токенов на тестовую задачу — больше всего, что измеряла Artificial Analysis, и примерно на 60% больше, чем Opus 5.5. Это составило $7,60 за задачу, примерно на 50% выше, чем у Sonnet 5, что противоречит заявлению Anthropic об экономии до 30%.
Экономия Anthropic достигается за счёт более низких настроек: при средних усилиях, которые являются настройкой по умолчанию в её приложениях, она утверждает, что Sonnet 5.5 превосходит лучший результат Sonnet 5 по программированию менее чем за десятую часть стоимости. Artificial Analysis говорит, что высокие усилия — это лучшее соотношение цены и качества. Для обычных пользователей это означает почти флагманское программирование за долю цены, если регулятор остаётся низким.
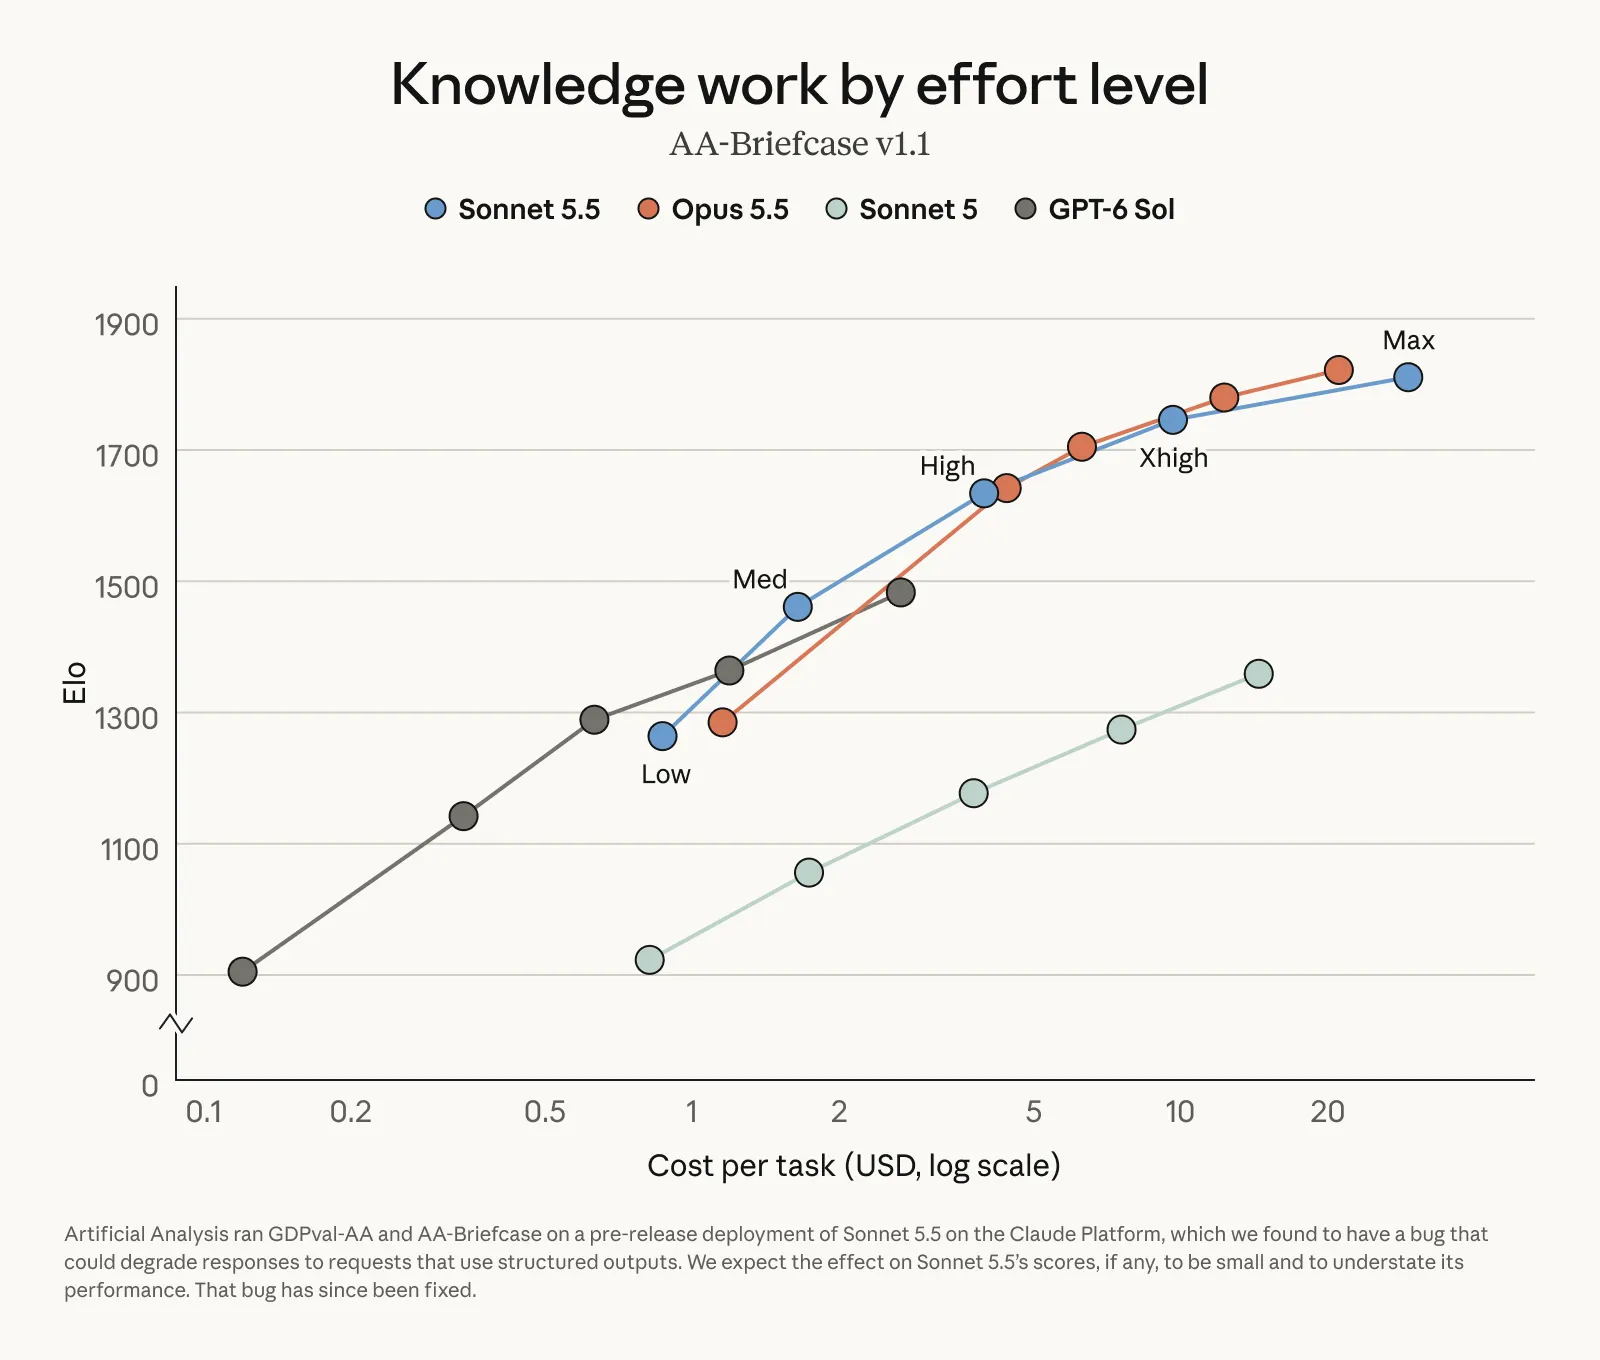
Таблица Anthropic основана на самоотчёте, а Artificial Analysis тестировала предрелизную сборку с ошибкой, которая, по ожиданиям Anthropic, мало что изменила или слегка занизила её оценки. Anthropic утверждает, что Opus 5.5 остаётся явно сильнее в сложной работе, требующей устойчивого суждения.
Claude Haiku 5.5, созданный для приложений с большим объёмом и чувствительностью к затратам, ожидается в ближайшие недели.