
Кратко
- Claude Opus 5.5 вышел во вторник по цене $4 и $20 за миллион входных и выходных токенов, что на 40% дешевле Opus 5 при настройках по умолчанию, при этом Anthropic утверждает, что он соответствует Fable 5.1 на большинстве задач.
- По собственным данным Anthropic, Opus 5.5 опережает Fable 5.1 и Opus 5 в тестах по программированию и интеллектуальной работе, но GPT-6 Astra всё ещё превосходит его в AutomationBench и Terminal-Bench-Science 0.1.
- Это первая модель, выпущенная Anthropic с тех пор, как генеральный директор Дарио Амодеи призвал отрасль замедлить рост возможностей ИИ, и она несёт те же меры защиты в области кибербезопасности и биологии, что и Fable 5.1.
Anthropic выпустила Claude Opus 5.5 во вторник — первую модель в том, что компания называет своим семейством Claude 5.5. Anthropic утверждает, что новая модель работает на уровне Claude Fable 5.1, её самого дорогого флагмана, на большинстве задач.
Изюминка в том, что эксплуатация модели стоит на 20% меньше, чем у Opus 5, модели, которую она заменяет, и на 60% дешевле, чем Fable 5.1, самого передового предложения компании.
Похоже, эта модель очень способна. Это самая продвинутая модель как по версии (5.5 против 5.1 у Fable), так и по семейству (Opus — самая большая модель, доступная публично, за ней следует Sonnet, а Haiku — самая маленькая).
Anthropic признаёт, что разрыв между Fable и Opus уже, чем предполагают его оценки в бенчмарках, но доступность по плану и более низкая цена за токен делают этот выбор очевидным для большинства пользователей Claude.
Opus 5 вышел в июле, снизив цену и обойдя Fable 5 по большинству бенчмарков, а Fable 5.1 появился в начале сентября и перевернул ситуацию, обойдя Opus 5 по каждому бенчмарку, опубликованному Anthropic.
Opus 5.5 снова сокращает разрыв, на этот раз за счёт цены, а не сырых показателей. Lovable, платформа для разработчиков, которая прогнала Opus 5 через свои собственные тесты по программированию ещё в июле, заявила в комментарии, распространённом Anthropic, что предыдущая модель была «стабильнее, с гораздо меньшей вариативностью от запуска к запуску», чем то, что было до неё — тот же аргумент об эффективности, который Anthropic снова приводит сейчас.
Opus 5.5 также является первой моделью, выпущенной Anthropic с тех пор, как генеральный директор Дарио Амодеи опубликовал эссе с призывом к отрасли замедлиться, утверждая, что рост возможностей ИИ опережает тестирование безопасности, призванное их сдерживать. «Мы должны замедлить темпы, с которыми мы улучшаем возможности моделей ИИ», — написал Амодеи ранее в этом месяце.
Anthropic измеряет большую часть этого прогресса через агентное программирование — работу, выполняемую ИИ-агентом, моделью, которая предпринимает многошаговые действия самостоятельно, а не просто отвечает на один запрос.
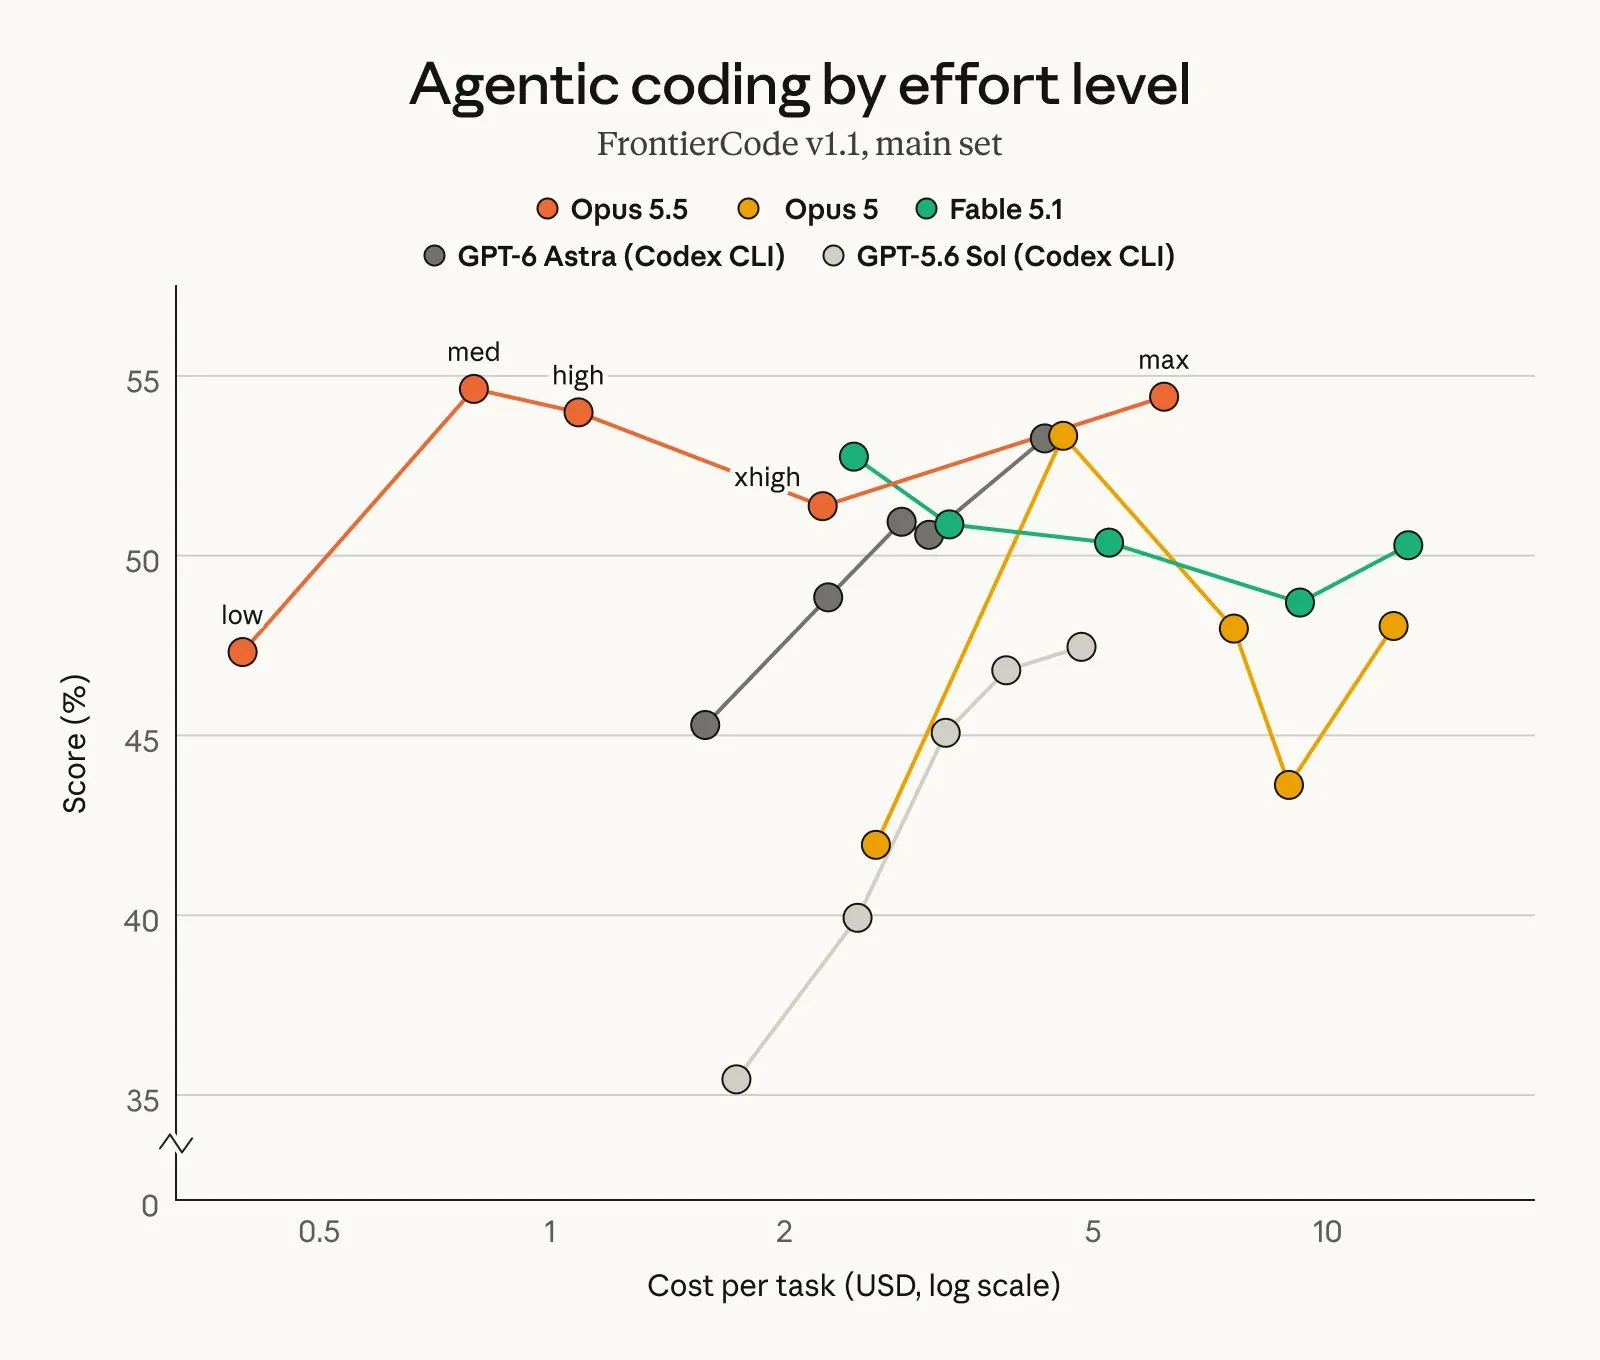
В Terminal-Bench 4.0, который проверяет, может ли агент выполнить сложные профессиональные задачи в интерфейсе командной строки, и оценивает результат как процент выполненных задач, Opus 5.5 достиг 66,4%, опередив Fable 5.1 с 55,8% и GPT-6 Astra с 57,9%. FrontierCode, который проверяет, будут ли изменения кода агента действительно приняты в реальном инженерном конвейере, используя ту же систему оценки по проценту прохождения, поставил Opus 5.5 на 54,4% против 50,3% у Fable 5.1.
В GDPval-AA v2.1, который оценивает реальную профессиональную работу по 44 профессиям с использованием Elo — той же шахматной системы рейтинга, используемой для измерения относительного мастерства, а не плоского процента, — Opus 5.5 набрал 1846 против 1735 у Fable 5.1 и 1708 у Opus 5.
Однако Opus 5.5 лидирует не везде. В AutomationBench, созданном Zapier бенчмарке, который оценивает, может ли агент выполнить полный бизнес-процесс от начала до конца без помощи человека, 41,4% у GPT-6 Astra немного опережают 40,0% у Opus 5.5.
В Terminal-Bench-Science 0.1, который тестирует агентные научные исследования, проводимые в среде командной строки, используя тот же метод оценки по проценту прохождения, 64,6% у Astra превосходят 58,7% у Opus 5.5 с более широким отрывом.
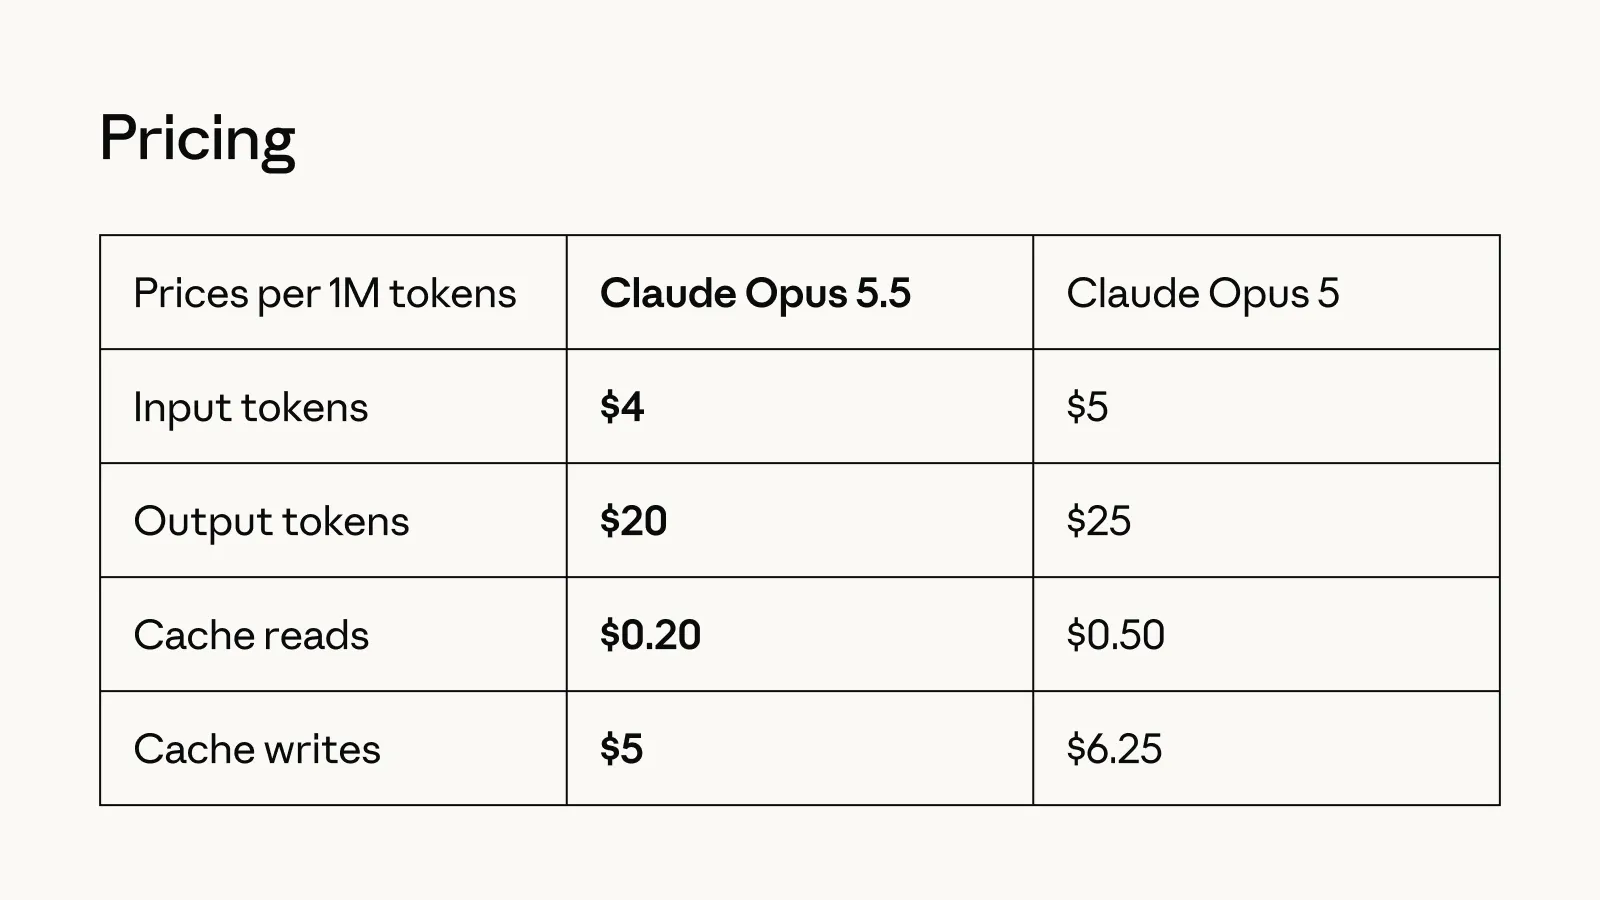
Более весомым аргументом в пользу покупки является стоимость. Входные токены — фрагменты текста, которые модель читает и записывает, с ценой за миллион — теперь стоят $4 для Opus 5.5 против $5 для Opus 5, а выходные токены подешевели до $20 с $25. Чтение из кэша, то есть повторное использование уже обработанного моделью контекста вместо его повторной обработки с нуля, что составляет большую часть затрат при длительных сессиях агентного программирования, подешевело на 60% до $0,20 за миллион токенов.
Поскольку Opus 5.5 соответствует моделям класса Mythos от Anthropic — наиболее ограниченному уровню компании, предназначенному для проверенных исследователей в области кибербезопасности и биологии — по этим двум возможностям, он выпускается с теми же мерами защиты, что и Fable 5.1.
Большинство задач по кибербезопасности автоматически перенаправляются на более старую Opus 4.8, на что ранее жаловались многие разработчики и пользователи..
Opus 5.5 уже доступна на всех платформах Anthropic, включая Amazon Web Services, Google Cloud и Microsoft Azure. Sonnet 5.5 и Haiku 5.5 появятся в ближайшие недели, сообщает Anthropic, распространяя то же снижение цен на остальную часть линейки.





