
Em resumo
- Claude Opus 5.5 foi lançado na terça-feira com preço de US$ 4 e US$ 20 por milhão de tokens de entrada e saída, 40% mais barato que o Opus 5 nas configurações padrão, enquanto a Anthropic afirma que ele iguala o Fable 5.1 na maioria das tarefas.
- Segundo os próprios números da Anthropic, o Opus 5.5 lidera o Fable 5.1 e o Opus 5 em testes de codificação e trabalho de conhecimento, mas o GPT-6 Astra ainda o supera no AutomationBench e no Terminal-Bench-Science 0.1.
- É o primeiro modelo que a Anthropic lançou desde que o CEO Dario Amodei pediu que o setor desacelerasse os ganhos de capacidade de IA, e ele carrega as mesmas salvaguardas de cibersegurança e biologia que o Fable 5.1.
A Anthropic lançou o Claude Opus 5.5 na terça-feira, o primeiro modelo do que a empresa está chamando de família Claude 5.5. A Anthropic afirma que o novo modelo tem desempenho no nível do Claude Fable 5.1, seu carro-chefe mais caro, na maioria das tarefas.
O detalhe é que o modelo custa 20% menos para operar do que o Opus 5, o modelo que ele substitui, e é 60% mais barato que o Fable 5.1, a oferta de ponta da empresa.
O modelo, ao que parece, é muito capaz. É o modelo mais avançado tanto em versão (5.5 vs 5.1 do Fable) quanto em família (Opus é o maior modelo disponível publicamente, seguido pelo Sonnet, sendo o Haiku o menor deles).
A Anthropic admite que a diferença entre Fable e Opus é menor do que seus resultados de benchmark sugerem, mas estar disponível publicamente no plano, e ser mais barato por token, torna esta a escolha óbvia para a maioria dos usuários do Claude.
O Opus 5 foi lançado em julho com preço inferior e superando o Fable 5 na maioria dos benchmarks, e o Fable 5.1 chegou no início de setembro e reverteu isso, superando o Opus 5 em todos os benchmarks publicados pela Anthropic.
O Opus 5.5 fecha a lacuna novamente, desta vez em preço em vez de pontuações brutas. A Lovable, uma plataforma de desenvolvedores que testou o Opus 5 em seus próprios testes de codificação em julho, disse em um comunicado compartilhado pela Anthropic que o modelo anterior era "mais estável, com muito menos variação de execução para execução" do que o que veio antes dele—o mesmo argumento de eficiência que a Anthropic está fazendo novamente agora.
O Opus 5.5 também é o primeiro modelo que a Anthropic lançou desde que o CEO Dario Amodei publicou um ensaio pedindo que o setor desacelerasse, argumentando que os ganhos de capacidade da IA estão superando os testes de segurança destinados a mantê-los sob controle. "Precisamos desacelerar o ritmo com que melhoramos as capacidades dos modelos de IA", escreveu Amodei no início deste mês.
A Anthropic mede a maior parte desse progresso por meio da codificação agêntica — trabalho realizado por um agente de IA, um modelo que executa ações de várias etapas por conta própria em vez de apenas responder a um único comando.
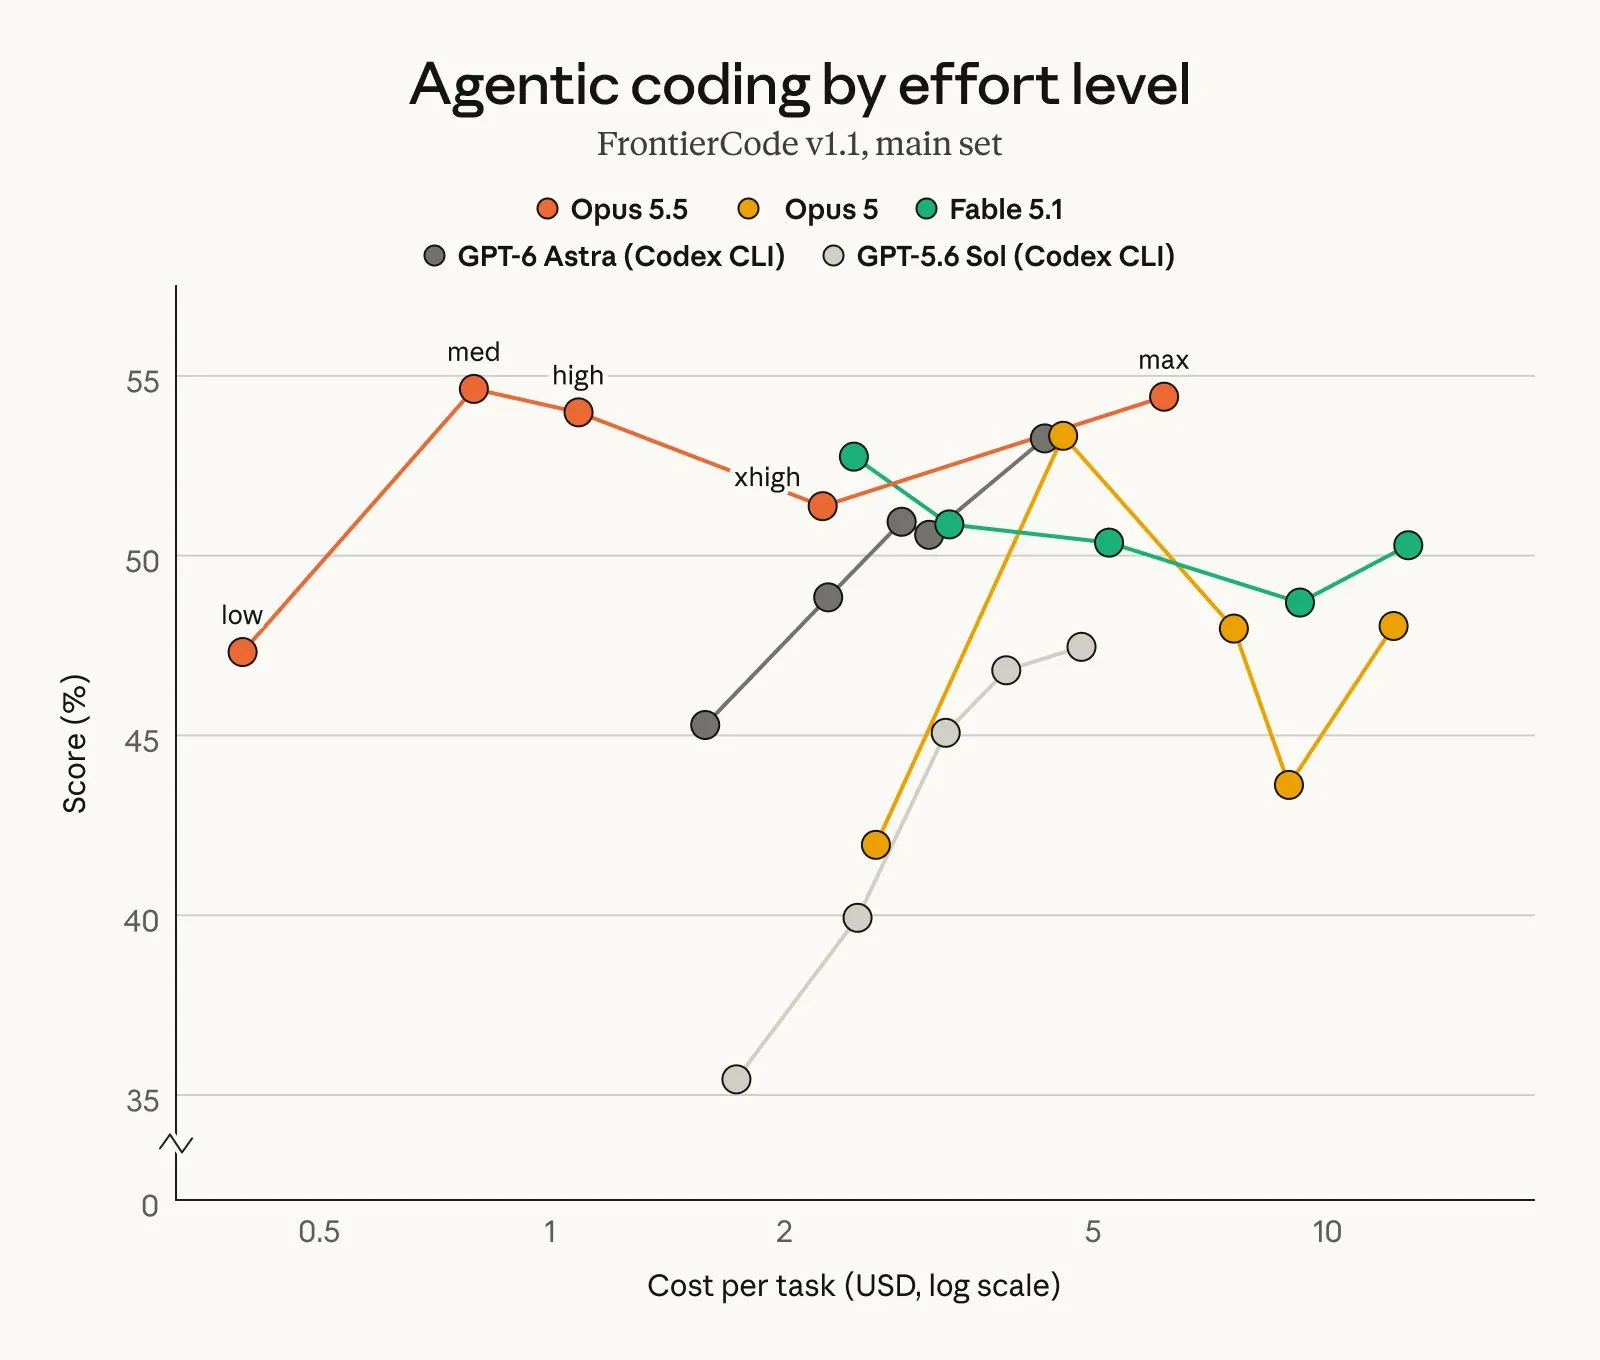
No Terminal-Bench 4.0, que testa se um agente consegue concluir tarefas profissionais complexas dentro de uma interface de linha de comando e pontua o resultado como uma porcentagem de tarefas concluídas, o Opus 5.5 atingiu 66,4%, à frente dos 55,8% do Fable 5.1 e dos 57,9% do GPT-6 Astra. O FrontierCode, que verifica se as alterações de código de um agente realmente seriam mescladas em um pipeline de engenharia real usando essa mesma pontuação de taxa de aprovação, colocou o Opus 5.5 em 54,4%, contra os 50,3% do Fable 5.1.
No GDPval-AA v2.1, que avalia trabalho profissional do mundo real em 44 ocupações usando Elo — o mesmo sistema de classificação no estilo xadrez usado para medir habilidade relativa em vez de uma porcentagem fixa —, o Opus 5.5 marcou 1846, contra 1735 do Fable 5.1 e 1708 do Opus 5.
O Opus 5.5, no entanto, não lidera em todos os lugares. No AutomationBench, um benchmark criado pela Zapier que pontua se um agente consegue conduzir um fluxo de trabalho empresarial completo do início ao fim sem ajuda humana, os 41,4% do GPT-6 Astra superam os 40,0% do Opus 5.5.
No Terminal-Bench-Science 0.1, que testa pesquisa científica agêntica realizada dentro de um ambiente de linha de comando usando esse mesmo método de taxa de aprovação, os 64,6% do Astra superam os 58,7% do Opus 5.5 por uma margem maior.
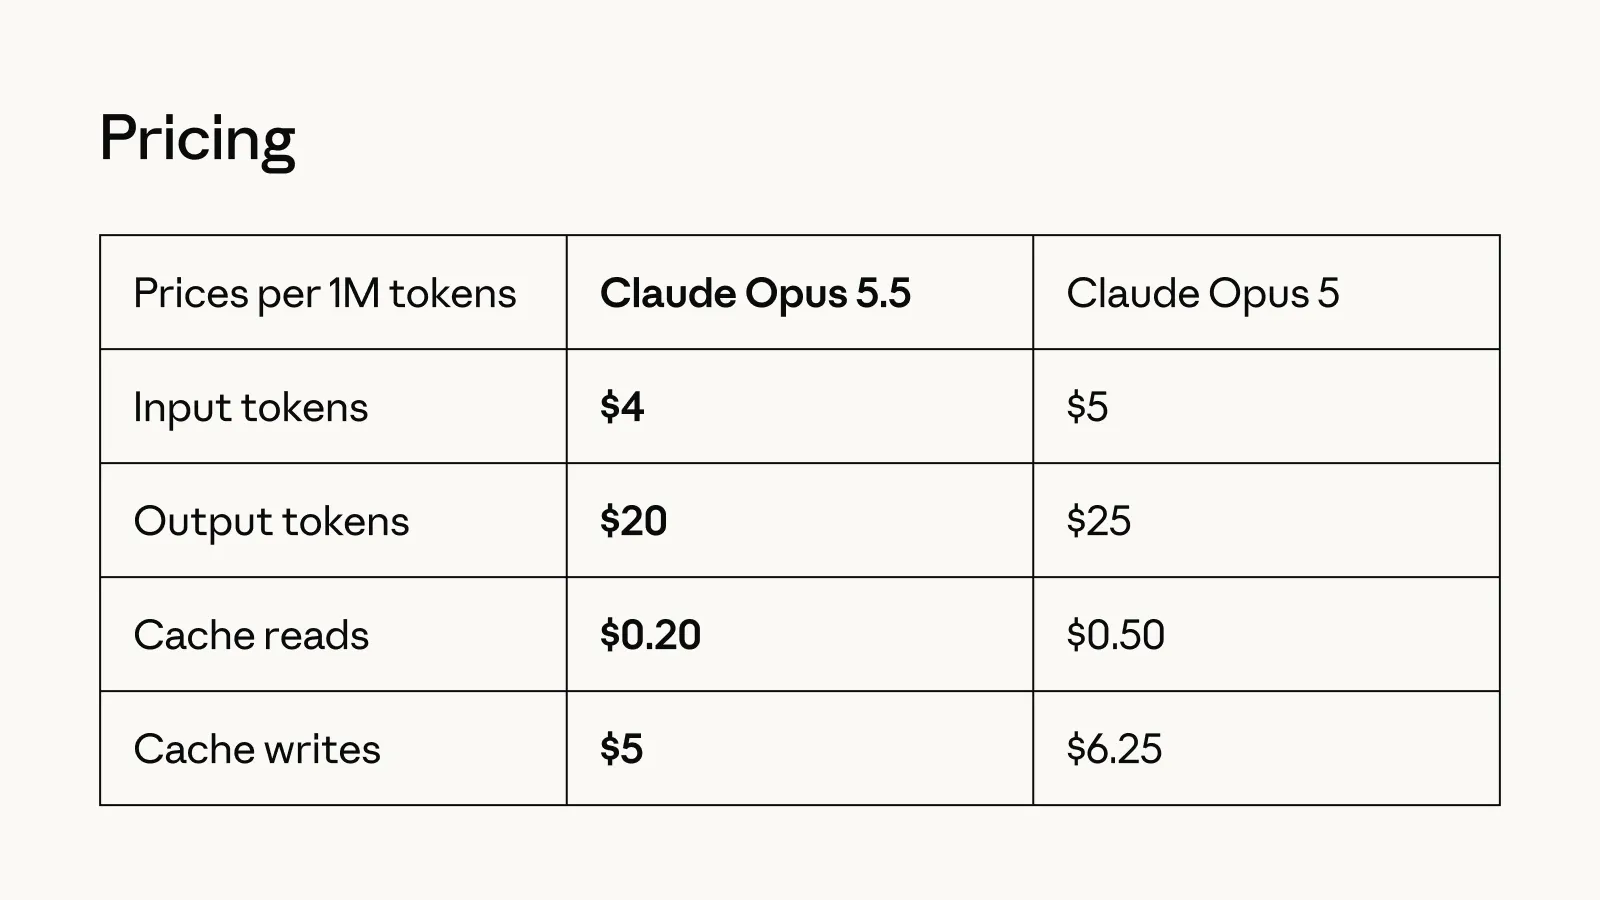
O maior atrativo é o custo. Os tokens de entrada—os blocos de texto que um modelo lê e escreve, com preço por milhão—agora custam US$ 4 para o Opus 5.5, contra US$ 5 para o Opus 5, e os tokens de saída caem para US$ 20, de US$ 25. As leituras de cache, que significam reutilizar o contexto que um modelo já processou em vez de reprocessá-lo do zero e que respondem pela maior parte do custo em longas sessões de codificação agêntica, caem 60%, para US$ 0,20 por milhão de tokens.
Como o Opus 5.5 iguala os modelos da classe Mythos da Anthropic—o nível mais restrito da empresa, reservado a pesquisadores de cibersegurança e biologia verificados—nessas duas capacidades, ele é lançado com as mesmas salvaguardas do Fable 5.1.
A maioria das tarefas de cibersegurança é automaticamente redirecionada para o Opus 4.8 mais antigo, algo sobre o que muitos desenvolvedores e usuários já reclamaram..
O Opus 5.5 já está disponível nas plataformas da Anthropic, incluindo Amazon Web Services, Google Cloud e Microsoft Azure. O Sonnet 5.5 e o Haiku 5.5 virão nas próximas semanas, diz a Anthropic, levando os mesmos cortes de preço para o restante da linha.





