AI matematyka przekracza bardzo subtelną granicę.
W przeszłości pytaliśmy: Czy duży model może rozwiązać trudny problem? Czy potrafi napisać rygorystyczny dowód? Czy może znaleźć kontrprzykład, którego ludzie nie odkryli przez dziesięciolecia?
Teraz pojawiło się pytanie bardziej przypominające „same badania”: Gdy ścieżka dowodu zawiedzie, czy AI wie, co robić dalej? Czy powinna kontynuować obliczenia, zmienić ścieżkę, zawęzić twierdzenie, czy po prostu zaproponować nową, falsyfikowalną hipotezę matematyczną?
AI Has Taste, stworzony przez badacza Zenga Zijiana z Uniwersytetu UCSI, próbuje przekształcić to pytanie w zrównoważony system badawczy.
Publiczne repozytorium projektu zawiera obecnie 453 rękopisy badań matematycznych i 2312 stron treści, z których 6 jest wyraźnie sklasyfikowanych jako „Hipotezy zaproponowane przez AI”.
Pozycjonowanie podane na stronie głównej repozytorium jest jeszcze bardziej bezpośrednie: Od generowania odpowiedzi do generowania programów badawczych — od generowania odpowiedzi do generowania programów badawczych.
AI obaliło hipotezę w artykule, a oryginalny autor potwierdził to w odpowiedzi
AI Has Taste nie zaczęło od przekonania, że „AI musi być dobre w matematyce”. Zeng Zijian wspomina, że na początku projektu nie był pewien, czy duże modele mogą naprawdę posunąć naprzód badania matematyczne. Przypadkowy test stał się punktem zwrotnym: przekazał bezpośrednio hipotezę z artykułu do AI, początkowo chcąc tylko zobaczyć, jak daleko model może zajść. W rezultacie AI nie kontynuowało „dowodu” zgodnie z artykułem, ale skonstruowało kontrprzykład, który bezpośrednio obalił hipotezę.
Jego pierwszą reakcją nie było podniecenie, ale niedowierzanie. Zorganizował więc kontrprzykład i wyprowadzenie, i napisał do autora oryginalnego artykułu, aby to zweryfikować. Otrzymana następnie odpowiedź potwierdziła: ten kontrprzykład jest słuszny. Odpowiednie badania zostały później włączone do obecnych ponad 450 rękopisów matematycznych.
„Początkowo nie wierzyłem w moc AI w matematyce. Dopóki nie wprowadziłem hipotezy z artykułu, a AI bezpośrednio podało kontrprzykład, aby ją obalić; natychmiast napisałem do oryginalnego autora, a druga strona odpowiedziała, potwierdzając, że to poprawne. Potem naprawdę odpuściłem i zaangażowałem się na całego.” — Zeng Zijian
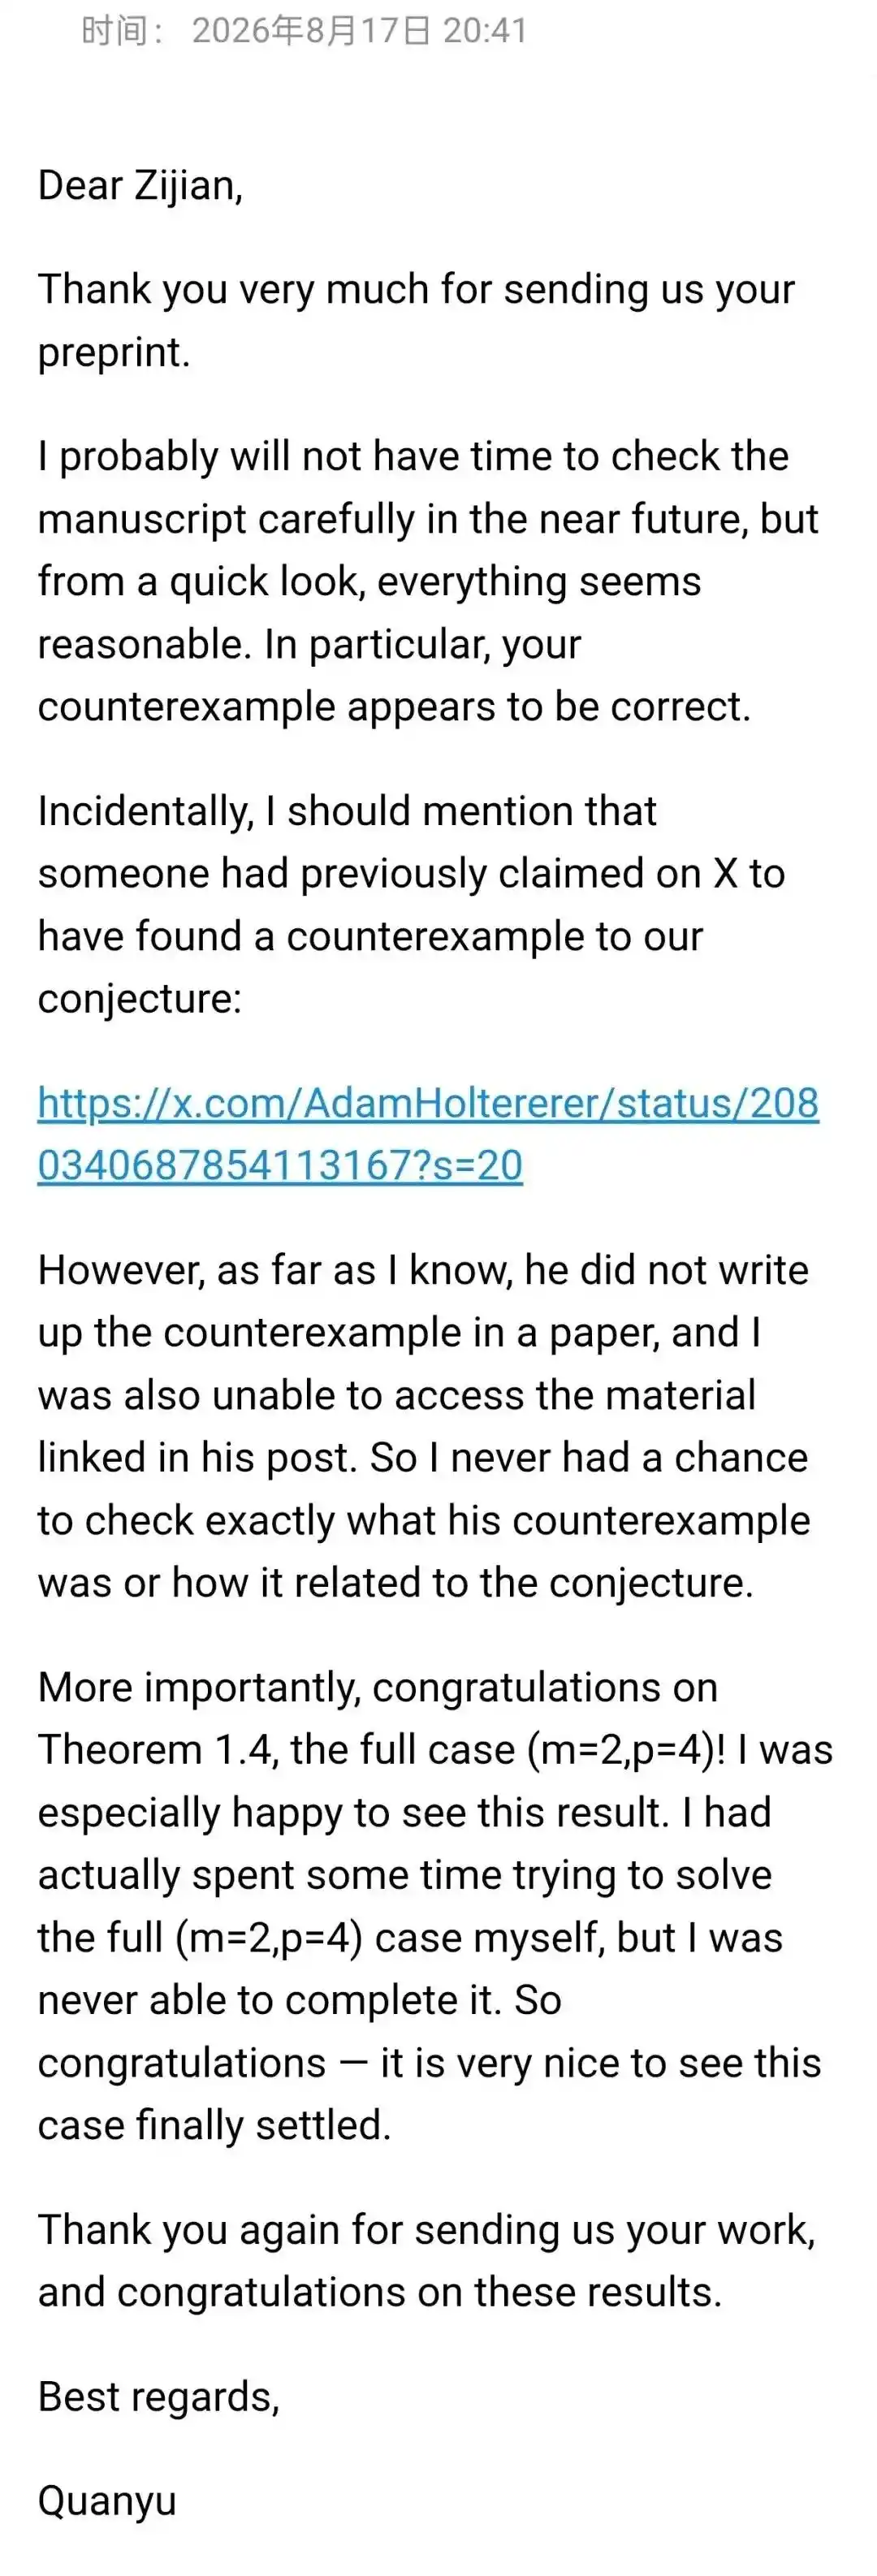
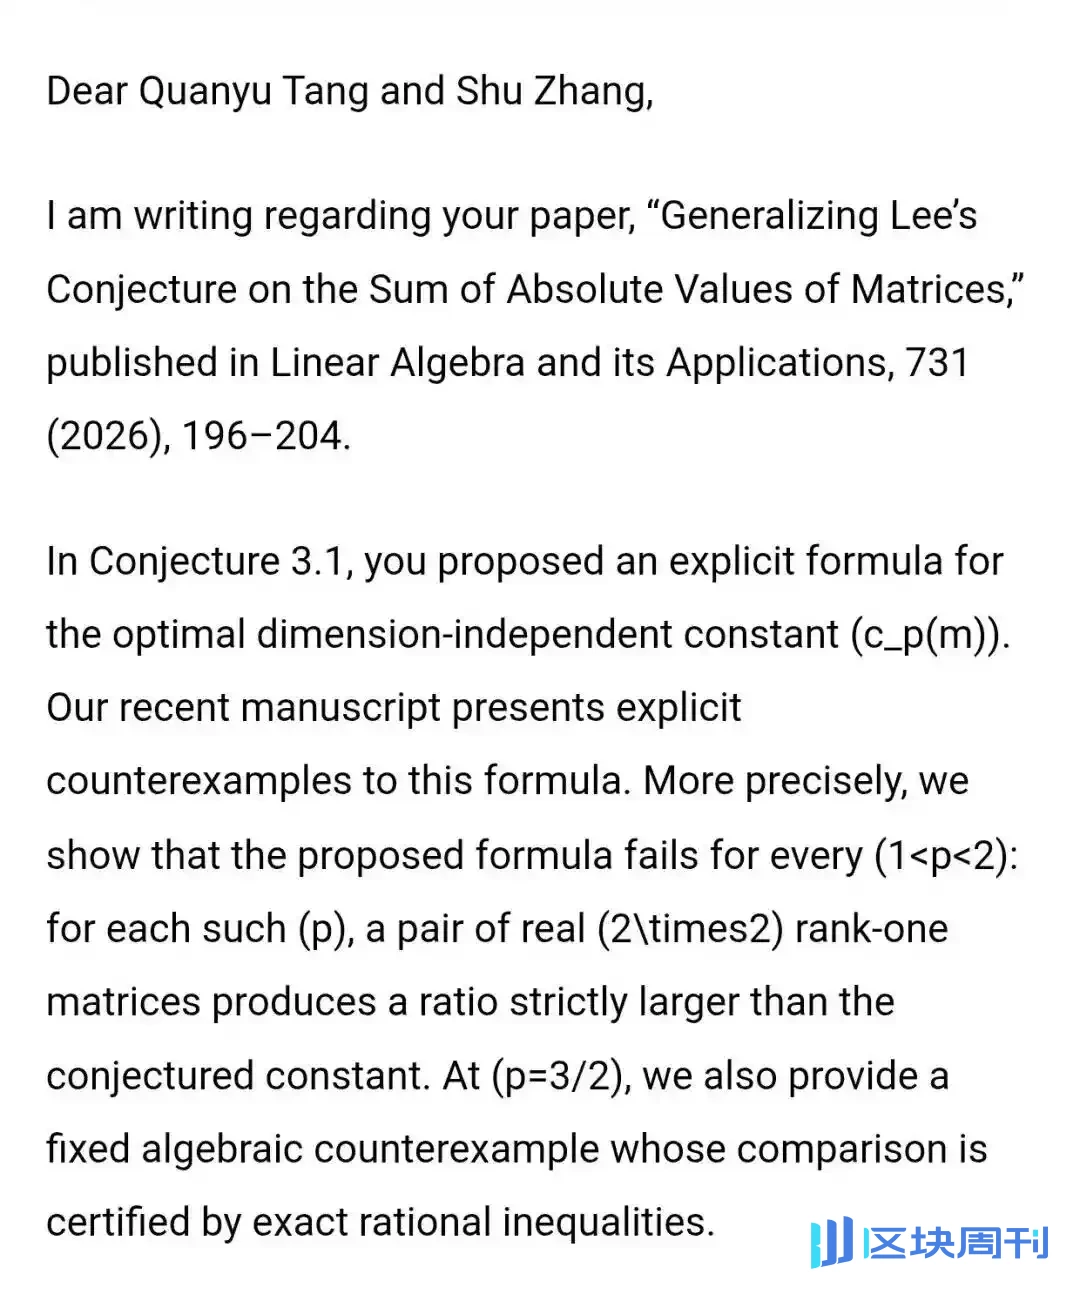
To, co zmienił ten e-mail, to nie pojedyncza hipoteza, ale skala projektu. Jeśli AI może nie tylko powtarzać znaną wiedzę i generować tekst, który wygląda jak dowód, ale także aktywnie atakować nowe hipotezy w artykułach i znaleźć kontrprzykład potwierdzony przez oryginalnego autora, to ma szansę naprawdę wejść w „pętlę badawczą”. Następnie Zeng Zijian zaczął stopniowo agentować wybór tematów, dowody, wyszukiwanie kontrprzykładów, zarządzanie porażkami, niezależny przegląd i pisanie, i pozwolił różnym maszynom działać równolegle przez długi czas.
Prawdziwa zmiana to nie „ile artykułów napisano”
Patrząc tylko na ilość, 453 rękopisy są już wystarczająco przyciągające uwagę. Ale jeśli ten projekt jest rozumiany tylko jako „AI piszące artykuły matematyczne partiami”, to pomija się najbardziej godną uwagi część.
Sam projekt wielokrotnie podkreśla: 453 to liczba „manuskryptów badawczych”, co nie oznacza, że wszystkie 453 oryginalne otwarte problemy zostały rozwiązane. Wyniki obejmują pełne dowody, kontrprzykłady, wyniki częściowe, certyfikaty obliczeń skończonych, ustrukturyzowane redukcje oraz prace proponujące nowe hipotezy. Wewnętrzna recenzja AI również nie równa się zewnętrznej recenzji naukowej.
Prawdziwa zmiana zachodzi w łańcuchu badawczym. Tradycyjne benchmarki AI często wychodzą od „problem został już podany”: człowiek wybiera temat, AI go rozwiązuje, a na końcu jest sukces lub porażka. AI Has Taste rozciąga ten proces zarówno w przód, jak i w tył—AI może przesiewać kandydatów na problemy, porównywać ścieżki i aktywnie szukać kontrprzykładów; po niepowodzeniu ścieżki może również analizować strukturę porażki, modyfikować twierdzenie i przekazywać nowe obiekty matematyczne innemu niezależnemu Agentowi do dalszego atakowania.

Kluczem do AI Has Taste nie jest „więcej podpowiedzi”, ale zamienianie porażki w wkład do następnej rundy badań.
Agent wyboru tematu, dowodzenia, znajdowania błędów i pisania
Ten system nie polega na tym, że „jeden model zadaje pytania i sam sobie odpowiada w jednym oknie dialogowym”. Publiczne README dzieli role Agentów na cztery warstwy:
Supervisor / Screener odpowiada za wybór kandydatów, porównywanie pobliskich wyników i znajdowanie najtańszego rozstrzygającego eksperymentu;
Researcher odpowiada za dowody, kontrprzykłady i dokładne obliczenia;
Fresh-context Reviewer specjalnie atakuje zamrożone twierdzenia, kluczowe lematy i certyfikaty w nowym kontekście;
Writer / Release Checker odpowiada za jasne opisanie ostatecznie zaakceptowanego zakresu oraz sprawdzenie cytowań, kompilacji i materiałów wydawniczych.
Zeng Zijian dodatkowo rozłożył przepływ pracy na współpracę wielu maszyn: różne maszyny mogą osobno rozwijać dowody, szukać kontrprzykładów, uruchamiać dokładne obliczenia i przeprowadzać niezależną recenzję. Wspólne są zamrożone twierdzenia, zapisy eksperymentów, przyczyny porażek, kod i dowody, zamiast pozwalania jednemu Agentowi na generowanie wyników i samodzielne ich zatwierdzanie.

Podstawowa konstrukcja wielu agentów: rozdzielenie ról + wspólne dowody + recenzja w świeżym kontekście.
W repozytorium jest zdanie, które bardzo dobrze podsumowuje tę konstrukcję: Krytyka jest częścią silnika, a nie posłowiem. Krytyka nie jest procedurą dodaną po napisaniu pracy, ale częścią silnika badawczego.
Matematycy, robotycy i badacze automatyzacji wchodzą w łańcuch weryfikacji
Gdy manuskrypty badawcze rozrosły się z kilkudziesięciu do setek, inne pytanie stało się ostrzejsze: kto ocenia, że te wyniki agentów nie są systematycznymi halucynacjami?
AI Has Taste wewnętrznie używa Fresh-context Reviewera do rozdzielenia „badań” i „znajdowania błędów”, ale projekt nie traktuje samooceny AI jako punktu końcowego.
W miarę postępów pracy Zengzaijian zaczął również zapraszać prawdziwych naukowców z różnych dziedzin do udziału w weryfikacji, recenzji i dyskusji akademickiej nad niektórymi wynikami.
Według zespołu projektowego współpracownicy i recenzenci zaangażowani w część pracy to: Ong Seng Huat, Fellow Malezyjskiej Akademii Nauk i profesor honorowy w Instytucie Nauk Matematycznych Uniwersytetu Malaya; Kurunathan Ratnavelu, Fellow Malezyjskiej Akademii Nauk i profesor honorowy w Instytucie Nauk Matematycznych Uniwersytetu Malaya; oraz profesor Xiong Yonghua ze Szkoły Sztucznej Inteligencji i Automatyzacji Chińskiego Uniwersytetu Geologicznego (Wuhan).
Należy tu rozróżnić „udział w weryfikacji” od „zatwierdzenia wszystkich wyników”: wspomniani uczeni nie podpisali się pod wszystkimi 453 manuskryptami jeden po drugim, lecz weryfikowali, recenzowali lub omawiali niektóre problemy, dowody, wyniki obliczeń lub kierunki badań.
Dla wysoce zautomatyzowanego systemu badań naukowych takie połączenie „wewnętrznego czerwonego zespołu maszynowego + wyrywkowej kontroli/przeglądu przez ekspertów ludzkich” jest, wręcz przeciwnie, bardziej krytyczne niż przekazanie całego przeglądu temu samemu zestawowi agentów.
AI odpowiada za doprowadzenie szybkości badań do granic możliwości; eksperci ludzcy odpowiadają za przywrócenie „wygląda na poprawne” z powrotem do „godne wiary” w kluczowych węzłach.
Po porażce wybrano lepsze pytanie
Przypadek w projekcie, który najlepiej ucieleśnia „smak badawczy”, to właśnie nie piękny sukces, lecz porażka.
W problemie śladu ułamkowego Gaussa system początkowo próbował tras monotoniczności i jednostronnego parowania, ale nieustannie pojawiały się dokładne kontrprzykłady. Zwykły benchmark zwykle pozostawiłby tu tylko jedną etykietę: FAILED.
Ale ten przepływ pracy się nie zatrzymał. Agent kontynuował pytanie: co dokładnie zepsuł kontrprzykład? Czy porażka ma stabilną strukturę? Ostatecznie badania przeniosły uwagę na ustalony defekt ujemny, skonstruowano dziesięciowyrazową strukturę korekcyjną i zaproponowano nową ujednoliconą hipotezę ograniczoności. Co bardziej krytyczne, nowa hipoteza została następnie zaatakowana po kolei przez kolejną rundę dokładnych obliczeń i niezależny przegląd. Skan publicznego archiwum osiągnął indeks 1004; ta ujednolicona granica wciąż nie została udowodniona.
Znaczenie tej sprawy nie polega na tym, że „AI udowodniło kolejne wielkie twierdzenie”—w rzeczywistości tak się nie stało. Znaczenie polega na tym, że: pierwotny problem nie został rozwiązany, ale nieudana trasa została skompresowana do nowego twierdzenia, które jest jaśniejsze, bardziej falsyfikowalne i, gdy tylko się utrzyma, może ponownie połączyć się z pierwotnym problemem. Badania nie zakończyły się na porażce, lecz wyrosły z porażki następny problem.
Dawniej: ludzie stawiali problemy, AI na nie odpowiadało. Teraz: AI odpowiada na problemy, a także zaczyna uczestniczyć w decydowaniu „jaki jest następny problem”.
6 nowych hipotez AI
Według obecnego publicznego zrzutu repozytorium klasyfikuje 6 prac osobno w kategorii „Hipotezy zaproponowane przez AI”. Prace te obejmują kombinatorykę, teorię grafów, teorię liczb i problemy typu analitycznego, w tym nieosobliwość nieskończonych macierzy jądra binarnego dla trzech podciągów A182510, CDS-kolorowalność diagramów Younga, dekompozycję grafów bez trójkątów o maksymalnym stopniu co najwyżej 6, formuły kongruencji unarnej-theta dla 18-kolorowych uogólnionych partycji Frobeniusa, nieujemność współczynników Newtona dla mianowników odwrotnych podsumowań na etapach diadycznych oraz wspomnianą hipotezę ustalonego defektu dla śladu ułamkowego Gaussa.
To, co naprawdę warte uwagi, to nie to, czy AI potrafi „wygenerować burzę mózgów na temat hipotezy”. Przypadkowe zgadnięcie jednego zdania nie jest trudne. Trudne jest zapisanie hipotezy w precyzyjną definicję, wyjaśnienie, skąd pochodzi, jakie dowody ją wspierają, jakie kontrprzykłady mogłyby ją obalić, do jakich wyników prowadziłaby, gdyby się utrzymała, oraz pozostawienie obliczeń i kodu źródłowego do późniejszego przeglądu.
To także dlatego projekt uważa „proponowanie hipotez” za działanie badawcze wyższego poziomu niż „generowanie odpowiedzi”: dowody odpowiadają na istniejące pytania, podczas gdy hipotezy zmieniają to, gdzie inwestowane są późniejsze zasoby badawcze.
Za 453 manuskryptami kryje się prototyp „badań naukowych na skalę agentów”
AI Has Taste publicznie udostępniło obecnie 453 manuskrypty badawcze, liczące łącznie 2312 stron; spośród nich sam przepływ pracy BigWIN2 odpowiada za 223 manuskrypty i zapewnia sparowane pakiety materiałów LaTeX/reprodukcji dla tych 223 prac.
Najbardziej kontrintuicyjne w tej skali nie jest to, że „AI szybko pisze”. To, co naprawdę kosztowne w badaniach matematycznych, to przełączanie kontekstu: ten problem wymaga teorii grafów, następny teorii liczb, a kolejny może wymagać SAT, wyczerpującego przeszukiwania, dokładnej arytmetyki wymiernej lub obliczeń macierzowych. Ludzki badacz nie może jednocześnie utrzymywać setek całkowicie różnych linii myślenia, ale system agentów może podzielić je na niezależne zadania i zachować nieudane trasy, lokalne twierdzenia i powtarzalne eksperymenty.
Tak więc rola indywidualnego badacza się zmienia: nie osobiste wyprowadzanie każdego kroku, ale bardziej rola PI—ustalanie granic badań, wybór puli problemów, decydowanie, które wyniki są warte dalszego inwestowania, kiedy przestać i które wnioski kwalifikują się do publicznego ujawnienia.
Dlaczego nazywa się to „AI Has Taste”?
„AI has taste” brzmi bardzo antropomorficznie, ale README projektu celowo wyznacza granicę: taste oznacza tu nie świadomość ani subiektywne doświadczenie, lecz „matematyczny osąd wyrażany poprzez decyzje badawcze”.
Na przykład: jeśli oba problemy można rozwiązać, który najpierw? Trasa ma już lokalny postęp, ale marginalne zyski są coraz niższe — czy należy ją zatrzymać? Czy kontrprzykład jest wyrokiem śmierci dla twierdzenia, czy pokazuje, że prawdziwe twierdzenie powinno być sformułowane inaczej? Czy mały wynik wystarczy, by stanąć samodzielnie jako artykuł? Te decyzje były zwykle ukryte w doświadczeniu badaczy w przeszłości i trudne do zmierzenia za pomocą standardowych benchmarków.
AI Has Taste próbuje pozostawić możliwy do zbadania ślad tych decyzji: który problem został wybrany, dlaczego zmieniono trasę, jaką strukturę pozostawiła porażka, skąd wzięło się następne twierdzenie i jak nowy wniosek został ponownie zaatakowany przez niezależny kontekst.
Jak daleko jest od „autonomicznego matematyka”?
Miejsce, w którym ten projekt najłatwiej wyolbrzymić, również trzeba jasno określić. 453 manuskrypty to nie 453 artykuły czasopiśmiennicze, które przeszły formalną recenzję; wewnętrzna recenzja agenta nie jest równoznaczna z niezależną recenzją społeczności matematycznej; a zakres objęty skończonym obliczeniem nie może być automatycznie uogólniony na przypadek nieskończony. Same repozytorium wyraźnie stwierdza te ograniczenia.
Ale jeśli ktoś ignoruje jego sposób organizowania badań tylko dlatego, że te wyniki nie wszystkie przeszły zewnętrzną weryfikację, przegapiłby także inną zmianę: granica możliwości AI przesuwa się od „wykonywania zadanego zadania” do „uczestniczenia w projektowaniu następnego zadania”.
Naprawdę rzadkimi zasobami w badaniach matematycznych nigdy nie były tylko moc obliczeniowa i długość rozumowania, ale także: które problemy są warte poświęcenia czasu, które porażki są warte zachowania i kiedy należy zmienić temat.
Kiedy AI zaczyna wchodzić w te ogniwa, konkurencja w „AI for Math” nie polega już tylko na tym, „kto lepiej dowodzi”, ale stopniowo stanie się: kto ma lepszą pętlę badawczą i kto potrafi z dużej liczby porażek wyodrębnić kierunki bardziej warte dalszego pursued.
Jeszcze jedno
Dotychczasowa narracja o naukowych badaniach AI bardzo przypominała superucznia: nauczyciel zadaje problemy, a on jest odpowiedzialny za ich rozwiązanie.
To, co AI Has Taste chce robić, bardziej przypomina grupę badawczą: ludzie dostarczają granice i sądy wartościujące, a agenci znajdują problemy, testują problemy, popełniają błędy, obalają samych siebie, pozostawiają lokalne wyniki, a następnie proponują następny problem.
Jeśli ta trasa nadal się utrzyma, najważniejszy podział pracy człowiek-maszyna w przyszłych badaniach podstawowych może zmienić się z „ludzie są odpowiedzialni za myślenie, AI za obliczanie” na bardziej złożoną strukturę: ludzie są odpowiedzialni za cele, wartości i ostateczną odpowiedzialność; AI podejmuje zakrojone na szeroką skalę poszukiwania, weryfikację, zarządzanie porażkami i generowanie kandydujących kierunków badawczych; narzędzia formalne i publiczne dowody są odpowiedzialne za uczynienie wyników możliwymi do recenzji.
Gdy AI potrafi rozwiązywać problemy, następną przeszkodą może naprawdę być: czy AI potrafi wybierać problemy?
Ten artykuł pochodzi z publicznego konta WeChat „Xin Zhi Yuan”, autor: Xin Zhi Yuan