L'IA en mathématiques franchit une ligne de démarcation très subtile.
Auparavant, nous demandions : Un grand modèle peut-il résoudre un problème difficile ? Peut-il écrire une preuve rigoureuse ? Peut-il trouver un contre-exemple que les humains n'ont pas découvert pendant des décennies ?
Maintenant, une question plus proche de la « recherche elle-même » a émergé : Après l'échec d'une piste de preuve, l'IA sait-elle quoi faire ensuite ? Doit-elle continuer à calculer, changer de piste, restreindre la proposition, ou simplement proposer une nouvelle conjecture mathématique falsifiable ?
AI Has Taste, construit par le chercheur Zeng Zijian de l'Université UCSI, tente de transformer cette question en un système de recherche durable.
Le dépôt public du projet enregistre actuellement 453 manuscrits de recherche mathématique et 2 312 pages de contenu, dont 6 sont explicitement classés comme « Conjectures proposées par l'IA ».
Le positionnement donné sur la page d'accueil du dépôt est encore plus direct : De la génération de réponses à la génération d'agendas de recherche—de la génération de réponses à la génération d'agendas de recherche.
L'IA a renversé une conjecture dans un article, et l'auteur original l'a confirmé par réponse
AI Has Taste n'est pas parti de la conviction que « l'IA doit être douée en mathématiques ». Zeng Zijian se souvient qu'au début du projet, il n'était pas convaincu que les grands modèles puissent réellement faire avancer la recherche mathématique. Un test accidentel est devenu le tournant : il a directement confié une conjecture d'un article à l'IA, voulant initialement juste voir jusqu'où le modèle pouvait aller. En conséquence, l'IA n'a pas continué à « prouver » selon l'article, mais a construit un contre-exemple qui a directement renversé la conjecture.
Sa première réaction n'a pas été l'excitation, mais l'incrédulité. Il a donc organisé le contre-exemple et la dérivation et a écrit à l'auteur de l'article original pour vérifier. La réponse qu'il a ensuite reçue a confirmé : ce contre-exemple est valide. La recherche correspondante a ensuite été incluse parmi les plus de 450 manuscrits mathématiques actuels.
« Au début, je ne croyais pas au pouvoir de l'IA en mathématiques. Jusqu'à ce que je saisisse une conjecture d'un article, et que l'IA donne directement un contre-exemple pour la renverser ; j'ai immédiatement écrit à l'auteur original, et l'autre partie a répondu en confirmant que c'était correct. Après cela, j'ai vraiment lâché prise et je me suis investi à fond. » — Zeng Zijian
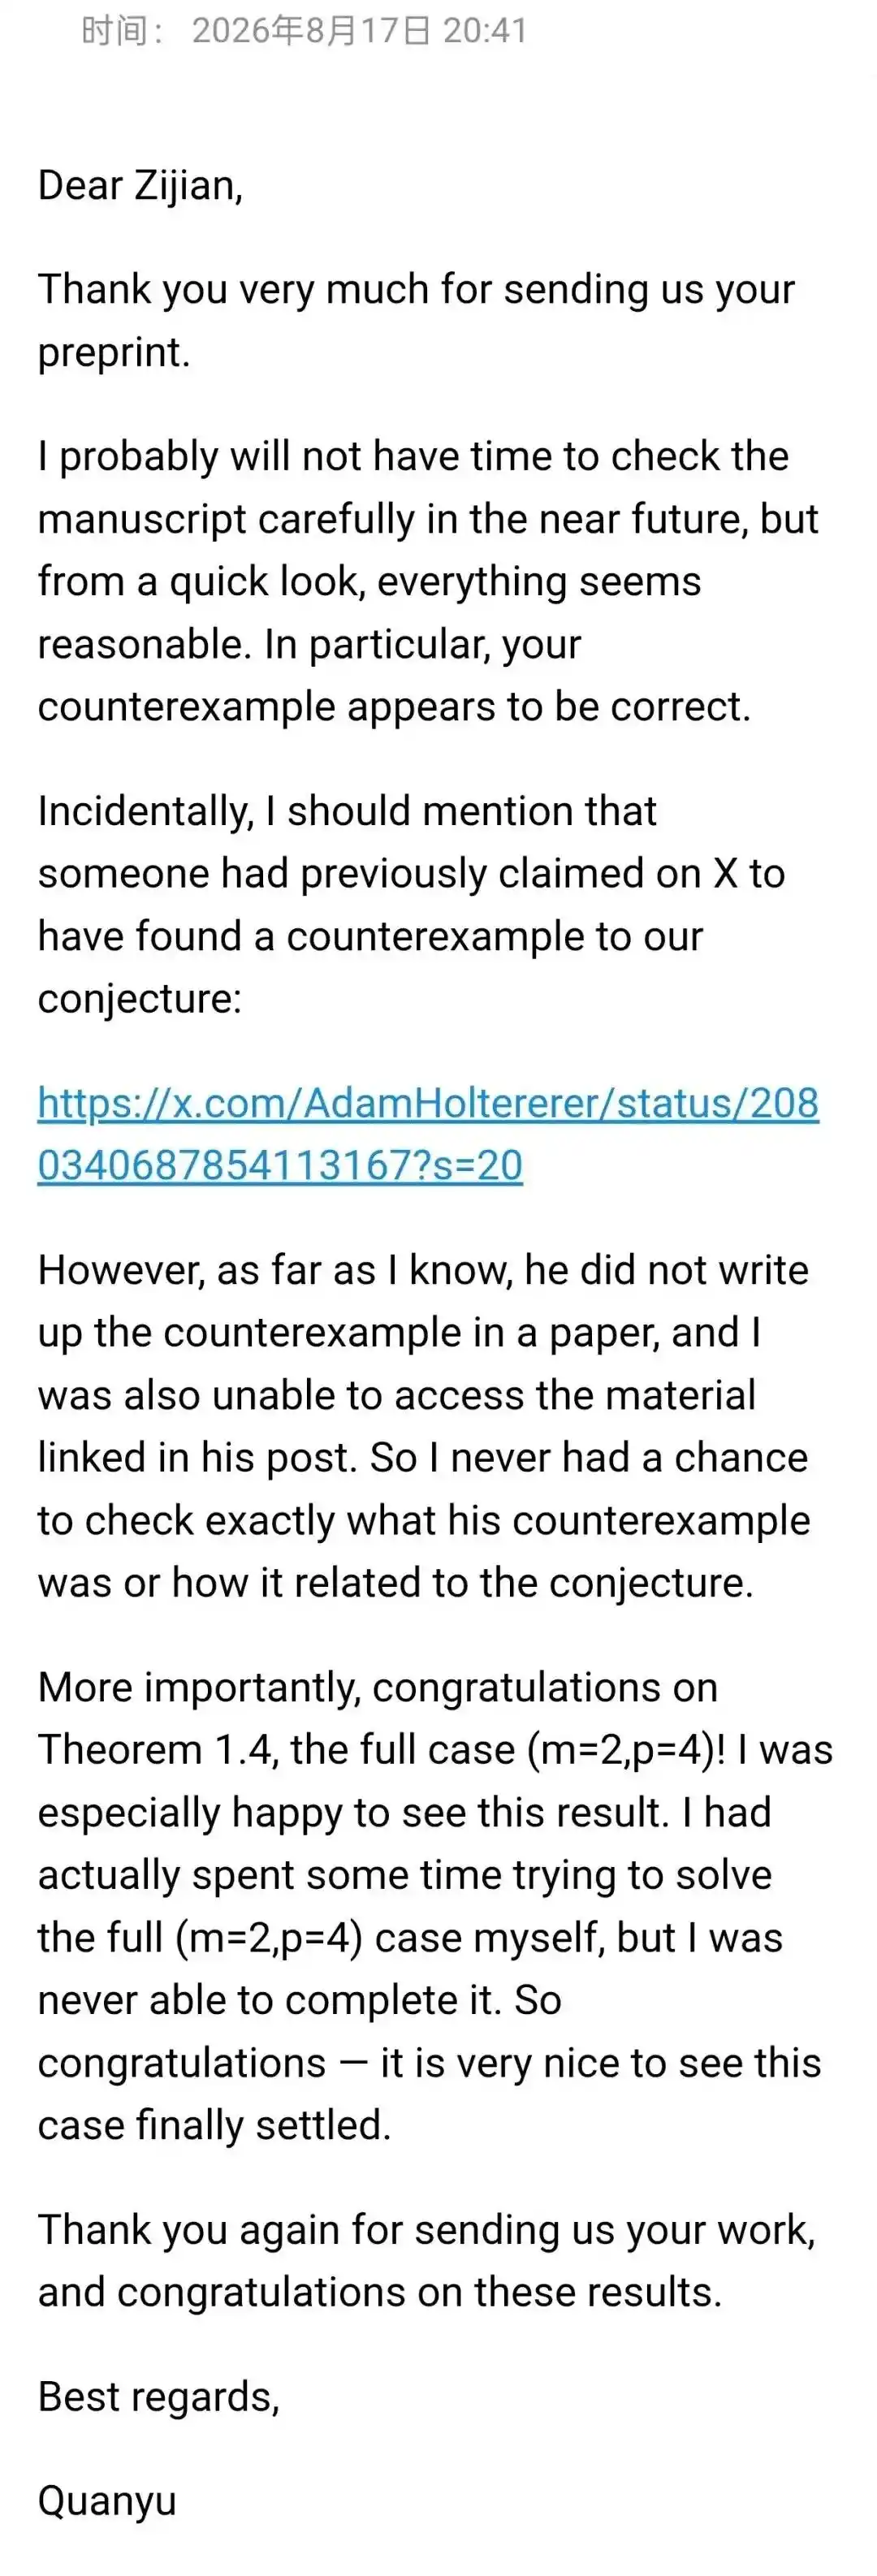
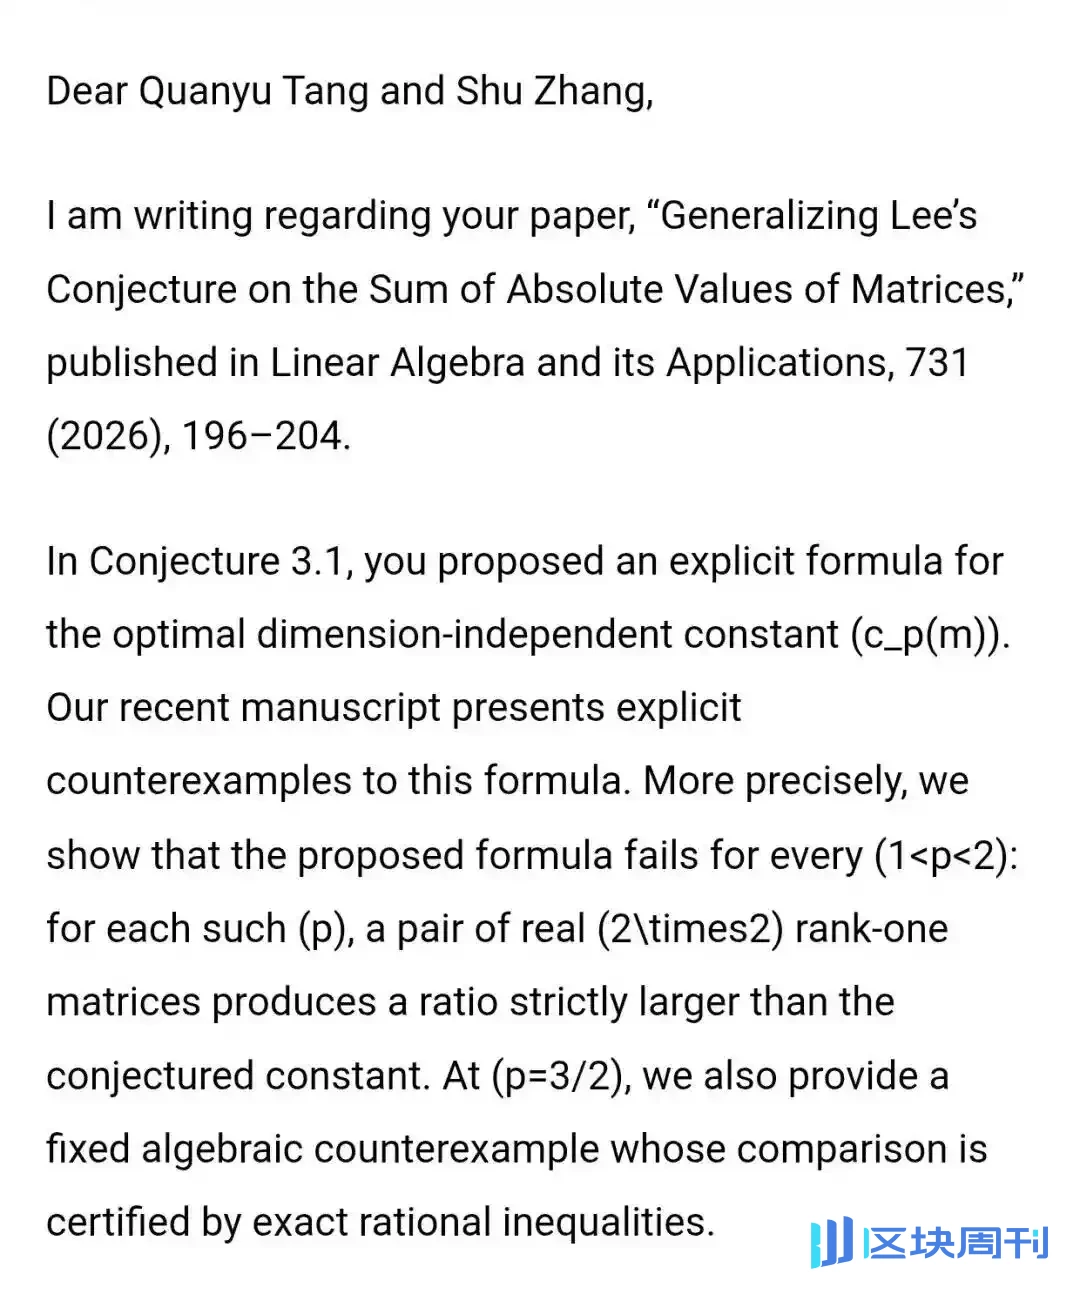
Ce que cet e-mail a changé n'était pas une seule conjecture, mais l'échelle du projet. Si l'IA peut non seulement reformuler des connaissances connues et générer un texte qui ressemble à une preuve, mais aussi attaquer activement de nouvelles conjectures dans des articles et trouver un contre-exemple confirmé par l'auteur original, alors elle a une chance d'entrer véritablement dans la « boucle de recherche ». Après cela, Zeng Zijian a commencé à agentifier progressivement la sélection des sujets, la preuve, la recherche de contre-exemples, la gestion des échecs, l'examen indépendant et la rédaction, et a laissé différentes machines fonctionner en parallèle sur le long terme.
Le vrai changement n'est pas « combien d'articles ont été écrits »
En regardant uniquement la quantité, 453 manuscrits sont déjà suffisamment frappants. Mais si ce projet n'est compris que comme « l'IA écrivant des articles mathématiques en lots », alors on manque la partie la plus remarquable.
Le projet lui-même souligne à plusieurs reprises : 453 est le nombre de « manuscrits de recherche », ce qui ne signifie pas que les 453 problèmes ouverts originaux ont tous été résolus. Les résultats comprennent des preuves complètes, des contre-exemples, des résultats partiels, des certificats de calcul fini, des réductions structurées et des articles proposant de nouvelles conjectures. L’examen interne par IA ne équivaut pas non plus à un examen par les pairs externe.
Le véritable changement se produit dans la chaîne de recherche. Les benchmarks d’IA traditionnels partent souvent de « le problème a déjà été donné » : les humains choisissent le sujet, l’IA le résout, et finalement il y a succès ou échec. AI Has Taste étend le processus à la fois en amont et en aval — l’IA peut filtrer des problèmes candidats, comparer des voies et chercher activement des contre-exemples ; après l’échec d’une voie, elle peut aussi analyser la structure de l’échec, modifier la proposition et confier de nouveaux objets mathématiques à un autre Agent indépendant pour continuer à attaquer.

La clé d’AI Has Taste n’est pas « plus de prompts », mais de transformer l’échec en entrée pour le cycle de recherche suivant.
Agents de sélection de sujet, de preuve, de détection d’erreur et de rédaction
Ce système n’est pas « un seul modèle qui se pose des questions et y répond dans une seule boîte de dialogue ». Le README public divise les rôles des Agents en quatre couches :
Supervisor / Screener est chargé de sélectionner les candidats, de comparer les résultats voisins et de trouver l’expérience décisive la moins coûteuse ;
Researcher est chargé des preuves, des contre-exemples et des calculs exacts ;
Fresh-context Reviewer attaque spécifiquement les propositions gelées, les lemmes clés et les certificats dans un nouveau contexte ;
Writer / Release Checker est chargé de rédiger clairement le périmètre final accepté et de vérifier les citations, les builds et les documents de publication.
Zeng Zijian a en outre déployé le flux de travail sous forme de collaboration multi-machines : différentes machines peuvent faire avancer séparément les preuves, rechercher des contre-exemples, exécuter des calculs exacts et mener un examen indépendant. Ce qui est partagé, ce sont les propositions gelées, les enregistrements d’expériences, les raisons des échecs, le code et les preuves, plutôt que de laisser un Agent générer des résultats tout en s’accordant sa propre approbation.

La conception centrale du multi-agent : séparation des rôles + preuves partagées + examen en contexte frais.
Il y a une phrase dans le dépôt qui résume très bien cette conception : La critique fait partie du moteur, non de l’épilogue. La critique n’est pas une procédure ajoutée après la rédaction de l’article, mais une partie du moteur de recherche.
Mathématiciens, roboticistes et spécialistes de l’automatisation entrent dans la chaîne de vérification
À mesure que les manuscrits de recherche passaient de quelques dizaines à plusieurs centaines, une autre question devenait plus aiguë : qui juge que ces sorties d’agents ne sont pas des hallucinations systématiques ?
AI Has Taste utilise en interne un Fresh-context Reviewer pour séparer « recherche » et « détection d’erreurs », mais le projet ne traite pas l’auto-examen par IA comme le point final.
Au fur et à mesure de l’avancement des travaux, Zengzaijian a également commencé à inviter de véritables chercheurs de différents domaines à participer à la vérification, à l’examen et à la discussion académique de certains résultats.
Selon l’équipe du projet, les collaborateurs et évaluateurs impliqués dans une partie du travail comprennent : Ong Seng Huat, Fellow de l’Académie des sciences de Malaisie et professeur honoraire à l’Institut des sciences mathématiques de l’Université de Malaisie ; Kurunathan Ratnavelu, Fellow de l’Académie des sciences de Malaisie et professeur honoraire à l’Institut des sciences mathématiques de l’Université de Malaisie ; et le professeur Xiong Yonghua de l’École d’intelligence artificielle et d’automatisation de l’Université chinoise des géosciences (Wuhan).
Ici, il est nécessaire de distinguer « participer à la vérification » de « approuver tous les résultats » : les chercheurs mentionnés ci-dessus n'ont pas validé les 453 manuscrits un par un, mais ont plutôt vérifié, examiné ou discuté certains des problèmes, preuves, résultats computationnels ou directions de recherche.
Pour un système de recherche scientifique hautement automatisé, cette combinaison de « red teaming machine interne + vérifications/examens ponctuels par des experts humains » est, au contraire, plus critique que de confier toute l'évaluation au même ensemble d'agents.
L'IA est responsable de pousser la vitesse de recherche à sa limite ; les experts humains sont responsables de ramener « semble valide » à « digne de confiance » aux nœuds clés.
Après l'échec, une meilleure question a été choisie
Le cas du projet qui incarne le mieux le « goût pour la recherche » n'est précisément pas un beau succès, mais un échec.
Sur le problème de la trace gaussienne fractionnaire, le système a d'abord essayé des routes de monotonie et d'appariement unilatéral, mais des contre-exemples exacts ne cessaient d'apparaître. Un benchmark ordinaire n'aurait généralement laissé qu'une seule étiquette ici : ÉCHEC.
Mais ce flux de travail ne s'est pas arrêté. L'agent a continué à demander : qu'a exactement cassé le contre-exemple ? L'échec a-t-il une structure stable ? Finalement, la recherche a déplacé son attention vers un défaut négatif fixe, a construit une structure de correction à dix termes et a proposé une nouvelle conjecture d'uniformité bornée. Plus crucial encore, la nouvelle conjecture a ensuite été attaquée à son tour par une autre ronde de calcul exact et d'examen indépendant. Le balayage des archives publiques a atteint l'indice 1004 ; cette borne unifiée n'a toujours pas été prouvée.
La signification de cette affaire n'est pas que « l'IA a prouvé un autre grand théorème » — en fait, elle ne l'a pas fait. La signification est que : le problème original n'a pas été résolu, mais la route échouée a été compressée en une nouvelle proposition plus claire, plus falsifiable et, une fois qu'elle tient, capable de se reconnecter au problème original. La recherche ne s'est pas terminée à l'échec, mais a fait croître le problème suivant à partir de l'échec.
Autrefois : les humains posaient les problèmes, l'IA y répondait. Maintenant : l'IA répond aux problèmes, et commence aussi à participer à la décision de « quel est le prochain problème ».
6 nouvelles conjectures de l'IA
À ce jour, dans l'instantané public actuel, le dépôt classe séparément 6 articles sous « Conjectures proposées par l'IA ». Ces travaux couvrent la combinatoire, la théorie des graphes, la théorie des nombres et des problèmes de type analytique, notamment la non-singularité des matrices infinies à noyau binaire pour trois sous-suites de A182510, la colorabilité CDS des diagrammes de Young, la décomposition des graphes sans triangle de degré maximal au plus 6, les formules de congruence unaires-thêta pour les partitions de Frobenius généralisées à 18 couleurs, la non-négativité des coefficients de Newton pour les dénominateurs de sous-sommes réciproques sur des étapes dyadiques, et la conjecture de défaut fixe mentionnée ci-dessus pour la trace gaussienne fractionnaire.
Ce qui mérite vraiment l'attention n'est pas de savoir si l'IA peut « brainstormiser une conjecture ». Deviner une phrase au hasard n'est pas difficile. Ce qui est difficile, c'est d'écrire la conjecture sous forme de définition précise, d'expliquer d'où elle vient, quelles preuves la soutiennent, quels contre-exemples pourraient la renverser, quels résultats elle entraînerait si elle tient, et de laisser le calcul et le code source pour un examen ultérieur.
C'est aussi pourquoi le projet considère « proposer des conjectures » comme une action de recherche de niveau supérieur à « générer des réponses » : les preuves répondent aux questions existantes, tandis que les conjectures changent où les ressources de recherche ultérieures sont investies.
Derrière 453 manuscrits se trouve le prototype de la « recherche scientifique à l'échelle des agents »
AI Has Taste a actuellement publié publiquement 453 manuscrits de recherche, totalisant 2312 pages ; parmi eux, le flux de travail BigWIN2 seul correspond à 223 manuscrits, et fournit des packages appariés de matériel LaTeX/reproduction pour ces 223 travaux.
Ce qui est le plus contre-intuitif à cette échelle n'est pas que « l'IA tape vite ». Ce qui est vraiment coûteux dans la recherche mathématique, c'est le changement de contexte : ce problème nécessite la théorie des graphes, le suivant la théorie des nombres, et le suivant peut nécessiter SAT, recherche exhaustive, arithmétique rationnelle exacte ou calcul matriciel. Un chercheur humain ne peut pas maintenir simultanément des centaines de lignes de pensée complètement différentes, mais un système d'agents peut les diviser en tâches indépendantes et préserver les routes échouées, les théorèmes locaux et les expériences reproductibles.
Ainsi, le rôle du chercheur individuel change : non pas dériver personnellement chaque étape, mais plutôt comme un PI — fixer les limites de recherche, choisir le pool de problèmes, décider quels résultats méritent de continuer à investir, quand s'arrêter, et quelles conclusions sont qualifiées pour être rendues publiques.
Pourquoi cela s'appelle-t-il « L'IA a du goût » ?
« L'IA a du goût » sonne très anthropomorphique, mais le README du projet fixe délibérément une limite : le goût ici n'est ni une conscience ni une expérience subjective, mais un « jugement mathématique exprimé à travers des décisions de recherche ».
Par exemple : si les deux problèmes peuvent être traités, lequel d'abord ? Une voie a déjà des progrès locaux, mais les rendements marginaux deviennent de plus en plus faibles — faut-il s'arrêter ? Un contre-exemple est-il une condamnation à mort pour la proposition, ou montre-t-il que le vrai théorème devrait être formulé différemment ? Un petit résultat suffit-il à constituer à lui seul un article ? Ces décisions étaient généralement implicites dans l'expérience des chercheurs par le passé et étaient difficiles à mesurer par des benchmarks standards.
L'IA a du goût tente de laisser une trace inspectable de ces décisions : quel problème a été choisi, pourquoi la voie a été changée, quelle structure l'échec a laissée derrière lui, d'où vient la proposition suivante, et comment la nouvelle conclusion a été à nouveau attaquée par un contexte indépendant.
À quelle distance se trouve-t-on d'un « mathématicien autonome » ?
L'endroit où ce projet est le plus facilement exagéré doit aussi être clarifié. 453 manuscrits ne sont pas 453 articles de revues ayant subi une évaluation par les pairs formelle ; l'évaluation interne par des agents n'est pas équivalente à une évaluation indépendante par la communauté mathématique ; et la portée couverte par un calcul fini ne peut pas être automatiquement généralisée au cas infini. Le dépôt lui-même énonce explicitement ces limites.
Mais si l'on ignore sa manière d'organiser la recherche simplement parce que ces résultats n'ont pas tous achevé une vérification externe, on manquerait aussi un autre changement : la frontière des capacités de l'IA passe de « exécuter une tâche donnée » à « participer à la conception de la tâche suivante ».
Les ressources véritablement rares dans la recherche mathématique n'ont jamais été seulement la puissance de calcul et la longueur de raisonnement, mais aussi : quels problèmes valent la peine qu'on y consacre du temps, quels échecs valent la peine d'être conservés, et quand le sujet doit être changé.
Lorsque l'IA commence à entrer dans ces maillons, la compétition dans « l'IA pour les mathématiques » ne se limite plus à « qui est meilleur pour prouver », mais deviendra progressivement : qui a une meilleure boucle de recherche, et qui peut distiller à partir d'un grand nombre d'échecs les directions qui valent davantage la peine d'être poursuivies.
Une dernière chose
Le récit passé de la recherche scientifique par l'IA ressemblait beaucoup à un super étudiant : le professeur pose les problèmes, et il est responsable de les résoudre.
Ce que L'IA a du goût veut faire ressemble davantage à un groupe de recherche : les humains fournissent les limites et les jugements de valeur, et les agents trouvent des problèmes, testent des problèmes, se trompent, se renversent eux-mêmes, laissent des résultats locaux, puis proposent le problème suivant.
Si cette voie continue de tenir, la division du travail homme-machine la plus importante dans la recherche fondamentale future pourrait passer de « les humains sont responsables de la réflexion, l'IA est responsable du calcul » à une structure plus complexe : les humains sont responsables des objectifs, des valeurs et de la responsabilité ultime ; l'IA entreprend la recherche à grande échelle, la vérification, la gestion des échecs et la génération de directions de recherche candidates ; les outils formels et les preuves publiques sont responsables de rendre les résultats vérifiables.
Après que l'IA peut résoudre des problèmes, le prochain obstacle pourrait vraiment être : l'IA peut-elle choisir des problèmes ?
Cet article provient du compte public WeChat « Xin Zhi Yuan », auteur : Xin Zhi Yuan