
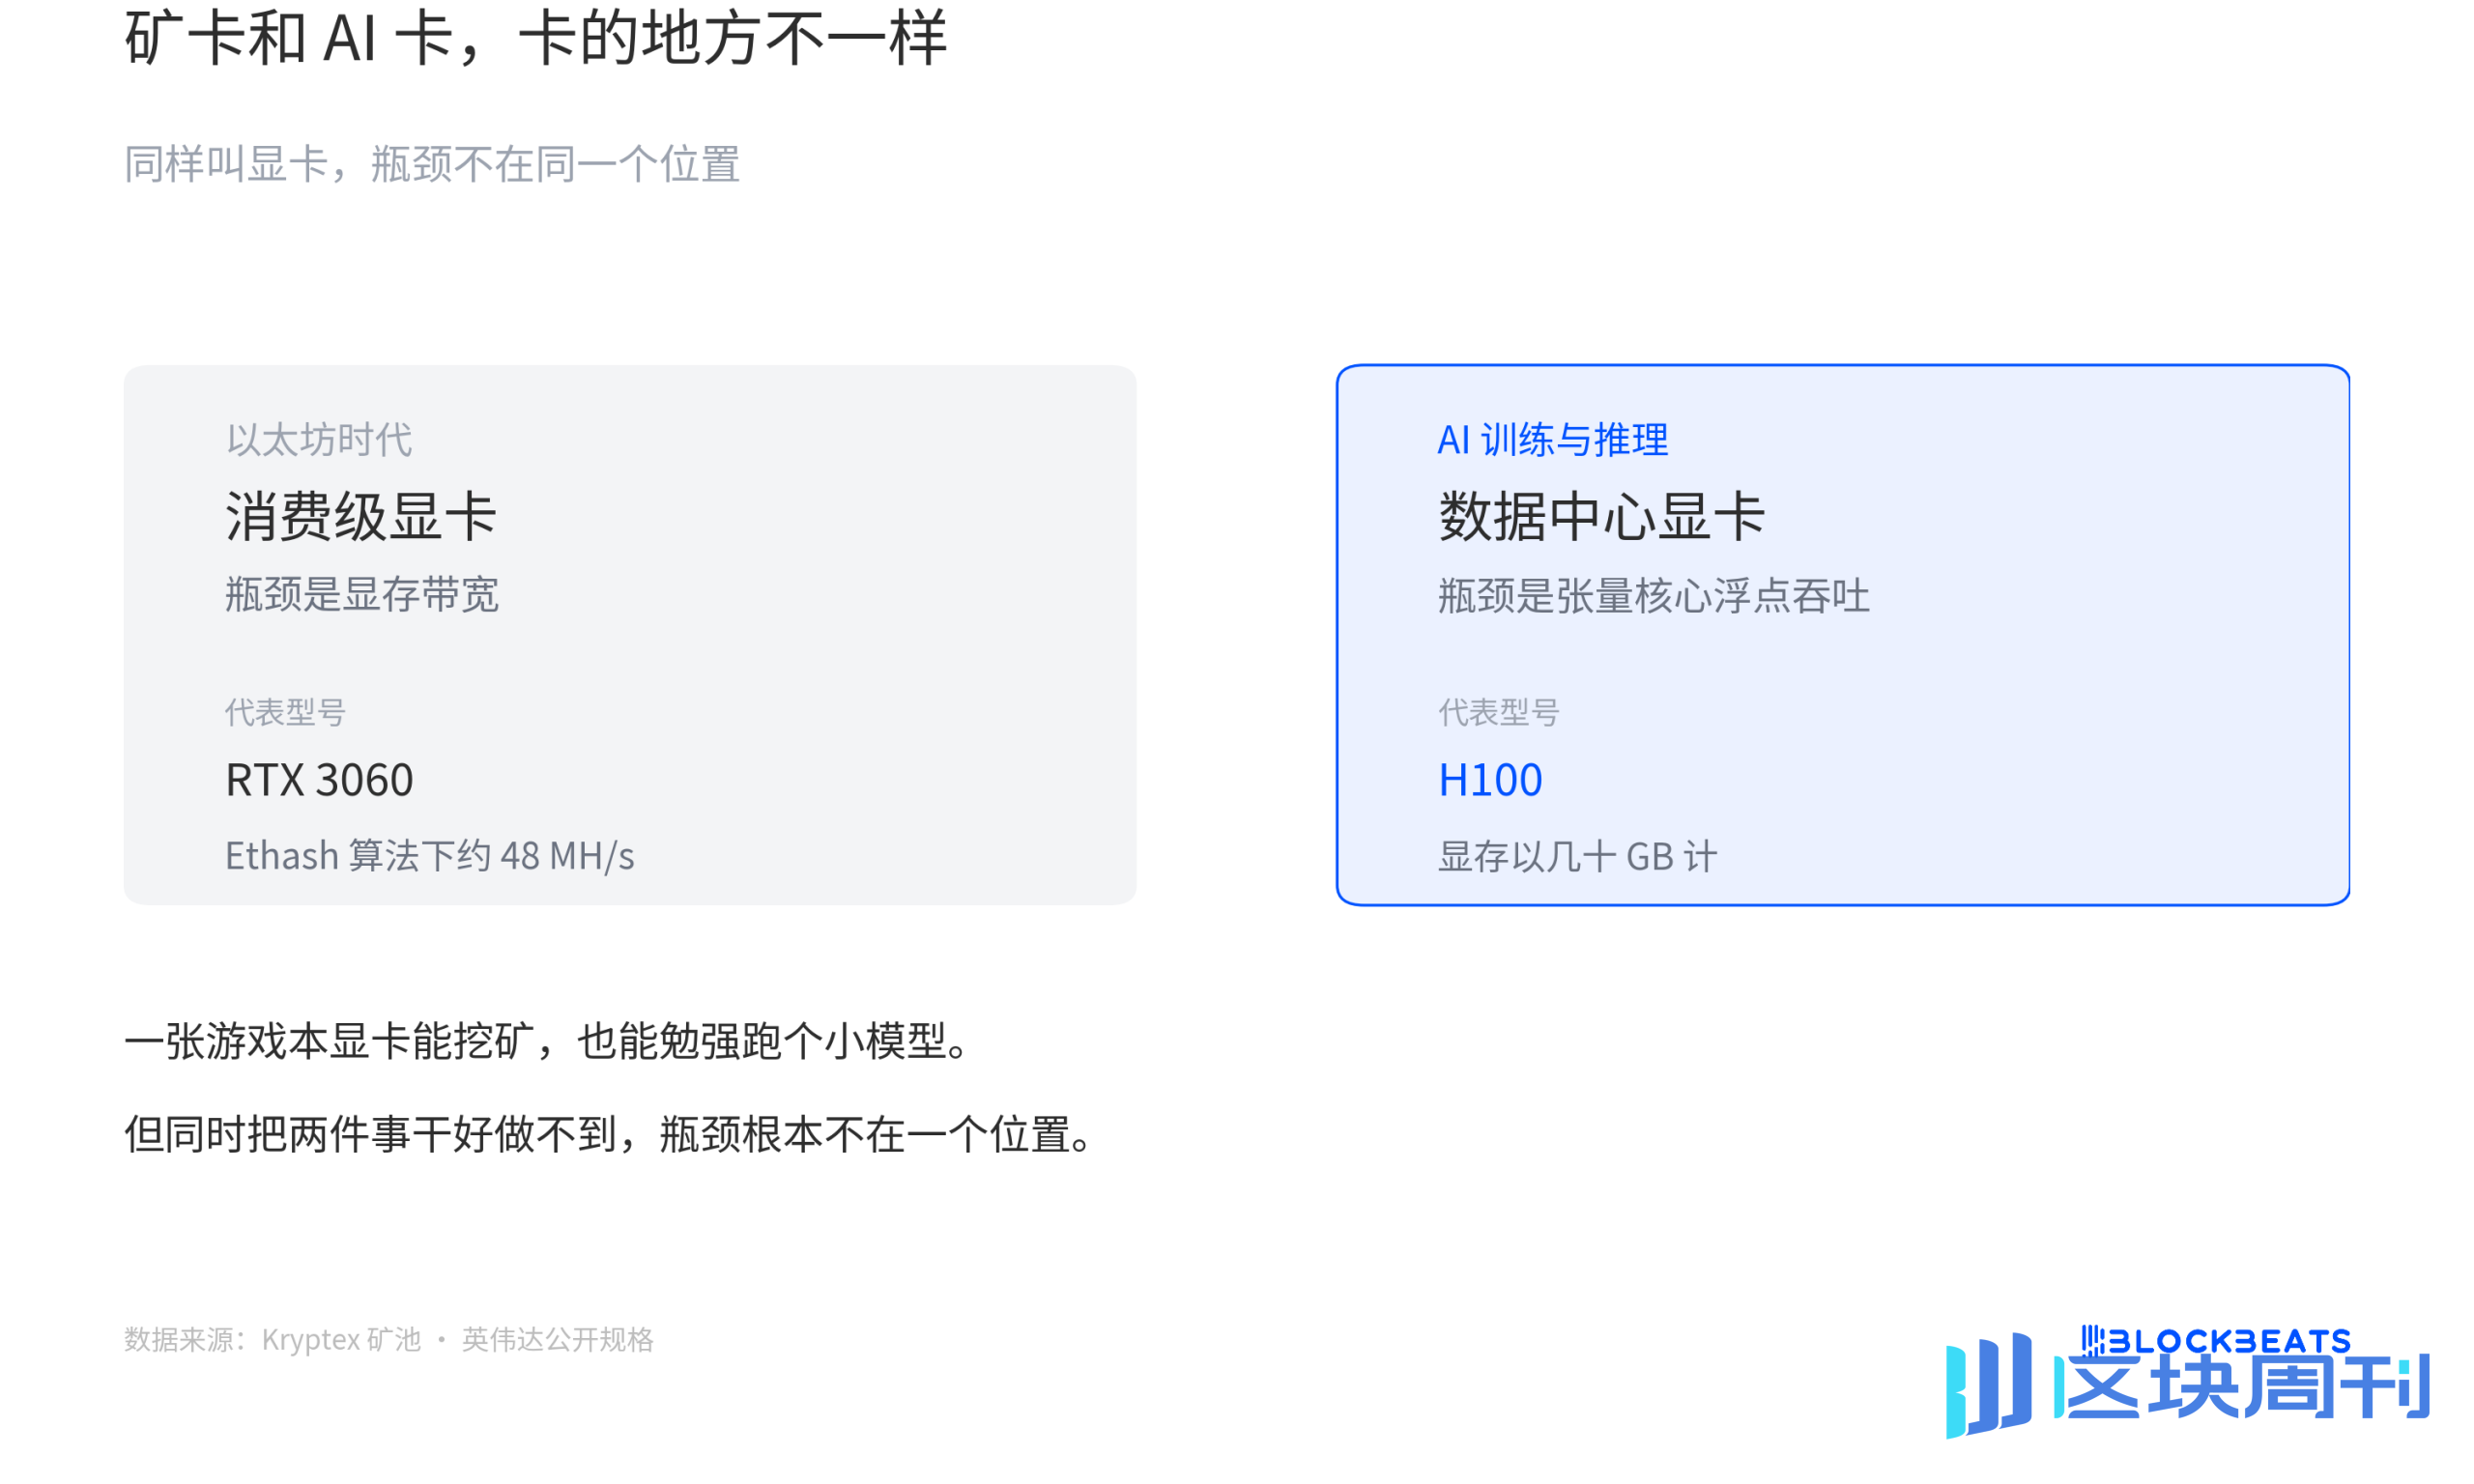
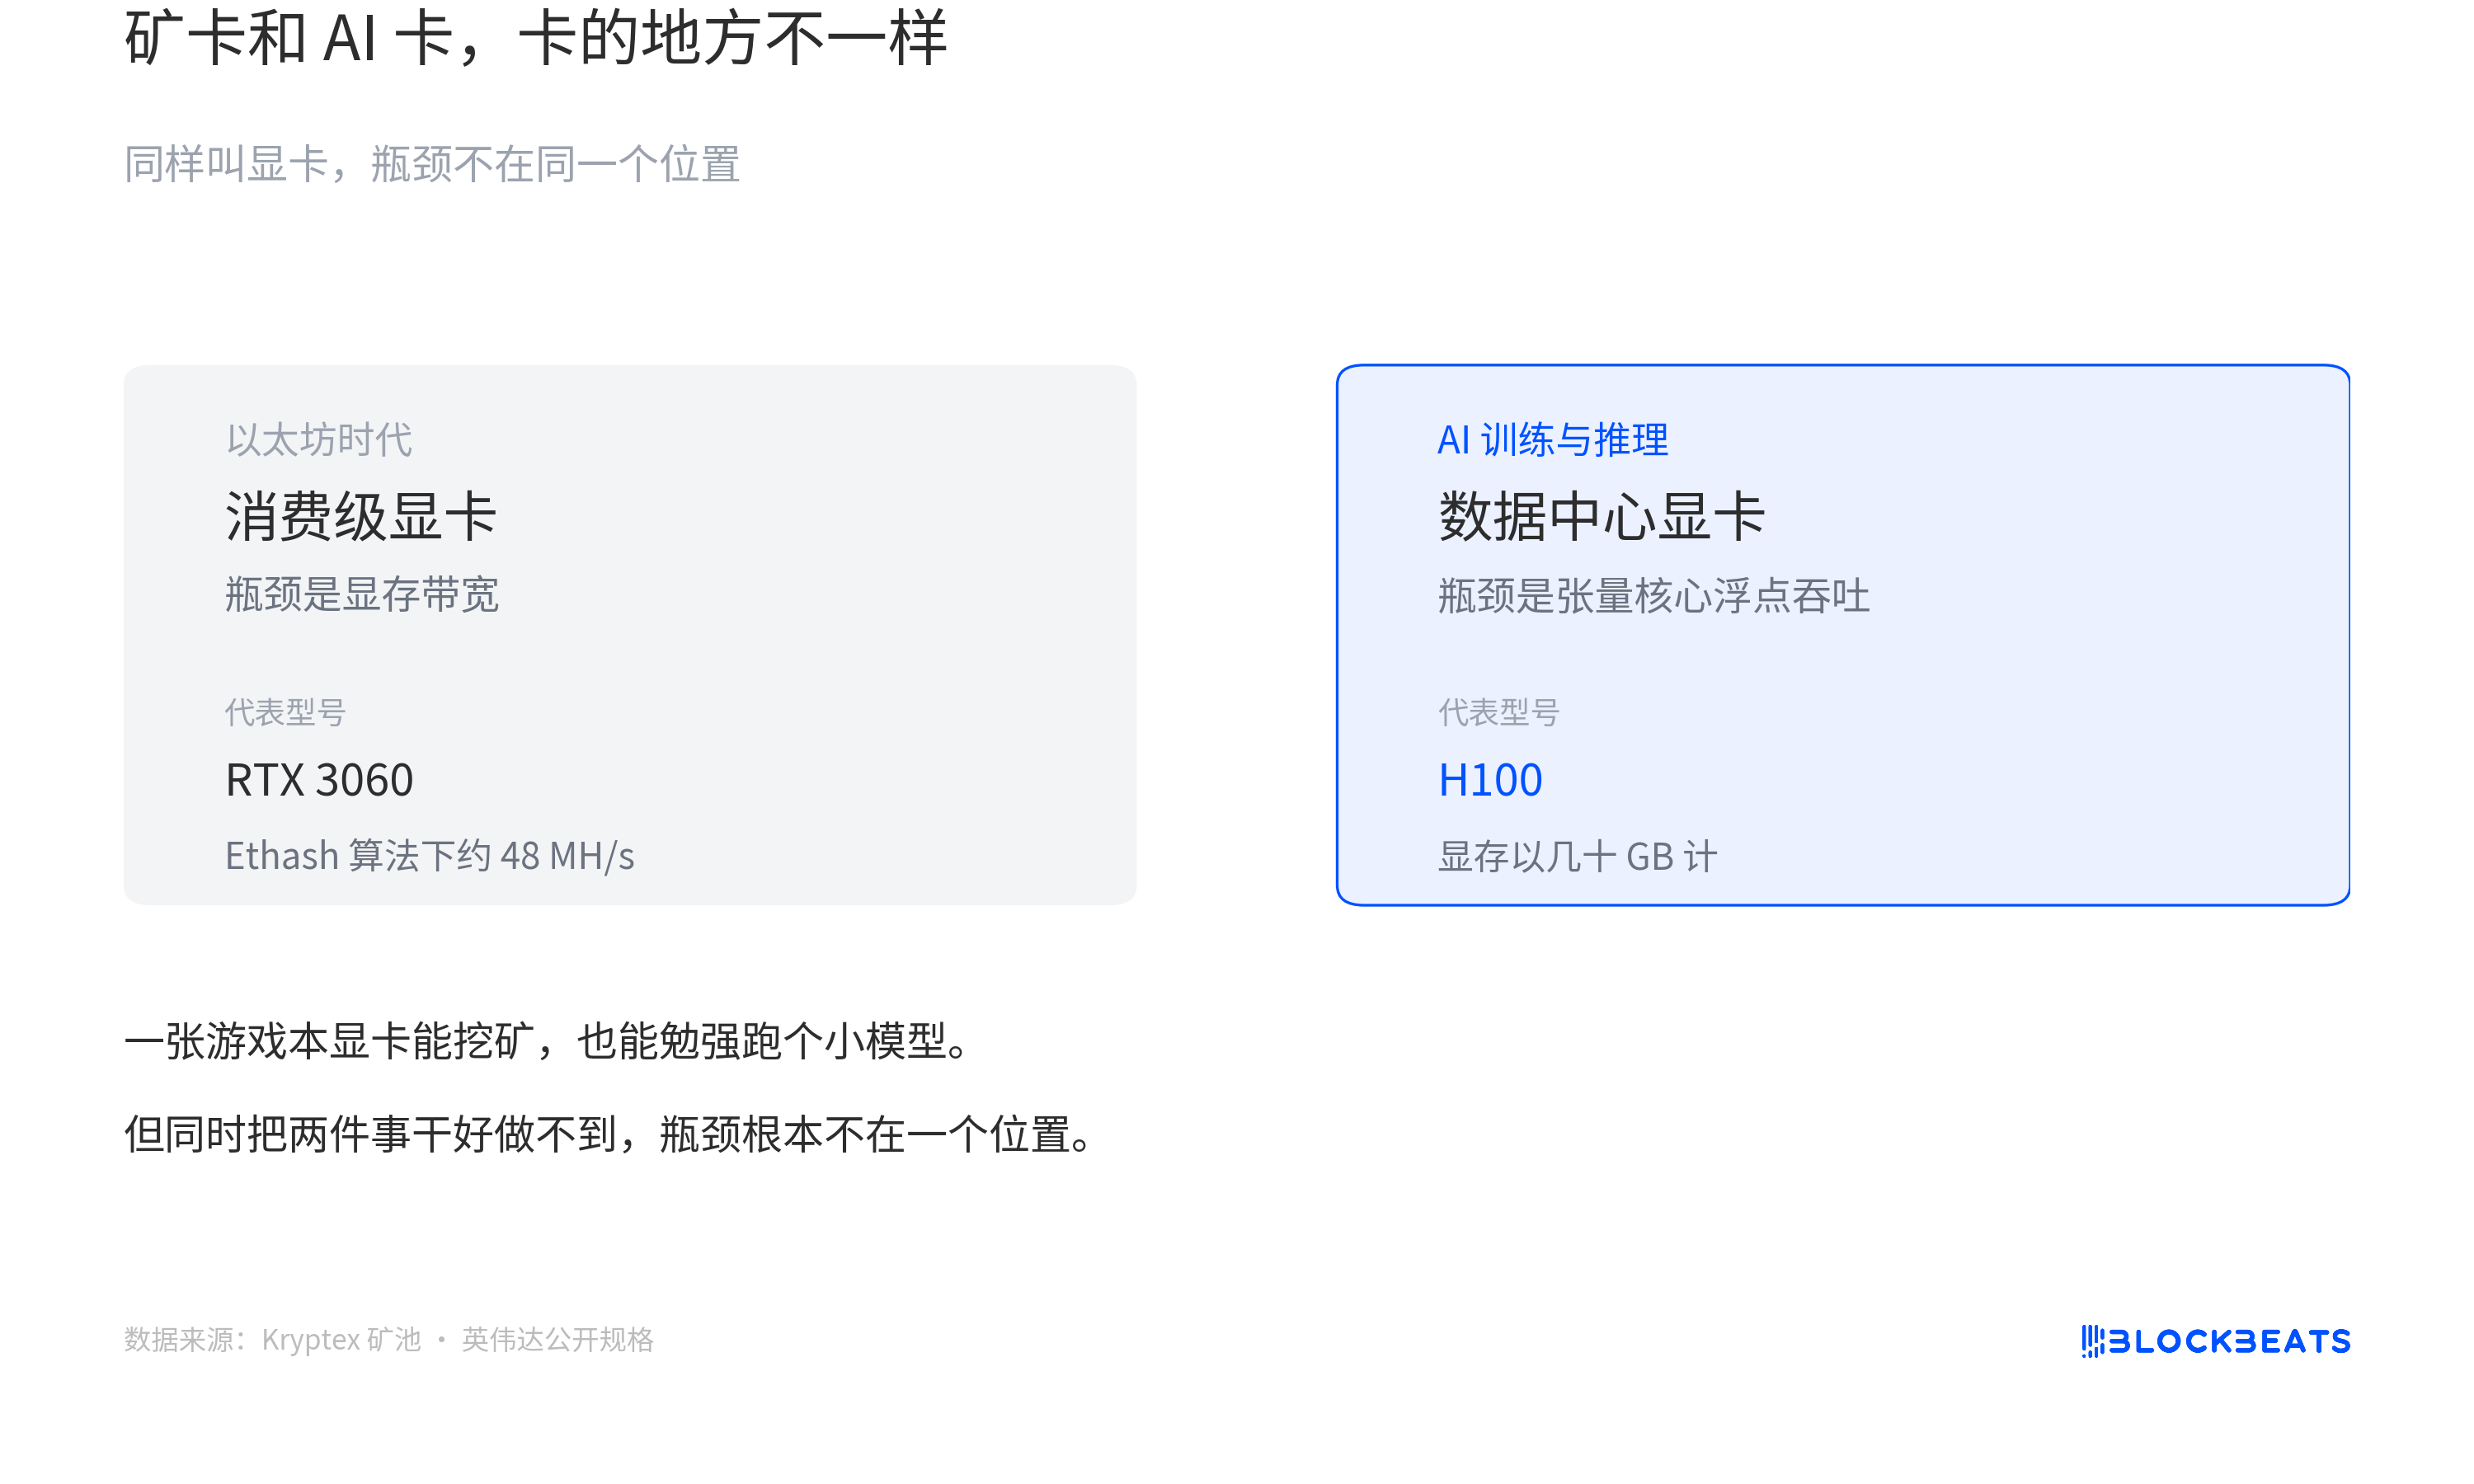
Durante los años en que Ethereum todavía era POW, los mineros usaban tarjetas gráficas de consumo, y el algoritmo se llamaba Ethash. Una RTX 3060 hace alrededor de 48 MH/s en Ethash. En ese momento, algunas personas pensaron que, dado que tanto la minería como la IA dependen de tarjetas gráficas, ¿podría la misma tarjeta minar y ejecutar modelos al mismo tiempo?
Esta idea no funcionó porque las dos cosas tienen cuellos de botella en lugares diferentes. Ethash está limitado por el ancho de banda de memoria y calcula hashes de dificultad fija. La IA necesita rendimiento de punto flotante de núcleos tensoriales y decenas de GB de VRAM, con las principales caballos de batalla siendo tarjetas de centro de datos como la H100. Una tarjeta gráfica en una laptop para juegos puede minar y apenas puede ejecutar un modelo pequeño, pero no puede hacer ambas cosas bien al mismo tiempo.
En 2019, Vitalik Buterin hizo un juicio sobre este asunto. Sus palabras originales fueron que si se pudiera encontrar algún tipo de computación útil y fácilmente verificable, la minería de criptomonedas se convertiría en una enorme riqueza para la sociedad, pero esto es probablemente imposible.
Pearl afirma que lo ha logrado. El juicio de Vitalik de hace unos años se muestra de manera prominente en el sitio web oficial de Pearl.
Pearl es una cadena pública independiente de prueba de trabajo, y su token se llama PRL. Los mineros ya no calculan hashes repetidamente; en su lugar, hacen multiplicación de matrices, que es el tipo de multiplicación-suma que realiza cada capa de una red neuronal. Por diseño, la misma computación de GPU tanto produce bloques como emite monedas, y también produce computación de IA verificable.
La descripción oficial de esto es "energía, datos y dinero en una sola operación". Bitcoin vincula energía y dinero, la IA vincula energía y datos, y la monetización vincula datos y dinero. Estas tres cosas solían encontrarse de a dos; Pearl quiere que las tres ocurran simultáneamente en una multiplicación de matrices.
La línea de PoW ha estado tranquila durante mucho tiempo. El último lote de nuevas cadenas públicas que podían hacer que la gente se sentara y las discutiera seriamente básicamente terminó hace años. Después de eso, la emoción ha estado en L2s, modularidad y restaking. Una nueva cadena PoW en sí misma es rara. Ahora PRL, con una capitalización de mercado circulante de 430 millones de USD, quiere contar qué tipo de historia?
Qué problema quiere resolver
La prueba de trabajo de Bitcoin tiene una característica: lo que los mineros calculan no tiene nada que ver con el mundo real. El mismo kilovatio-hora, si se usa para ejecutar modelos, puede producir tokens, generar imágenes y hacer trabajo. Muchas personas sienten que es un poco desperdicio usarlo para minería.
La verdadera dificultad no es la "utilidad", sino la permisividad. Permisividad significa que cualquiera puede venir a minar, sin registrarse, y nadie revisa las calificaciones. El modelo de seguridad de Bitcoin se basa en esto: sin importar lo que calcules, el costo es el mismo. Una vez que el trabajo se reemplaza con algo de valor del mundo real, los mineros tienen un incentivo para hacer trampa o elegir una entrada barata. Así que la pregunta no es si se puede hacer útil la minería, sino si se puede hacer útil mientras nadie puede hacer trampa.
La propia afirmación de Pearl es que reemplaza el hashing aleatorio de Bitcoin con multiplicación de matrices, permitiendo que las GPU traten la prueba de trabajo como un subproducto de las cargas de trabajo de IA. El whitepaper usa directamente el término "2 por 1". En términos simples, anteriormente un lote de GPU tenía solo dos destinos: o minar, quemando electricidad mientras emite monedas, o ejecutar modelos, quemando electricidad mientras produce tokens. Pearl quiere fusionar estos dos destinos en uno.
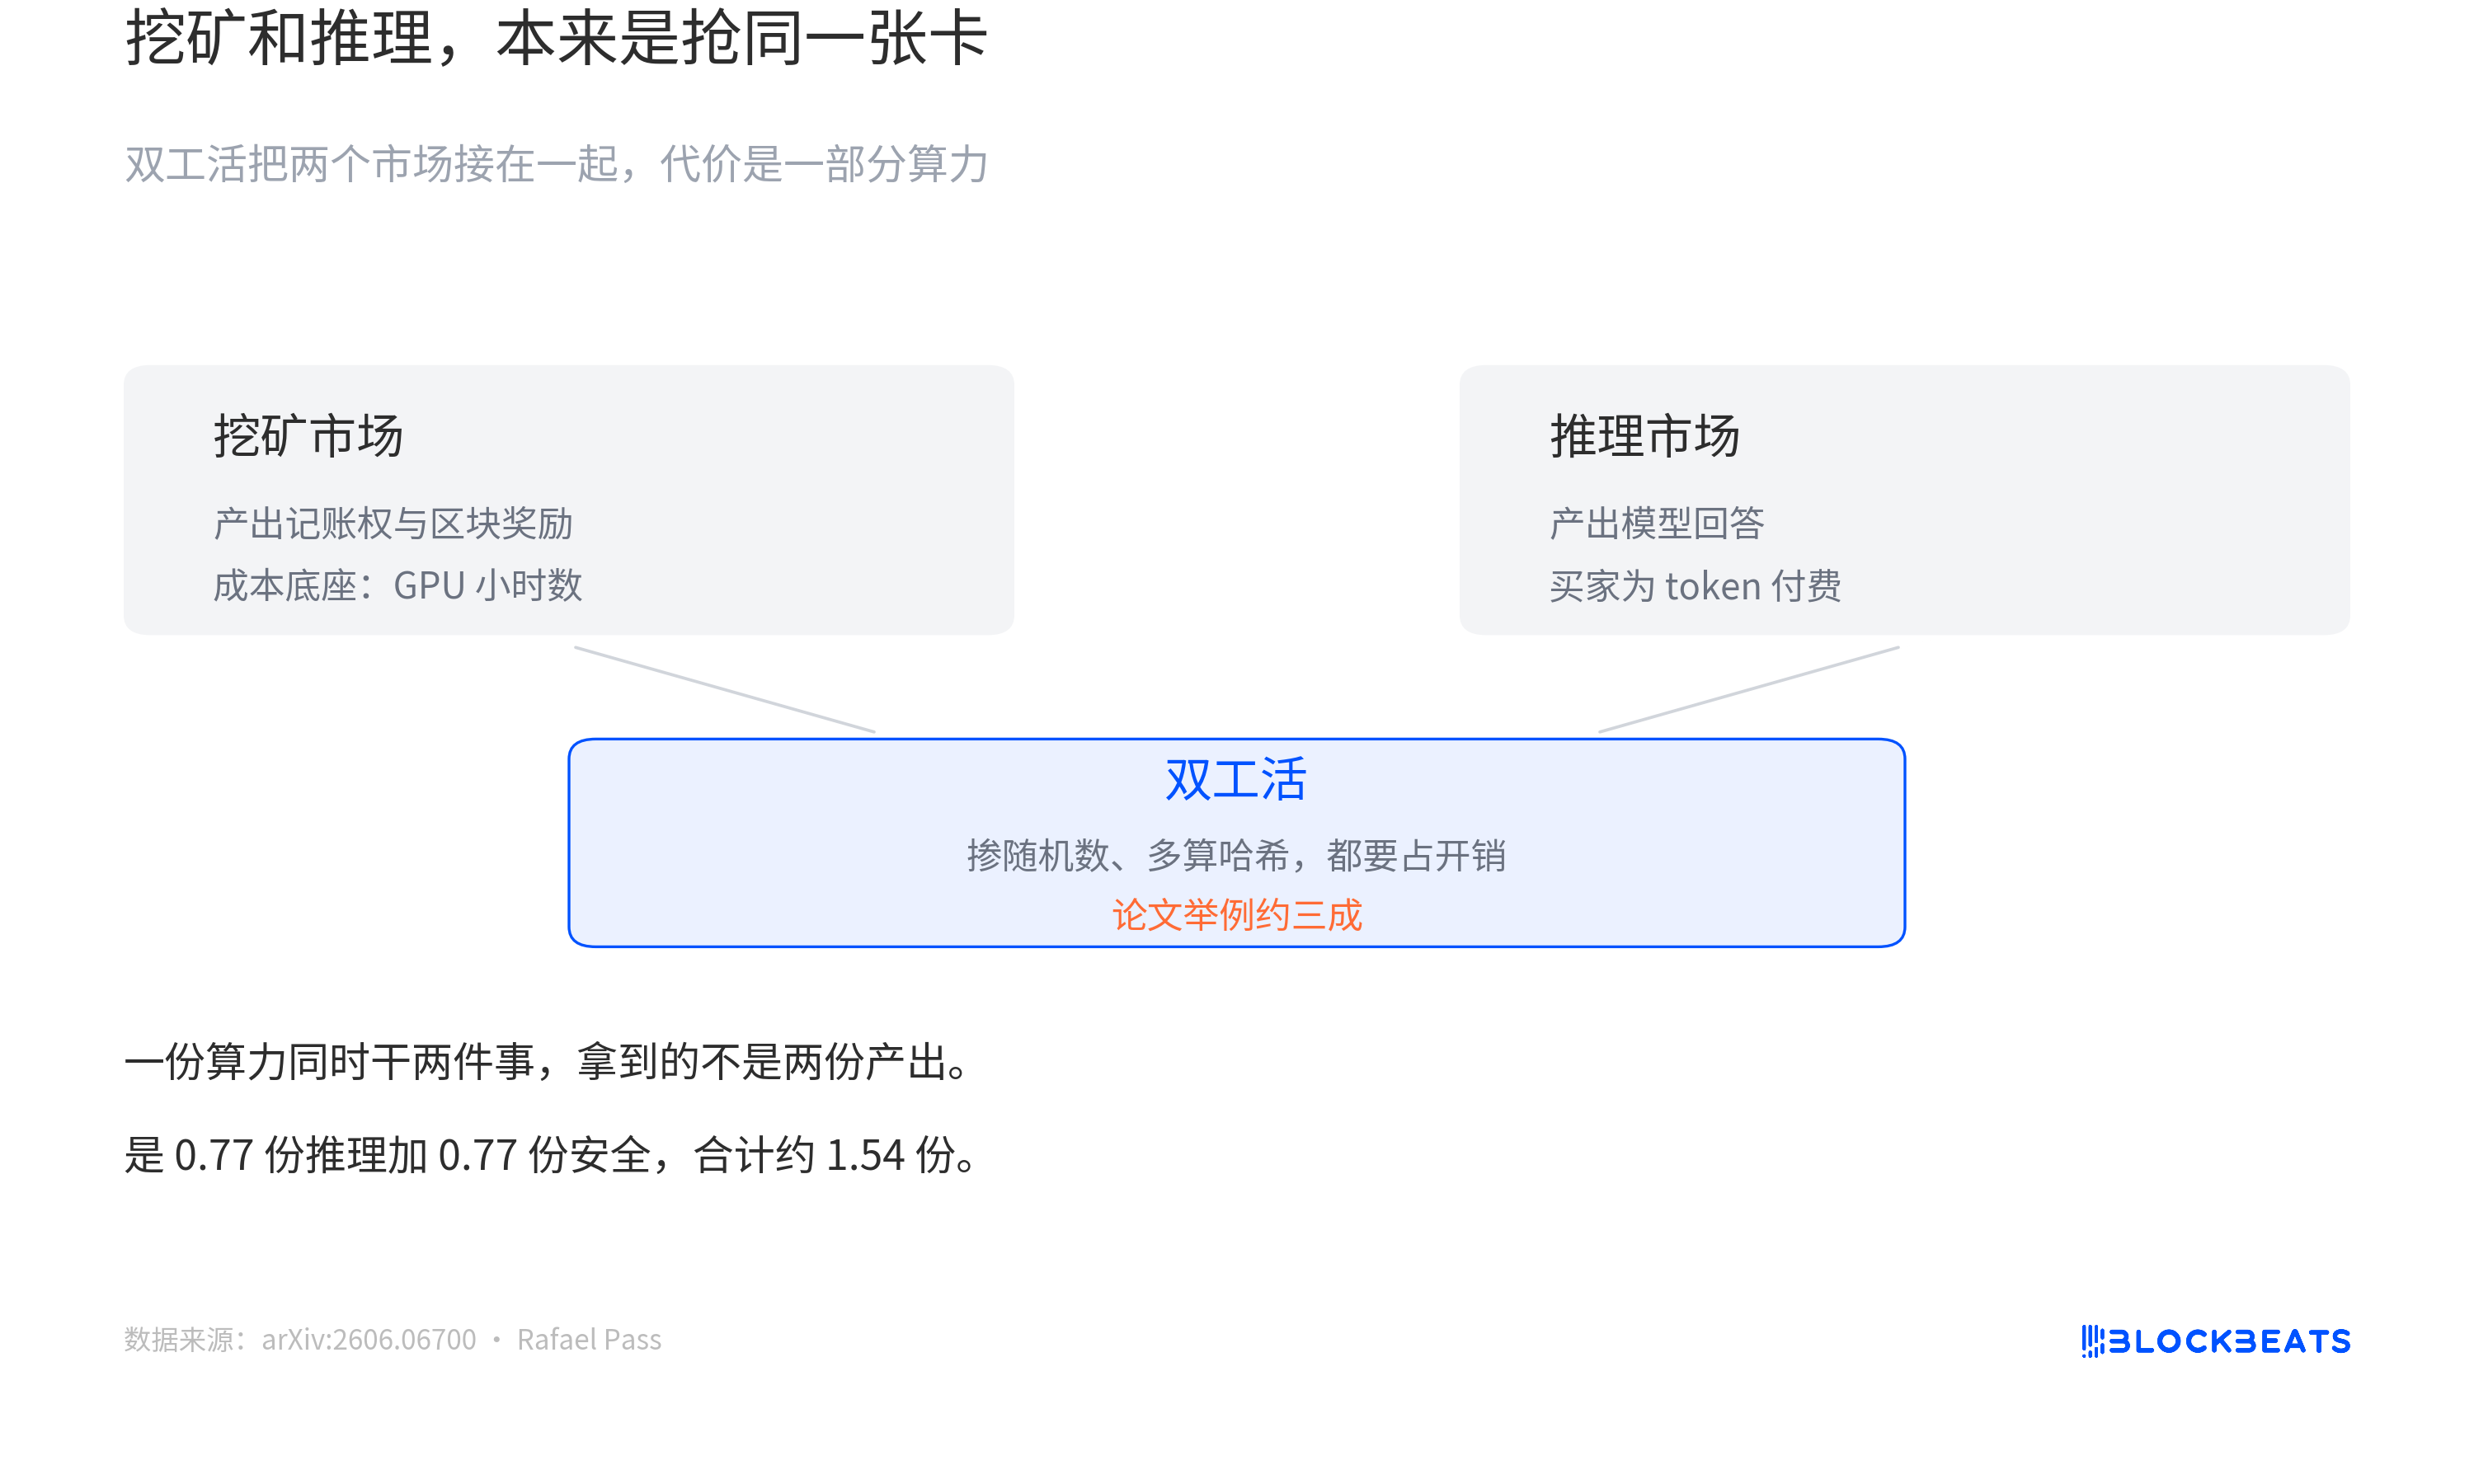
Alguien ha calculado esta idea en detalle. El paper del investigador en criptografía Rafael Pass "The Economics of Proof-of-Useful-Work" divide el trabajo de una máquina en tres tipos: minería pura, inferencia pura y trabajo dual que produce ambos simultáneamente. El trabajo dual no es gratis. El paper da un ejemplo: una unidad de poder de cómputo haciendo dos cosas a la vez no obtiene dos salidas, sino aproximadamente una y media. Si la sobrecarga es lo suficientemente pequeña y la escala a la que el token es aceptado por el mercado es lo suficientemente grande, la recompensa de bloque es equivalente a dar un reembolso en el precio de inferencia, atrayendo poder de cómputo de inferencia que de otro modo no se habría hecho. Este razonamiento es matemáticamente impecable, pero el problema es que sus tres variables—sobrecarga, precio del token y demanda de inferencia—no son algo que Pearl pueda decidir por sí misma. Una nota al pie en el paper revela que el autor completó este trabajo mientras consultaba para Pearl Research Labs.
La lógica operativa de Pearl
Para explicar cómo funciona este sistema, primero debemos desglosar el término multiplicación de matrices. No fue inventado por Pearl; es una operación muy antigua, y casi todas las capas de una red neuronal la utilizan.
Una matriz es una tabla de números ordenados por filas y columnas. Dos tablas se pueden multiplicar si el número de columnas de la primera es igual al número de filas de la segunda. Cada celda de la tabla resultante es la suma de los productos de una fila de la primera tabla y una columna de la segunda tabla, multiplicados uno a uno y luego sumados todos. Tomemos el ejemplo más pequeño: la primera fila de A es 1 y 2, la primera columna de B es 5 y 7, entonces la esquina superior izquierda de la tabla resultante es 1 por 5 más 2 por 7, que es igual a 19. Las celdas restantes se completan una por una según esta regla.
En un modelo de IA, el cálculo de una capa se puede escribir como "entrada por pesos". La frase de un usuario se corta en vectores, se multiplica por la tabla de pesos de esa capa para obtener un resultado, luego pasa por una función no lineal y se entrega a la siguiente capa. Cuanto más grande es el modelo, más grandes son las tablas, y el número de multiplicaciones-sumas en una pasada puede ser de billones. Las GPU están construidas para este tipo de multiplicación-suma ordenada, que es también la razón por la que las tarjetas de minería y las tarjetas de IA son el mismo tipo de chip.
En teoría, las cosas funcionan así. Alguien le hace una pregunta a un chatbot en línea, y la tarjeta gráfica en el servidor comienza a ejecutar el modelo, haciendo multiplicación de matrices capa por capa. Si esta máquina tiene instalado el plugin de Pearl y está ejecutando su modelo de código abierto certificado, entonces estas multiplicaciones, mientras producen una respuesta, también se utilizan para probar suerte. Después de que cada pequeño bloque se calcula, se frota una huella digital una vez. Si la huella digital es lo suficientemente pequeña, se gana un boleto de lotería, y ganar obtiene la recompensa del bloque. El usuario no ve ninguna diferencia, sigue obteniendo la respuesta, y el precio podría incluso ser un poco más barato. El mismo lote de multiplicaciones-sumas se convierte en tokens por un lado y en monedas por el otro.

Para que este sistema funcione, primero debe resolver el engaño. El minero tiene solo dos tablas en mano, y primero debe frotar las tablas en una huella digital y enviarla. Lo que se llama frotar una huella digital significa tomar todos los números de esta tabla y calcular un hash juntos, comprimiéndolo en un segmento muy corto. Solo después de que la cadena haya visto esta huella digital, le dirá qué números aleatorios mezclar en las tablas. El orden está bloqueado, y es demasiado tarde para que él cambie las tablas. El término oficial para esta acción es agregar ruido. En términos simples, significa mezclar un montón de números aleatorios en las dos tablas. Cuánto se mezcla y dónde lo determina esa huella digital, y el minero no puede elegirlo él mismo.
Sin mezclar, hay un atajo. Entre A por B limpio y el producto después de mezclar números aleatorios, solo hay una diferencia de tres términos de corrección. Estos tres términos no son pequeños en magnitud, pero son baratos de calcular. El minero ya tiene A y B limpios en mano, así que podría perfectamente primero calcular la respuesta limpia, luego agregar estos términos de corrección baratos para producir la respuesta con números aleatorios mezclados, sin hacer esa gran multiplicación en absoluto. Es como una pregunta de examen que pide 3987 por 2913, pero el estudiante ya ha memorizado la respuesta y junta algunos números pequeños para que parezca que calculó seriamente.
Así que el protocolo no requiere que el minero entregue el resultado calculado, solo las filas de entrada que usó, más una prueba. El verificador toma esta parte, mezcla los mismos números aleatorios, recalcula solo este pequeño bloque, y verifica si la huella digital es correcta. Recalcular un bloque pequeño es barato y suficiente para confirmar que no hizo trampa. Si estas tablas involucran pesos de la empresa o datos de usuarios, se puede agregar una capa adicional de prueba de conocimiento cero para probar que el cálculo se hizo realmente, sin revelar cuáles dos tablas se usaron.

¿Hasta qué paso ha llegado ahora?
Ve a Hugging Face y mira; bajo la organización pearl-ai hay cuatro modelos certificados: Llama 3.3 70B, Llama 3.1 8B, Qwen3 30B y Gemma 4 31B. Oficialmente se denominan "variantes certificadas"; el enfoque no es reentrenar, sino recomprimir el mismo conjunto de pesos en el formato de cuantización de Pearl para que puedan realizar inferencia mientras minan dentro del plugin. La pérdida de precisión es muy pequeña; el MMLU de Gemma 4 31B bajó de 90.93 a 90.56. Hasta el 9 de octubre de 2026, las descargas de estos cuatro modelos en los últimos treinta días oscilaron entre 195 y 6,424, y sus me gusta fueron 0, 3, 5 y 6 respectivamente.
También hay una salida comercial. En mayo de 2026, Pearl se asoció con Together AI para lanzar una interfaz que ejecuta el modelo Gemma. Según el anuncio de Together, el precio de la llamada es un 25% más barato que las interfaces ordinarias, con la diferencia compensada por el valor futuro de los tokens.
Los modelos están publicados, el código es de código abierto, y luego no hay nada más. En junio de 2026, el investigador Abhinaba Basu probó esto en "The Usefulness Gap in Proof-of-Useful-Work". Según la potencia de cómputo de la red en ese momento de aproximadamente 24 EH/s, equivalente a unas 320,000 tarjetas de nivel RTX 3090, consumo de energía estimado de 112 megavatios, y la producción de cómputo de IA útil fue cero.
El autor muestreó 8,012 unidades de trabajo de mineros; todo el hardware tenía capacidad de inferencia, pero en el software principal de la máquina minera, había 4,803 cadenas relacionadas con la multiplicación de matrices y 0 relacionadas con marcos de aprendizaje automático. También escribió él mismo un programa de minería, llenando tablas con números aleatorios, y lo ejecutó con éxito en chips Nvidia, AMD, CPU y Apple, obteniendo shares reconocidos por el pool de minería, 44 en total. Una persona proporciona datos y deja que el modelo calcule el resultado, y usa la misma tarjeta para minar monedas, puede combinarse en el diseño, pero en la operación real están separados.
Entonces, ¿qué se está ejecutando realmente en la red? Según la página del pool de minería Kryptex, la potencia de cómputo de la red ha subido a 46.37 EH/s, dificultad 2.26 TH, tiempo de bloque de aproximadamente 203 segundos, recompensa de bloque de 2,271.03 PRL, producción diaria de aproximadamente 966,000 monedas, y precio de la moneda de aproximadamente $1.30. En seis meses, la potencia de cómputo casi se ha duplicado, y la gran mayoría de este aumento sigue siendo llenar números aleatorios. Lo que se está haciendo en el mercado ahora es principalmente solo esto: comprar tarjetas, conectarlas, llenar números aleatorios, esperar la liquidación.
¿Qué problemas hay?
Imaginemos que la cafetería publica un aviso: quien corte suficientes cien jin de verduras puede recibir un salario. El acto de cortar verduras en sí es real; la habilidad con el cuchillo, la fuerza y el tiempo tienen que gastarse. Pero el aviso solo verifica si has cortado suficientes cien jin, no qué verduras cortaste. Así que alguien trae un carrito de hojas de verduras podridas, corta suficientes cien jin y toma el salario. Él cortó verduras, y realmente gastó fuerza, solo que la cocina no puede usar este montón de hojas.
Pearl ahora está atascado aquí. El protocolo verifica si la huella de la tabla coincide, si el resultado realmente es igual a la multiplicación de dos tablas, si la carga de trabajo es suficiente para la dificultad; en el diseño formal también hay una puerta estadística específicamente para bloquear entradas que a simple vista se puede ver que han sido manipuladas. Verifica todo esto. Lo que no verifica es de dónde vinieron estas dos tablas. Así que los mineros pueden crear completamente dos tablas de números aleatorios ellos mismos; la multiplicación es igual de difícil, la huella cumple el estándar igual, y pueden ganar igual, excepto que nadie quiere usar el resultado calculado. El protocolo solo reconoce la relación de multiplicación, no la semántica; "útil" aquí es un tema comercial, no una garantía criptográfica.
Esto no es una suposición. Según el informe mencionado anteriormente, todas las máquinas muestreadas podían ejecutar modelos, sin embargo no había una sola línea de código de inferencia en el software de la máquina minera, y las tablas que el autor llenó con números aleatorios él mismo también obtuvieron shares reconocidos por el pool de minería. Actualmente, la potencia de cómputo de la red es de alrededor de 45 EH/s, y la gran mayoría sigue llenando números aleatorios.
La brecha de escala también se puede ver así. El artículo dio un contrafactual: si este diseño realmente operara como se anuncia, entonces en ese momento la red de 24 EH/s debería haber producido aproximadamente 7.7 millones de horas de GPU de potencia de cómputo de IA útil por día. El artículo también mencionó un indicador llamado relación de destrucción de valor; el valor medido de Pearl es 1.0, a la par de Bitcoin, mientras que el de Filecoin es de aproximadamente 0.64.
Los mineros no aceptan órdenes de inferencia, no porque no entiendan, sino porque han hecho los cálculos. El artículo estima que acoplar el motor de inferencia con la minería perdería alrededor del 10% al 30% de la potencia de cómputo efectiva. Es decir, aceptar inferencia real no solo requiere cambiar el software y acomodar el ritmo de las solicitudes, sino también perder primero esta porción de potencia de cómputo. En años en que el precio de la moneda no es alto, esta cuenta se calcula fácilmente como negativa.
Entonces, ¿cómo podría resolverse esto? El artículo enumeró varios caminos. Uno es gestionar la fuente de las tablas, requiriendo que los mineros usen tablas enviadas por clientes externos. El complemento y los modelos certificados que Pearl hace oficialmente ahora van en esta dirección: entregar el modelo y el complemento a los mineros; usas el modelo real para ejecutar la inferencia, y esa multiplicación convenientemente también mina la moneda. La dificultad es que es voluntario; si aceptarlo o no todavía depende de que los mineros calculen su propia cuenta económica.
Otro es verificar si las tablas parecen reales. Los pesos de los modelos reales y los números aleatorios llenados al azar difieren en características estadísticas. Pero el artículo mismo rechazó este camino: los mineros solo necesitan ajustar la distribución para engañar la verificación, a un costo casi nulo. También hay varios caminos más lejanos que aún no se han concretado. Hacer que la fuente del modelo sea una firma verificable requiere primero tener un sistema de clave pública para el lado del modelo. Usar hardware de confianza para probar la procedencia de los datos requiere además confiar en los fabricantes de chips y también ralentizará las cosas. Diferenciar recompensas, dando un poco más por usar datos reales, requiere primero tener un grupo de clientes verdaderamente dispuestos a pagar.
El desarrollador de Pearl es Pearl Research Labs. Omri Weinstein es cofundador y CEO; este título proviene del anuncio de asociación con Together AI. Es un investigador en teoría de la complejidad, tiene un puesto de profesor en la Universidad Hebrea y es uno de los autores de ese artículo fundacional.
Otro autor, Ilan Komargodski, también está en la lista de miembros de la organización de Hugging Face; si su identidad específica es empleado o consultor no puede probarse a partir de fuentes públicas. Otro nombre que puede coincidir es Erez Badash, primer autor del artículo Hawkeye sobre reproducción bit a bit en GPU.
Bittensor tiene validadores que puntúan las salidas de modelos enviadas por los mineros, con la puntuación determinada por un consenso llamado Yuma. io alquila GPUs bajo demanda para tareas de aprendizaje automático. Pearl apuesta por una suposición más estrecha: la multiplicación utilizada para la generación de bloques en sí misma puede ser deseada por alguien.
Está apostando a que la demanda de inferencia crecerá lo suficiente como para consumir la potencia de cómputo de generación de bloques. En ese punto, los propios mineros calcularán claramente que aceptar órdenes reales es más rentable que llenar números aleatorios. Si no puede alcanzar ese punto, entonces es solo una cadena de minería de tarjetas gráficas con matemáticas cambiadas; lo que se computa es homólogo con la IA, y no está relacionado con las expectativas de ningún usuario específico.