Ambos enfoques permiten a un exchange comprometerse con los saldos de los usuarios sin publicarlos, y cada uno traza la línea de la privacidad en un lugar distinto. Una prueba de Merkle te muestra tu propia fila y un puñado de hashes vecinos; una prueba de conocimiento cero puede establecer una afirmación sobre todo el conjunto sin revelar nada de ninguna fila. El precio de esa privacidad más fuerte es cómputo, complejidad y una cosa nueva en la que hay que confiar.
Qué intenta ocultar cada enfoque
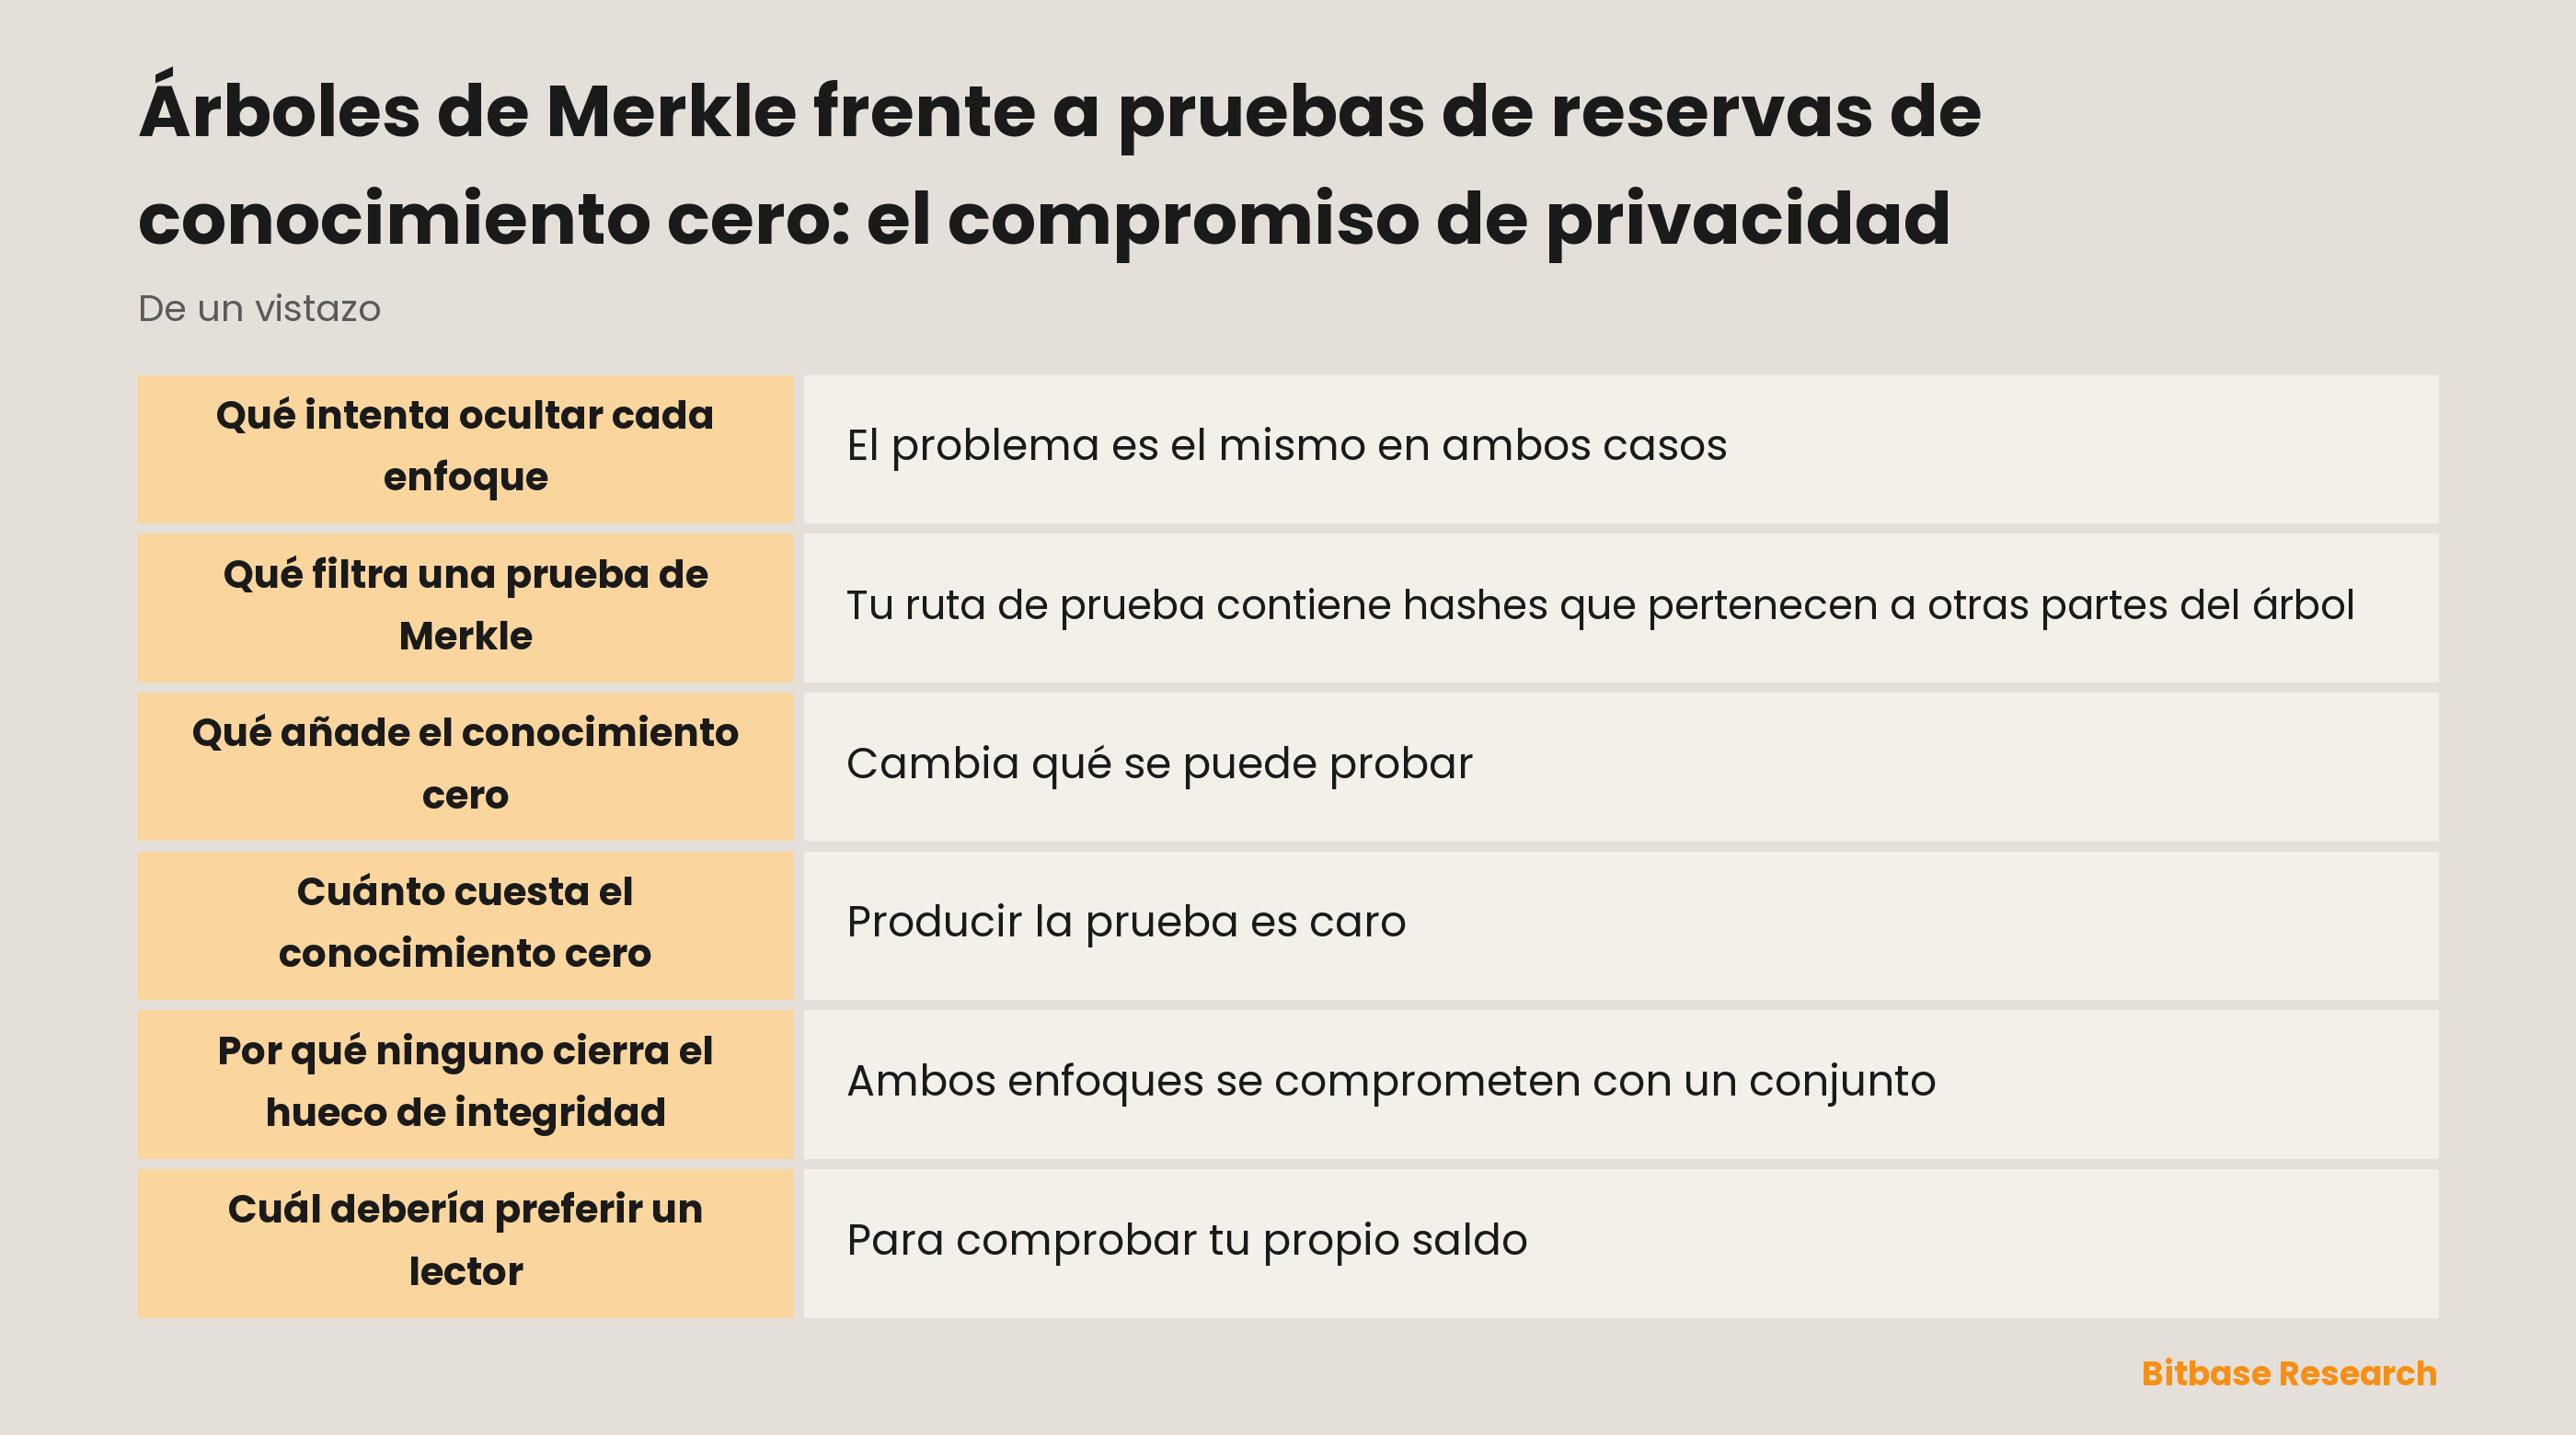
El problema es el mismo en ambos casos. Un exchange necesita convencer a los usuarios sobre un conjunto de saldos sin convertirlo en documento público, porque publicarlo expondría a todos los clientes de golpe.
Un árbol de Merkle lo resuelve comprometiéndose con el conjunto y dejando que cada usuario compruebe solo su propia pertenencia. Nadie ve la lista y cada persona ve lo suficiente para verificar su fila. La estructura se describe en árboles de Merkle en la prueba de reservas.
Una prueba de conocimiento cero ataca la versión más difícil del mismo problema. En vez de dejar que cada usuario compruebe una fila, produce una única prueba de que una afirmación sobre todo el conjunto es cierta, sin revelar los datos a los que se refiere. Qué es esa clase de prueba y cómo funciona en general está en pruebas de conocimiento cero, SNARK y STARK.
Los dos enfoques comparados
| Dimensión | Árbol de Merkle | Prueba de conocimiento cero |
|---|---|---|
| Qué comprueba el usuario | Su propia fila contra la raíz | Una afirmación sobre todo el conjunto |
| Qué revela una prueba | Hashes hermanos de tu ruta | Nada más allá de la propia afirmación |
| Saldos negativos o que se compensan | No detectables | Se pueden excluir por la afirmación |
| Coste de producir | Insignificante | Cómputo sustancial |
| Coste de verificar | Unas decenas de operaciones de hash | Una prueba pequeña, comprobada rápido |
| En qué hay que confiar | En la raíz y el formato de hoja | En el circuito y cómo se configuró |
Lee las filas por pares y no por columnas, porque lo interesante es dónde divergen los enfoques y no cómo queda cada uno por separado. La última fila cambia la forma de la pregunta y no solo las cifras, y por eso el enfoque más nuevo no es simplemente mejor.
Qué filtra una prueba de Merkle
Tu ruta de prueba contiene hashes que pertenecen a otras partes del árbol. Un hash no es reversible, así que no aprendes nada de los saldos que hay debajo, y en ese sentido la filtración es casi nula.
Pero no exactamente nula. Aprendes que el árbol tiene cierta forma, aproximadamente cuántas cuentas contiene y que ciertos valores hermanos existen. Alguien que recopile muchas pruebas con el tiempo sabrá más sobre la estructura que cualquier usuario individual.
Nada de eso es peligroso por sí solo y conviene mantener la proporción: información estructural sobre un árbol está muy lejos de información sobre una persona. El hueco más práctico es otro. Como cada usuario solo comprueba su fila, un esquema de Merkle no descarta saldos que se compensen dentro del conjunto, y un total armado con filas que nadie coteja es una cifra más débil de lo que aparenta.
Qué añade el conocimiento cero
Cambia qué se puede probar. En vez de probar una pertenencia cada vez, el exchange puede probar una propiedad de todo el conjunto, como que la suma de todos los saldos iguala una cifra declarada y que ningún saldo era negativo.
Esa segunda cláusula pesa más de lo que suena. Con un esquema de Merkle simple, nada impide que una entrada negativa cancele una positiva, y el árbol verifica encantado en ambos casos, porque se compromete con lo que le dieron. Una afirmación de conocimiento cero puede hacerlo imposible por construcción.
Es un buen ejemplo de un patrón general en criptografía: pasar de probar instancias a probar propiedades cambia qué se puede garantizar, no solo con qué eficiencia se comprueba. La mejora de privacidad también es real: quien verifica sabe que la afirmación se sostiene y no sabe nada más, ni siquiera la forma del árbol, así que pruebas repetidas no se acumulan en un retrato de la base de clientes. Un razonamiento parecido impulsa su uso en otros terrenos, descrito en dónde se usa el conocimiento cero.
Cuánto cuesta el conocimiento cero
Producir la prueba es caro. Construir una afirmación sobre millones de cuentas exige cómputo sustancial, y ese coste recae cada periodo en el exchange, no en el lector.
El coste mayor es conceptual. Una comprobación de Merkle son unas decenas de hashes y puede reimplementarla cualquiera que entienda hashing; un sistema de conocimiento cero descansa en un circuito que codifica la afirmación y en los parámetros con que se configuró. Verificar que el circuito dice lo que declara está fuera del alcance de casi todos los usuarios.
Hay además un coste operativo que rara vez se menciona: un circuito tiene versiones, y cambiar la afirmación que se prueba es un cambio que cada revisor independiente debe volver a mirar. Así que la confianza se reubica, no desaparece. Ya no tienes que confiar en la aritmética del exchange, y ahora tienes que confiar en que el circuito se escribió y configuró bien, normalmente por la palabra de quienes lo revisaron.
Por qué ninguno cierra el hueco de integridad
Ambos enfoques se comprometen con un conjunto. Ninguno establece que el conjunto contuviera todas las cuentas, porque una cuenta omitida no deja rastro en ninguna de las construcciones, y ninguna propiedad probada sobre un conjunto dice nada sobre lo que quedó fuera.
Conviene decirlo sin rodeos porque la sofisticación de las pruebas de conocimiento cero invita a suponer que lo resuelven todo. Hacen afirmaciones más fuertes sobre los datos que entraron; sobre los datos que nunca entraron no dicen nada.
Lo mismo vale para el lado de los activos y para obligaciones ajenas a los saldos de clientes. La criptografía zanja lo que es zanjable sobre un conjunto comprometido, y el resto queda fuera, como expone las limitaciones de la prueba de reservas.
Cuál debería preferir un lector
Para comprobar tu propio saldo, una prueba de Merkle basta de sobra y tiene la ventaja de ser verificable con herramientas que puedes leer. La simplicidad es una propiedad de seguridad real cuando quien comprueba es el propio lector.
Para afirmaciones sobre todo el conjunto, el conocimiento cero es estrictamente más capaz, y poder excluir saldos negativos es la ganancia concreta más clara. Si una divulgación lo ofrece, es una señal de lo en serio que se toma quien publica la mitad difícil del problema.
Así que la elección no va tanto de qué tecnología es superior como de qué pregunta intenta responder una divulgación concreta. En la práctica ambos conviven en vez de competir: un esquema puede comprometerse con un árbol, dar pruebas individuales a los usuarios y añadir una afirmación de conocimiento cero sobre propiedades agregadas, diseño razonable y no contradicción.
En resumen
Un árbol de Merkle da a cada usuario una prueba barata y legible de su propia inclusión y filtra una pequeña cantidad de información estructural. Una prueba de conocimiento cero puede establecer propiedades del conjunto entero, incluida la ausencia de saldos negativos, sin revelar nada.
La herramienta más fuerte cuesta cómputo y traslada la confianza a un circuito que la mayoría no puede inspeccionar. Y ninguna prueba que el conjunto fuera completo, que sigue siendo la pregunta que la criptografía no responde. Para más contenidos de Bitbase Academy, sigue leyendo.
Aviso legal: Este artículo es contenido educativo de Bitbase Academy y se ofrece solo con fines informativos. No constituye asesoramiento de inversión, negociación, fiscal ni financiero. Los criptoactivos son volátiles; evalúa tu propio riesgo. Redactado en septiembre de 2026; consulta la información oficial más reciente.
Fuentes
[1] Bitbase, Prueba de reservas: divulgación mensual, raíz de Merkle y verificador de código abierto www.bitbase.com