AI數學,正在越過一個很微妙的分界線。
過去我們問的是:大模型能不能做出一道難題?能不能寫出嚴謹證明?能不能找到人類幾十年沒發現的反例?
而現在,一個更像「科研本身」的問題冒了出來:當一條證明路線失敗之後,AI知不知道下一步該幹什麼?是繼續算,換路線,縮小命題,還是乾脆提出一個新的、可證偽的數學猜想?
思特雅大學的研究人員曾仔健搭建的AI Has Taste,正在試圖把這個問題做成一套可持續運行的研究系統。
項目公開倉庫目前記錄了453份數學研究手稿、2312頁內容,其中6篇被明確歸類為「AI-Proposed Conjectures」。
倉庫首頁給出的定位更直接:From Answer Generation to Research-Agenda Generation——從生成答案,走向生成研究議程。
AI把論文裡的猜想推翻了,原作者回信確認
AI Has Taste並不是從「AI一定擅長數學」的信念出發。曾仔健回憶,項目最開始時,他對大模型能否真正推進數學研究並不確信。一次偶然的測試成為轉折點:他把一篇論文中的猜想直接交給AI,本來只是想看看模型究竟能走多遠。結果AI沒有順著論文繼續「證明」,而是構造出了一個反例,直接把這個猜想推翻。
他的第一反應不是興奮,而是不信。於是,他把反例和推導整理後寫信給原論文作者核實。隨後收到的回覆確認:這個反例成立。對應研究後來也被收錄進目前450餘份數學手稿中。
「最開始我还不相信AI在數學上的力量。直到輸入一篇論文的猜想,AI直接給出反例推翻;我立刻寫信問原作者,對方回覆確認是對的。那之後,我才真正放開手腳幹。」——曾仔健
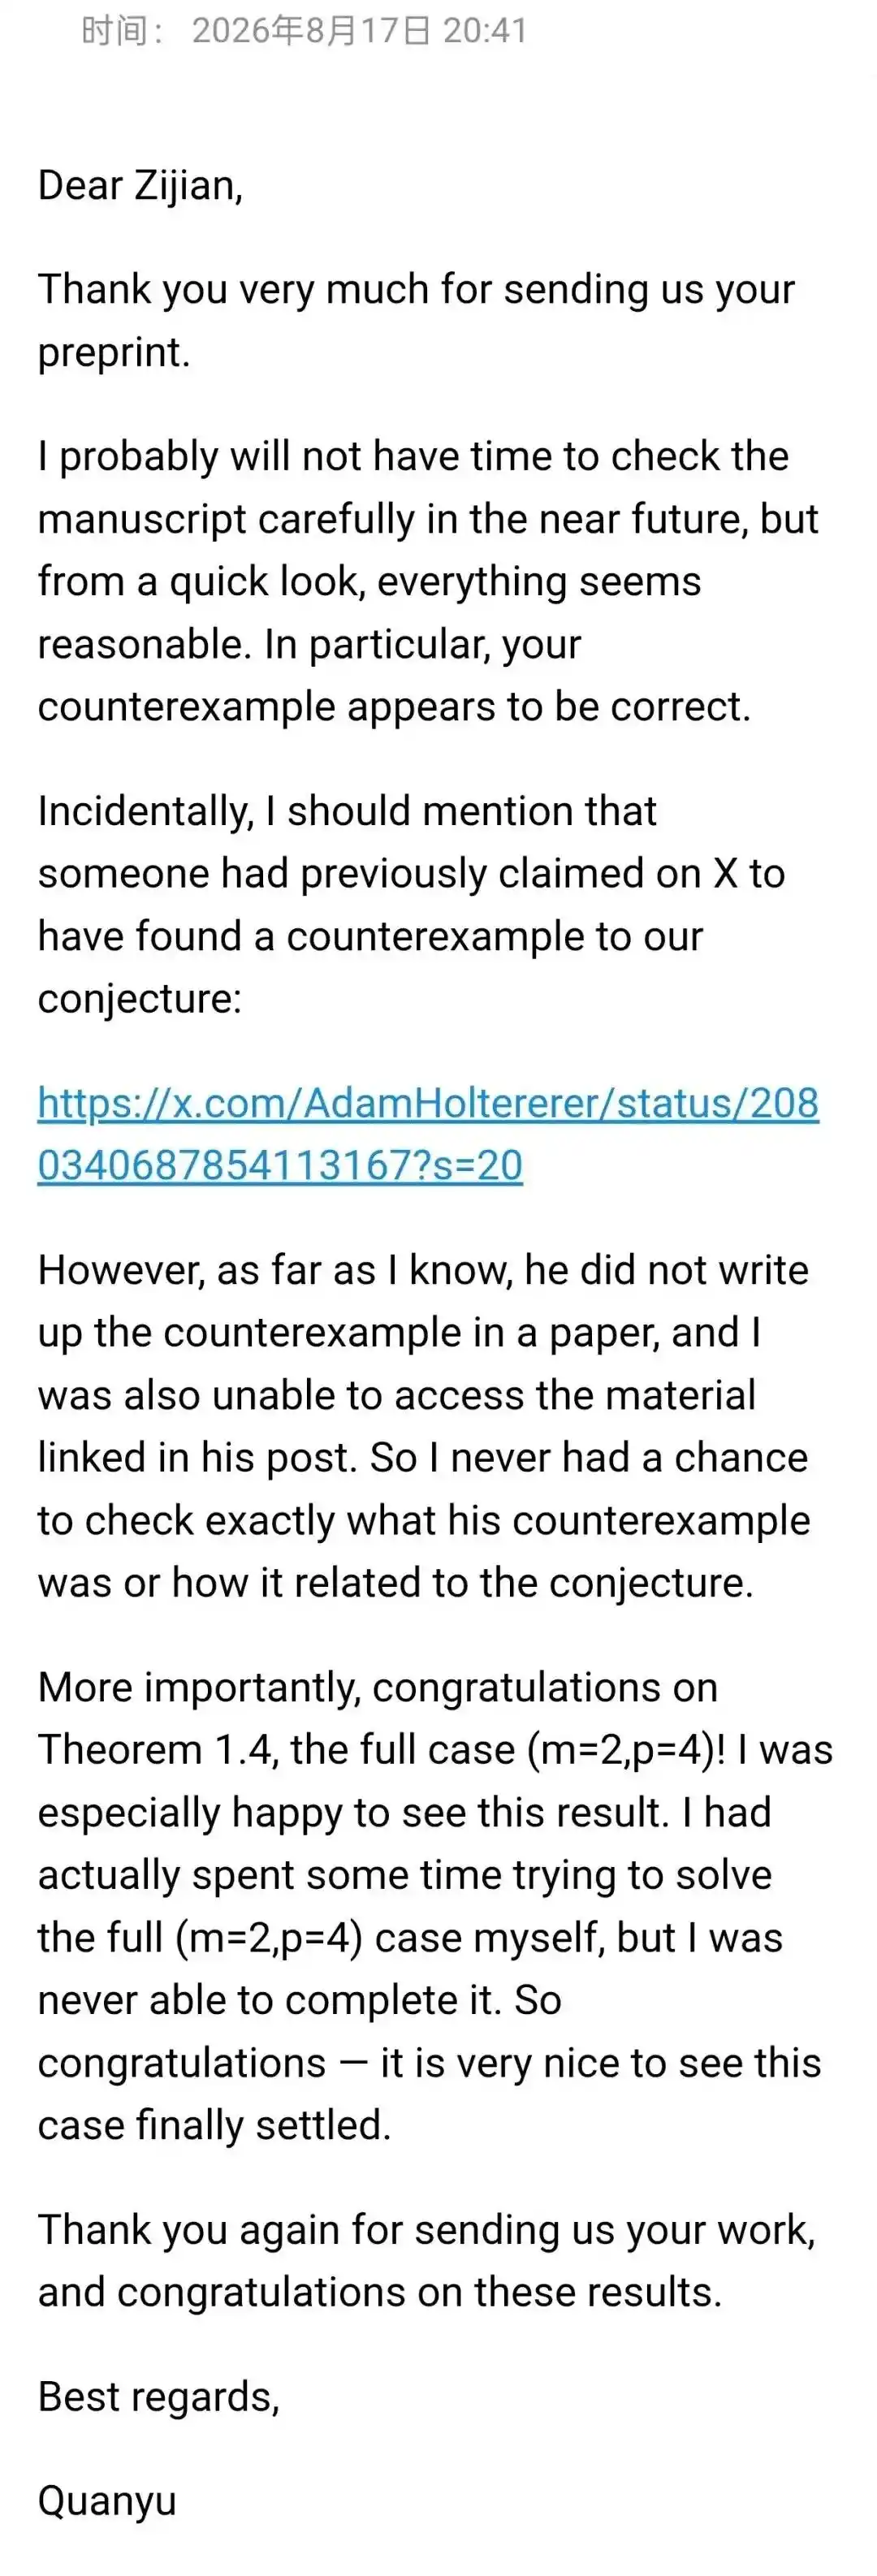
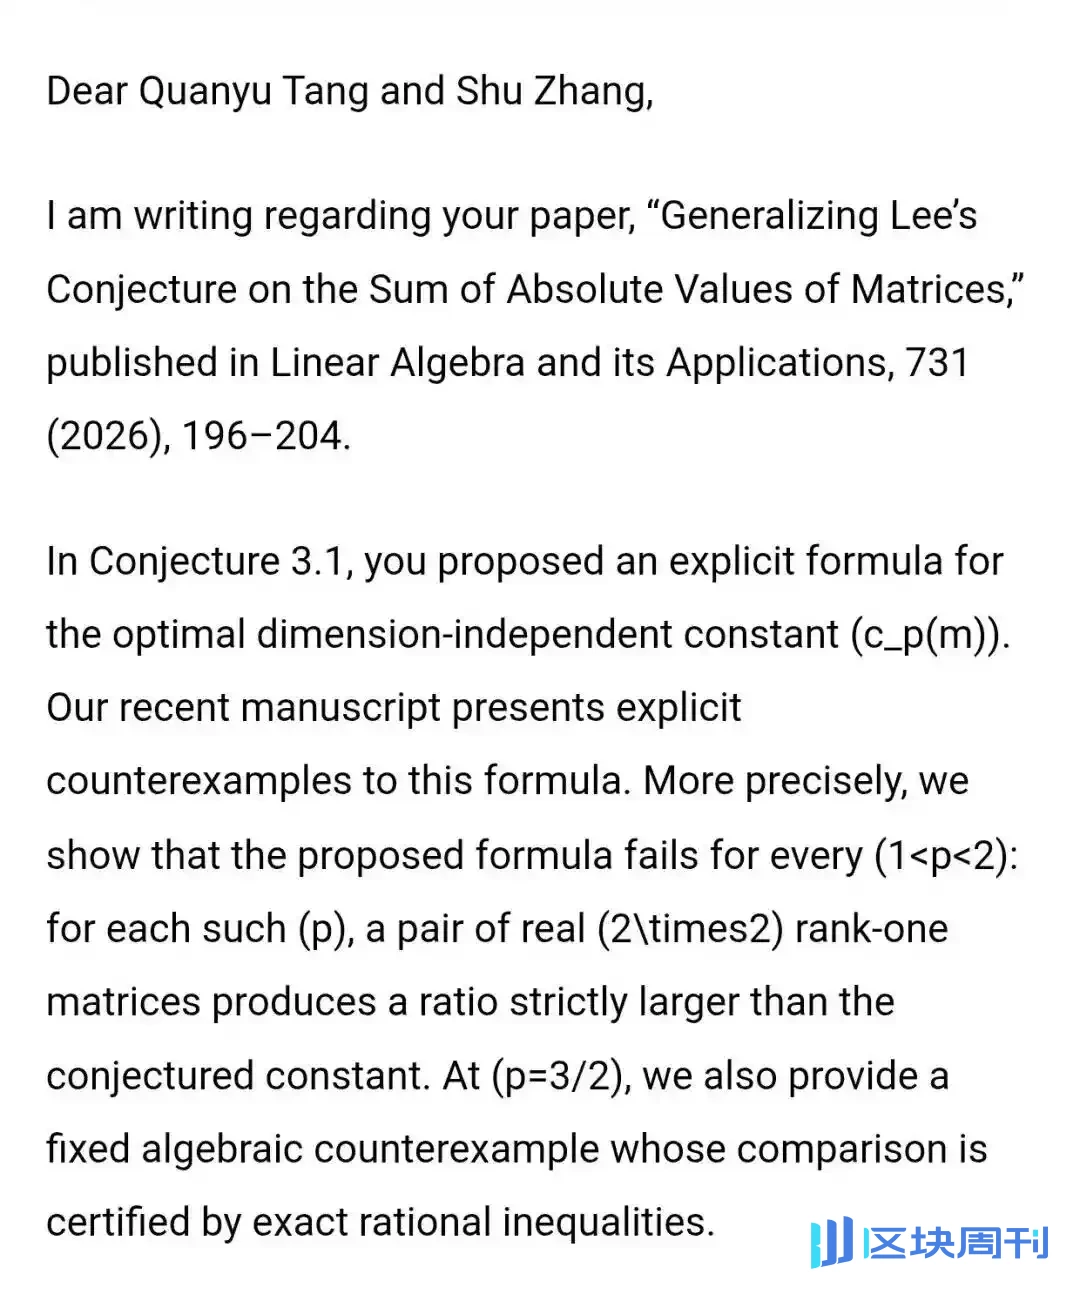
這封郵件改變的不是一個猜想,而是項目的尺度。如果AI不僅能複述已知知識、生成看起來像證明的文本,還能主動攻擊論文中的新猜想,並找到一個經過原作者確認的反例,那麼它就有機會真正進入「研究循環」。此後,曾仔健才開始把選題、證明、反例搜索、失敗管理、獨立審查和寫作逐步Agent化,並讓不同機器長期並行推進。
真正的變化,不是「寫了多少篇」
單看數量,453份手稿已經足夠吸睛。但如果只把這個項目理解成「AI批量寫數學論文」,反而錯過了最值得注意的部分。
項目自己反覆強調:453是「research manuscripts」的數量,不等於453個原始開放問題全部被解決。產物包括完整證明、反例、局部結果、有限計算證書、結構化約化,以及提出新猜想的論文。AI內部審查也不等於外部同行評審。
真正的變化發生在研究鏈條上。傳統AI benchmark往往從「題目已經給定」開始:人類負責選題,AI負責求解,最後得到成功或失敗。AI Has Taste則把流程向前和向後都拉長——AI可以篩選候選問題、比較路線、主動找反例;一條路線失敗後,還可以分析失敗結構、修改命題,並把新的數學對象交給另一個獨立Agent繼續攻擊。

AI Has Taste的關鍵不是「更多Prompt」,而是把失敗也變成下一輪研究輸入。
選題、證明、挑錯、寫作Agent
這套系統並不是「一個模型在一個對話框裡自問自答」。公開README把Agent角色拆成了四層:
Supervisor / Screener負責選擇候選、比較附近結果並找最便宜的決定性實驗;
Researcher負責證明、反例和精確計算;
Fresh-context Reviewer在新的上下文裡專門攻擊凍結後的命題、關鍵引理和證書;
Writer / Release Checker負責把最終接受的範圍寫清楚,並檢查引用、構建和發布材料。
曾仔健進一步把工作流部署成多機協作:不同機器可以分別推進證明、搜索反例、跑精確計算、做獨立審稿。共享的是凍結命題、實驗記錄、失敗原因、代碼和證據,而不是讓一個Agent一邊生成結果、一邊給自己蓋章。

多Agent的核心設計:角色分離 + 共享證據 + fresh-context審查。
倉庫裡有一句話很能概括這種設計:Criticism is part of the engine, not an afterword。批評不是論文寫完之後才補的一道手續,而是研究發動機的一部分。
數學家、機器人學者和自動化學者進入驗證鏈
當研究手稿從幾十份增長到數百份,另一個問題隨之變得尖銳:誰來判斷這些Agent產物不是系統性幻覺?
AI Has Taste內部用fresh-context Reviewer把「研究」和「挑錯」拆開,但項目並沒有把AI自審當作終點。
隨著工作推進,曾仔健也開始邀請不同領域的真實學者參與部分結果的驗證、複核和學術討論。
據項目方介紹,參與部分工作的合作者與審核者包括:馬來西亞科學院院士、馬來亞大學數學科學研究所榮譽教授Ong Seng Huat;馬來西亞科學院院士、馬來亞大學數學科學研究所榮譽教授Kurunathan Ratnavelu;以及中國地質大學(武漢)人工智能與自動化學院熊永華教授。
這裡需要區分「參與驗證」與「為全部結果背書」:上述學者並非對453份手稿逐篇簽字認證,而是對其中部分問題、證明、計算結果或研究方向進行過驗證、審核或討論。
對一個高度自動化的科研系統而言,這種「機器內部紅隊 + 人類專家抽檢/複核」的組合,反而比把所有審查都交給同一套Agent更關鍵。
AI負責把研究速度推到極限;人類專家負責在關鍵節點把「看起來成立」重新拉回到「值得相信」。
失敗以後,換了一個更好的問題
項目最能體現「研究品味」的案例,恰恰不是一次漂亮的成功,而是一次失敗。
在 fractional Gaussian trace 問題上,系統最初嘗試單調性和單側配對路線,但精確反例不斷出現。普通benchmark到這裡通常只會留下一個標籤:FAILED。
但這套工作流沒有停。Agent繼續追問:反例到底破壞了什麼?失敗有沒有穩定結構?最後研究把注意力轉向一個固定的負向缺陷,構造出十項修正結構,並提出一個新的統一有界性猜想。更關鍵的是,新猜想隨後又被另一輪精確計算和獨立審查反過來攻擊。公開歸檔掃描到index 1004;這個統一界至今仍未證明。
這件事的意義並不是「AI又證明了一個大定理」——事實上它沒有。意義在於:原問題沒有解決,但失敗路線被壓縮成了一個更清楚、更可證偽、而且一旦成立就能重新連接原問題的新命題。研究沒有在失敗處終止,而是在失敗裡長出了下一道題。
過去:人類出題,AI答題。現在:AI答題,也開始參與決定「下一道題是什麼」。
6篇AI新猜想
截至當前公開快照,倉庫把6篇論文單獨歸入「AI-Proposed Conjectures」。這些工作橫跨組合、圖論、數論與分析型問題,包括A182510三個子序列的無限binary-kernel矩陣非奇異性、Young圖形的CDS-colorability、最大度不超過6的無三角圖分解、18-colored generalized Frobenius partitions的unary-theta同餘公式、reciprocal-subsum denominators在dyadic stages上的Newton係數非負性,以及前述fractional Gaussian trace固定缺陷猜想。
真正值得關注的不是AI能不能「腦洞一個猜想」。隨口猜一句並不難。難的是把猜想寫成精確定義,說明它從哪裡來、什麼證據支持、什麼反例能推翻、如果成立會導向什麼結果,並把計算和源碼一起留給後續複核。
這也是為什麼項目把「提出猜想」看作比「生成答案」更高一級的研究動作:證明回答的是已有問題,猜想則會改變之後的研究資源投向。
453份手稿背後,是一種「Agent規模化科研」的雛形
AI Has Taste目前公開了453份research manuscripts,總計2312頁;其中BigWIN2一套工作流就對應223份手稿,並為這223份工作提供配對的LaTeX/復現材料包。
這類規模最反直覺的地方,不是「AI打字快」。數學研究真正昂貴的是上下文切換:這一題需要圖論,下一題要數論,再下一題可能要SAT、窮舉、精確有理數運算或者矩陣計算。一個人類研究者不可能同時維持幾百條完全不同的思路,但Agent系統可以把它們拆成獨立任務,把失敗路線、局部定理和可復現實驗都保存下來。
於是,個人研究者的角色正在發生變化:不是每一步都親自推,而更像一個PI——設定研究邊界、選擇問題池、決定哪些結果值得繼續投入、什麼時候應該停止,以及哪些結論有資格被公開。
為什麼叫「AI Has Taste」?
「AI有品味」聽起來很擬人化,但項目README特意給出了邊界:這裡的taste不是意識或主觀體驗,而是「通過研究決策表現出來的數學判斷」。
比如:兩個問題都能做,先做哪個?一條路線已經有局部進展,但邊際收益越來越低,要不要停?一個反例是把命題判死刑,還是說明真正的定理應該換一種表述?一個小結果夠不夠獨立成篇?這些決定過去通常隱含在研究者經驗裡,很難被標準benchmark測量。
AI Has Taste試圖把這些決定留下可檢查的軌跡:選了哪個問題、為什麼換路線、失敗留下了什麼結構、下一步命題從哪裡來,以及新結論如何被獨立上下文再次攻擊。
離「自主數學家」還有多遠?
這個項目最容易被誇大的地方,同樣需要說清楚。453份手稿不是453篇經過正式同行評審的期刊論文;Agent內部review不等於數學共同體的獨立審稿;有限計算覆蓋的範圍也不能自動推廣到無限情形。倉庫本身明確寫出了這些限制。
但如果只因為這些結果尚未全部完成外部驗證,就忽略它的研究組織方式,也會錯過另一個變化:AI的能力邊界正從「執行一個給定任務」,移動到「參與設計下一個任務」。
數學研究真正稀缺的資源,從來不只有算力和推理長度,還包括:什麼問題值得花時間,什麼失敗值得保留,什麼時候應該換題。
當AI開始進入這些環節,「AI for Math」的競爭就不再只是「誰更會證明」,而會逐漸變成:誰擁有更好的研究閉環,誰能在大量失敗中提煉出更值得繼續追的方向。
One More Thing
過去的AI科研敘事,很像一個超級學生:老師出題,它負責解。
而AI Has Taste想做的,更像一個研究組:人類給出邊界和價值判斷,Agent去找題、試題、做錯、推翻自己、留下局部結果,再提出下一題。
如果這條路線繼續成立,未來基礎研究裡最重要的人機分工,也許會從「人類負責想,AI負責算」變成更複雜的結構:人類負責目標、價值與最終責任;AI承擔大規模搜索、驗證、失敗管理和候選研究方向生成;形式化工具與公開證據負責讓結果可複核。
AI會做題之後,下一關,可能真的是:AI會不會選題。
本文來自微信公眾號「新智元」,作者:新智元