两条路线都让交易所能在不公布用户余额的前提下把自己绑定到这些余额上,而它们把隐私的界划在了不同的地方。Merkle 证明让你看到自己那一行和路径上的少数几个相邻哈希;零知识证明则能就整个集合确立一句陈述,同时不透露任何一行的任何信息。更强的隐私换来的代价是算力、复杂度,以及一样你必须新去信任的东西。
两条路线各自想藏住什么
两边要解的问题是同一个。交易所需要就一组余额说服用户,又不能把这组余额变成一份公开文件——因为公布它会一次性暴露每一位客户。
Merkle 树的解法是:把自己绑定到这个集合上,然后让每个用户只核自己的成员资格。没有人看到名单,而每个人看到的又足够验证自己那一行。这个结构写在储备证明里的 Merkle 树里。
零知识证明攻的是同一个问题更难的版本。它不是让每个用户核一行,而是产出一份证明:关于整个集合的某句陈述为真,同时不透露这句陈述所关于的那些数据。这一类证明是什么、大体怎么工作,写在零知识证明、SNARK 与 STARK里。
两条路线逐维度对照
| 维度 | Merkle 树 | 零知识证明 |
|---|---|---|
| 用户核的是什么 | 自己那一行对着根 | 关于整个集合的一句陈述 |
| 一份证明透露什么 | 你路径上的兄弟哈希 | 除了那句陈述本身之外什么都不透露 |
| 负余额或对冲余额 | 察觉不到 | 可以由那句陈述排除掉 |
| 生成的代价 | 微不足道 | 相当可观的算力 |
| 核验的代价 | 几十次哈希运算 | 一份小证明,很快验完 |
| 你必须信任什么 | 那个根与叶子格式 | 那个电路,以及它是怎么被设置的 |
按行成对地读,不要顺着一列往下读——因为有意思的是两条路线在哪里分岔,而不是各自单独表现如何。最后一行改变的是问题的形状而不只是数值,这也正是「更新的那条路线并不就是更好」的原因。
一份 Merkle 证明泄露了什么
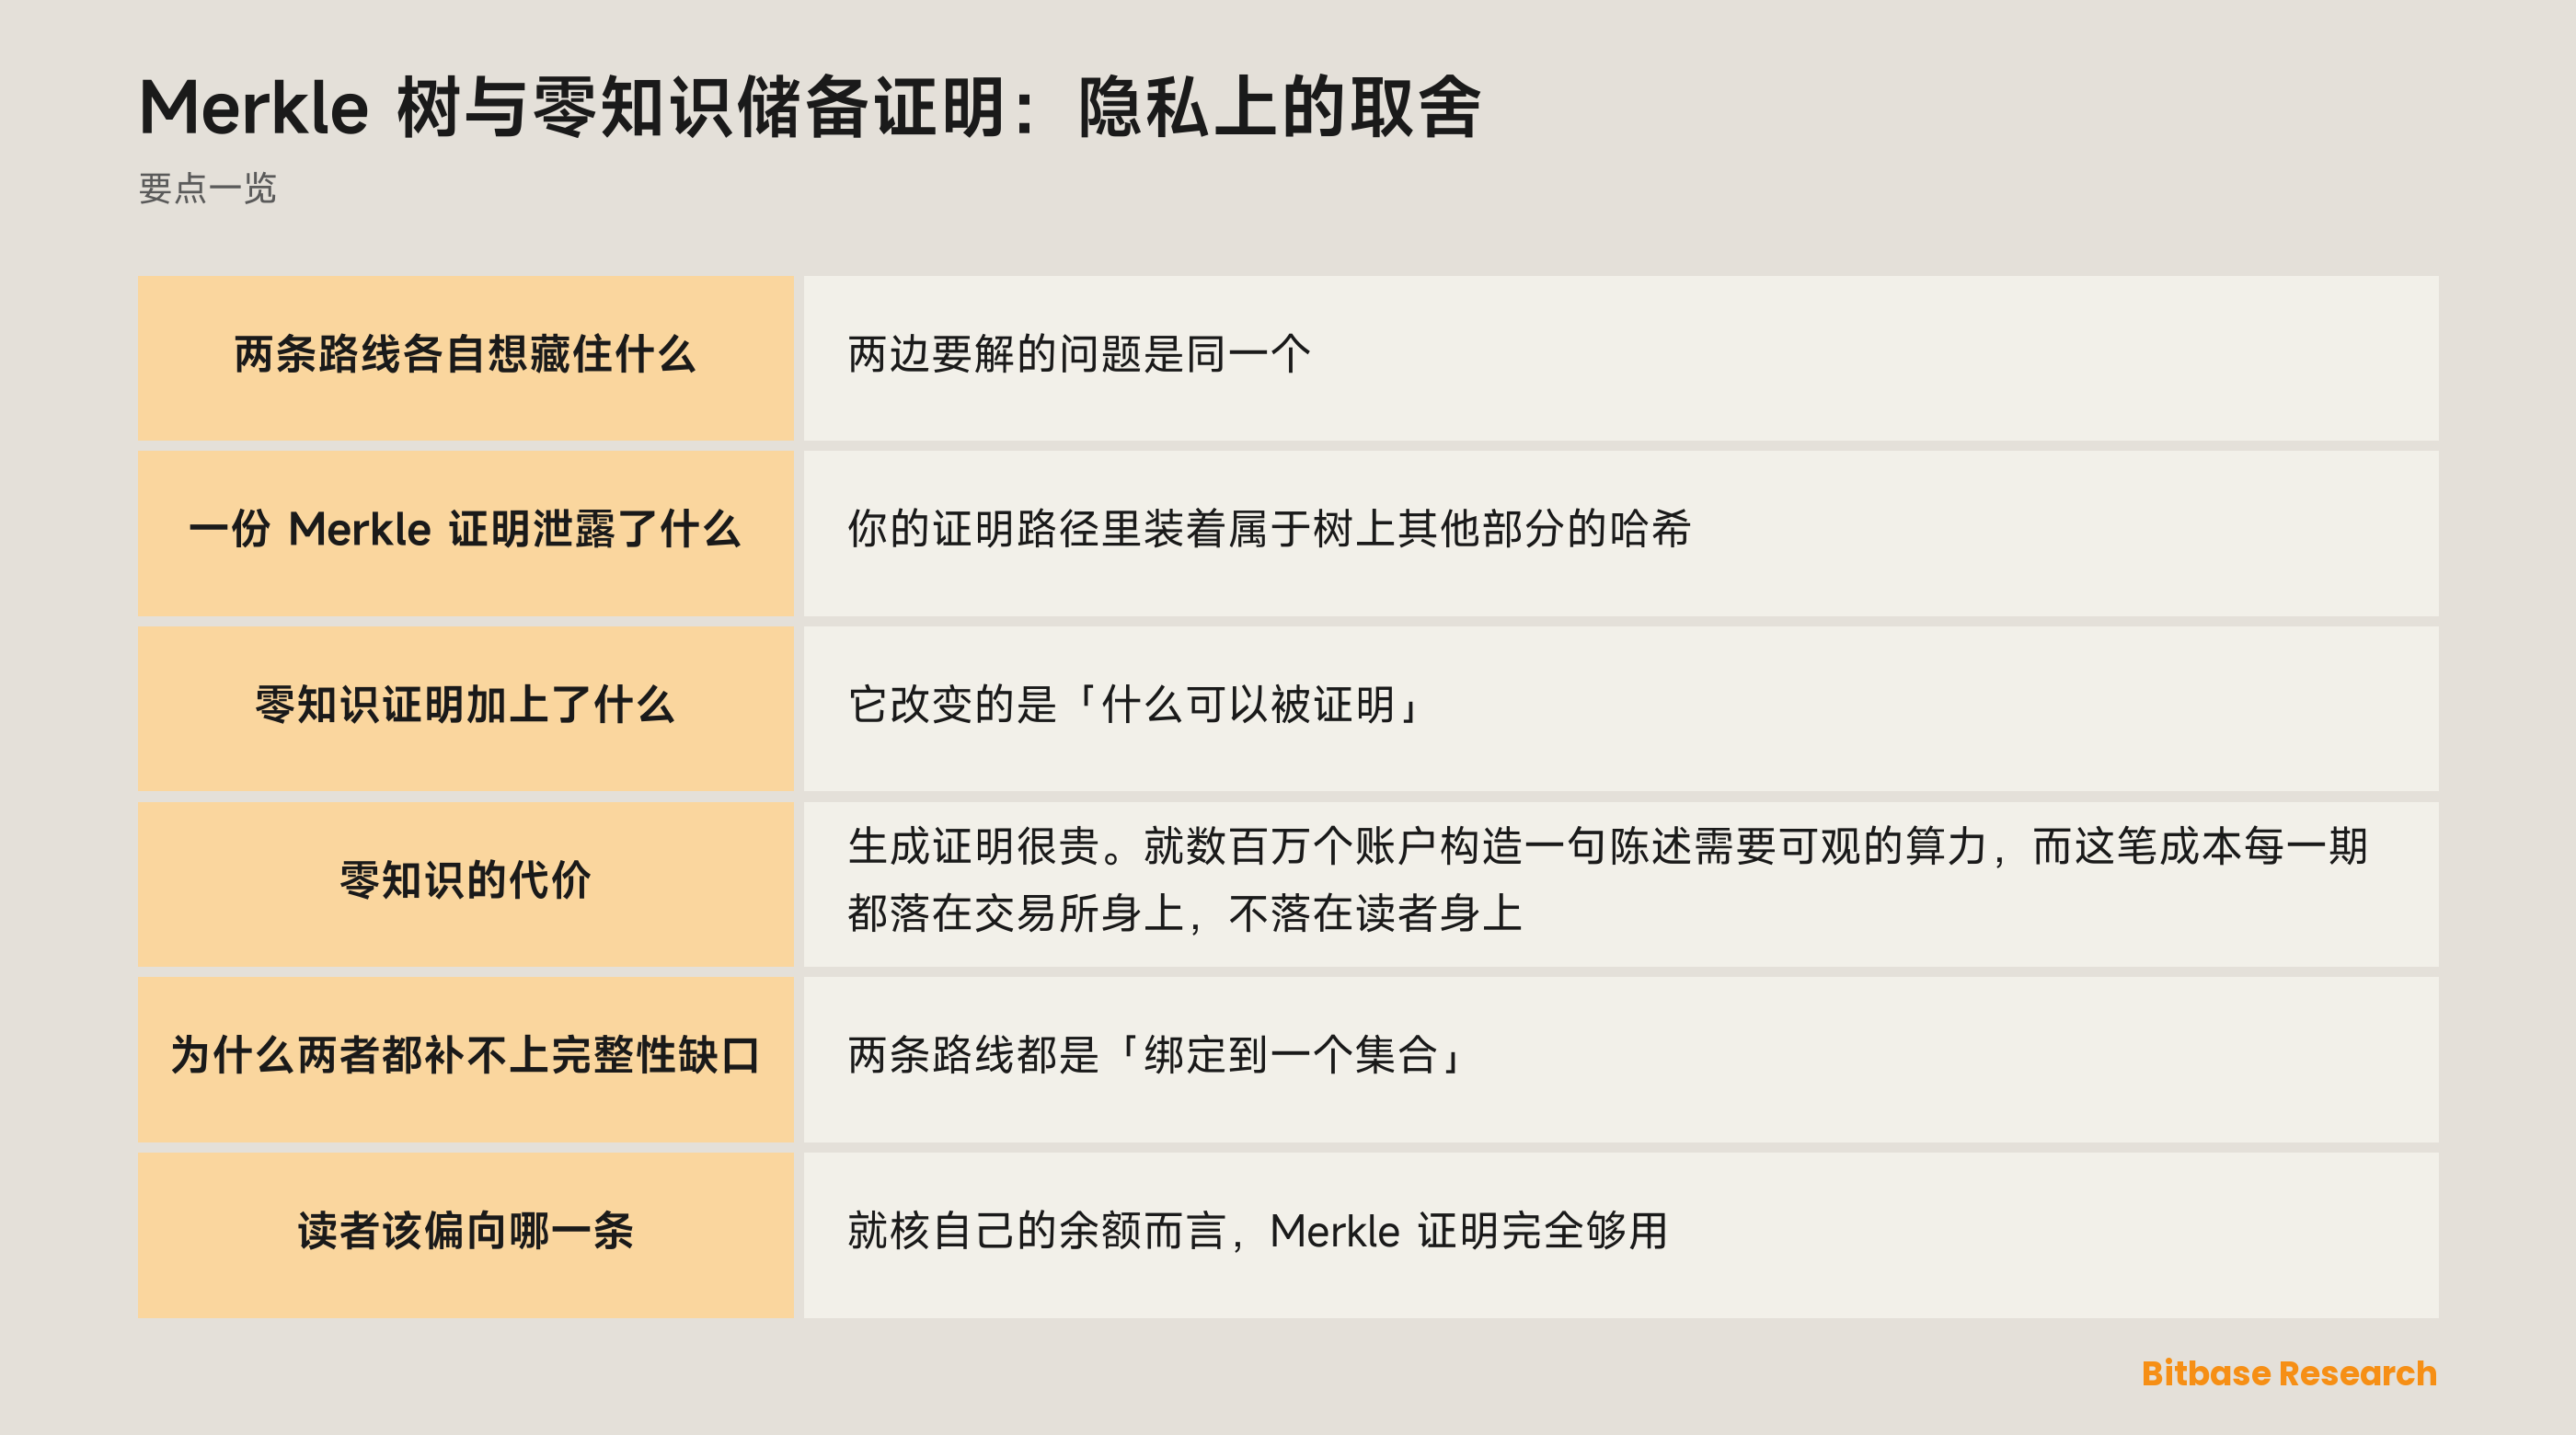
你的证明路径里装着属于树上其他部分的哈希。哈希不可逆,所以你对它们底下的余额一无所知;在这个意义上,泄露接近于零。
但不完全是零。你会知道这棵树有某种形状、里面大致有多少账户、以及某些兄弟值确实存在。一个长期收集大量证明的人,能比任何单个用户了解到更多关于结构的信息。
这些本身都不危险,也值得保持比例感:关于一棵树的结构信息,离关于一个人的信息还远得很。更实际的那个缺口是另一件事。因为每个用户只核自己那一行,Merkle 方案没法排除集合内部互相抵消的余额;而一个由「没有人交叉核对过的行」加总出来的总额,比它看起来更弱。
零知识证明加上了什么
它改变的是「什么可以被证明」。交易所不必一次证明一个成员资格,而可以证明整个集合的某个性质——比如所有余额之和等于某个写明的数字,并且没有任何一条余额是负的。
第二个从句比听起来重要。在朴素的 Merkle 方案下,没有任何东西阻止一条负项抵消掉一条正项;而树两种情况都会验过,因为它承诺的是「给它什么它就绑什么」。一句零知识陈述可以在构造上让这件事不可能。
这是密码学里一个通用形态的好例子:从「证明实例」转到「证明性质」,改变的是能保证什么,而不只是核起来有多快。隐私上的改进也是真的:验证者知道那句陈述成立,除此之外什么都不知道——包括对树的形状一无所知,所以反复的证明不会累积成一幅关于客户群的图。类似的推理也驱动着它在别处的应用,写在零知识用在哪里里。
零知识的代价
生成证明很贵。就数百万个账户构造一句陈述需要可观的算力,而这笔成本每一期都落在交易所身上,不落在读者身上。
更大的代价是概念上的。一次 Merkle 核验就是几十次哈希,任何理解哈希的人都能重新实现一遍;而一套零知识系统立在一个把陈述编码进去的电路上,以及那个电路被设置时用的参数上。核实这个电路说的是不是它声称的那件事,多数用户做不到。
还有一笔很少被提到的运维成本:电路是有版本的,而被证明的那句陈述一改,每一个独立复核者都得重看一遍。所以它把信任挪了位置,而不是消掉了信任。你不再需要信任交易所的算术,同时你现在需要信任这个电路被正确地写出并配置好——通常是凭复核过它的人的一句话。
为什么两者都补不上完整性缺口
两条路线都是「绑定到一个集合」。谁都确立不了这个集合包含了每一个账户,因为被漏掉的账户在两种构造里都不留痕迹;而任何关于一个集合被证明的性质,对留在集合外的东西都一言不发。
这一点值得直说,因为零知识证明的精巧会诱人假设它解决了一切。它们就「进来了的那些数据」做出了更强的陈述;它们对「从没进来的数据」什么都没说。
资产那一侧、以及客户余额之外的义务,同样如此。密码学定下的是一个被承诺的集合上能定的东西,其余的坐在外面——这写在储备证明的局限里。
读者该偏向哪一条
就核自己的余额而言,Merkle 证明完全够用,而且有一个好处:它能用你读得懂的工具去验。当做核验的人正是读者本人时,简单本身就是一项真实的安全性质。
就关于整个集合的陈述而言,零知识严格地更有能力,而「能排除负余额」是其中最清楚的一项具体收益。如果一份披露提供了它,那是关于「发布方对这个问题更难的那一半有多认真」的一个信号。
所以选择与其说是「哪种技术更优越」,不如说是「这份披露想回答的是哪个问题」。实践中两者共存而不是竞争:一个方案完全可以用树来绑定、给用户单独的证明,再加一句关于聚合性质的零知识陈述——这是合理的设计,不是自相矛盾。
小结
Merkle 树给每个用户一份便宜、读得懂的包含性证明,同时泄露少量结构信息。零知识证明能确立整个集合的性质——包括不存在负余额——同时什么都不透露。
更强的那件工具花算力,并把信任挪到一个多数人无法检视的电路上。而两者都证明不了这个集合是完整的;那仍然是密码学回答不了的那个问题。想继续读币贝学院的其他内容,请接着往下看。
风险披露:本文为 Bitbase(币贝)学院的科普内容,仅供教育与信息参考,不构成任何投资、交易、税务或财务建议。加密资产波动剧烈,请自行评估风险。本文撰写于 2026 年 9 月,请以官方最新信息为准。
参考资料
[1] 币贝,储备证明 —— 每月披露、Merkle 根哈希与开源验证工具 www.bitbase.com