Em resumo
- Os principais modelos da Anthropic e da OpenAI custam 100 vezes mais por token do que os menores, mas muitos usuários recorrem ao modelo principal para tudo.
- Os rankings de uso na Meta, na Amazon e na Uber elevaram as contas de IA, e a Uber esgotou seu orçamento de ferramentas de IA para 2026 em cerca de quatro meses.
- Direcionar tarefas para o modelo certo, reduzir o contexto, usar cache e agrupar em lotes reduzem custos drasticamente, mas há outras técnicas para economizar dinheiro.
Funcionários da Meta consumiram 60 trilhões de tokens de IA em 30 dias no início deste ano, disputando posições em um ranking interno apelidado de "Claudeonomics". O colunista de tecnologia Gergely Orosz estimou a conta em cerca de US$ 900 milhões pelos preços de tabela da Anthropic, embora a Meta provavelmente pague muito menos.
A consultora da Bain & Company Jue Wang vê uma versão mais silenciosa desse desperdício em toda parte: "Tantas empresas, tantos usuários, recorrem ao Opus para tudo, incluindo gerar e-mails", ela disse à Associated Press neste verão, referindo-se aos modelos de ponta da Anthropic. Se você faz a mesma coisa, está contratando Albert Einstein para calcular seu troco em um MacDonald's.
Cada palavra que você digita no ChatGPT ou no Claude, e cada palavra que ele escreve de volta, é medida em tokens, blocos de texto que equivalem, em média, a cerca de três quartos de uma palavra. Em uma assinatura de US$ 20, esse medidor decide a rapidez com que você atinge seu limite de uso. Na API, o acesso pago por token que os desenvolvedores usam para integrar modelos aos próprios aplicativos, ele decide a conta.
Aqui está a lista de preços atual da Anthropic, por milhão de tokens:
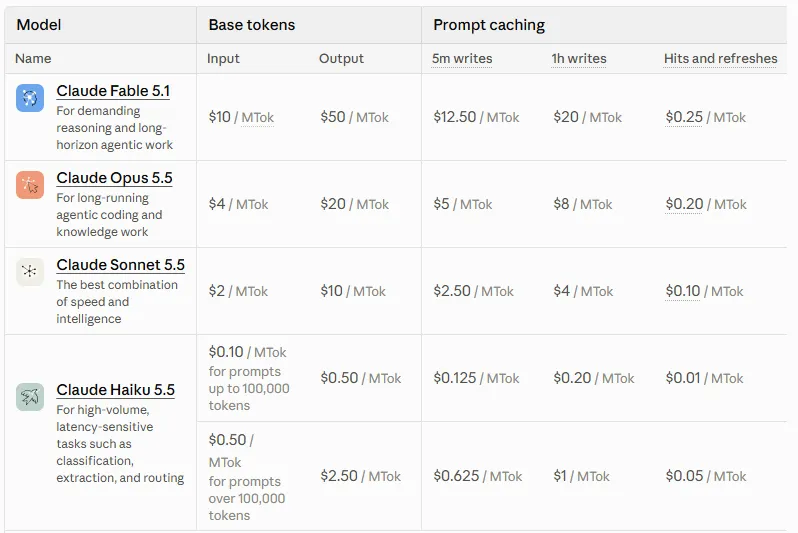
A tarifa do Haiku se aplica a prompts com menos de 100.000 tokens; prompts mais longos custam cinco vezes mais.
O modelo top custa 100 vezes mais que o menor, e a própria linha da OpenAI apresenta a mesma variação, de US$ 10 a US$ 0,10 por milhão de tokens de entrada. Esses preços por token se acumulam rapidamente para os laboratórios — e para você: a taxa de receita anualizada da Anthropic passou de cerca de US$ 9 bilhões no final de 2025 para mais de US$ 47 bilhões até maio, enquanto a OpenAI trava uma guerra de preços para acompanhar.
Alguns hábitos reduzem drasticamente esse gasto, e as cinco primeiras dicas abaixo não exigem nenhuma programação.
O que tokenmaxxing significa (e o que deveria significar)
O tokenmaxxing começou como uma demonstração de status do Vale do Silício, como o Claudeonomics da Meta, com Microsoft, Shopify e Amazon classificando funcionários em placares de tokens semelhantes. O CEO da Nvidia, Jensen Huang, jogou lenha na fogueira quando disse no podcast "All-In", em março, que ficaria "profundamente alarmado" se um engenheiro que ganha US$ 500.000 não queimasse pelo menos US$ 250.000 em tokens.
E queimaram tokens, sim… em coisas estúpidas e improdutivas.
Na Amazon, os funcionários admitiram inflar seus números executando a ferramenta interna de IA em tarefas irrelevantes, até que um vice-presidente sênior disse à equipe: "Por favor, não usem IA apenas pelo simples fato de usar IA."
Este guia usa o significado que os engenheiros estão defendendo agora: maximizar o valor de cada token, não a quantidade que você gasta.
Três conceitos explicam para onde vão os tokens, começando pelo loop do agente. Um agente é um modelo que pode usar ferramentas, então ele pensa, pesquisa na web ou executa código, lê o resultado e continua até decidir que terminou, reenviando toda a conversa a cada rodada.
A orquestração multiplica esse custo: um modelo atua como gerente, dividindo sua solicitação em partes, entregando-as a modelos trabalhadores chamados subagentes e costurando suas respostas de volta. Cada trabalhador executa seu próprio loop com sua própria memória, e é por isso que a Anthropic diz que equipes de agentes no Claude Code podem usar cerca de sete vezes mais tokens do que uma sessão padrão quando os colegas de equipe executam no modo de planejamento, uma configuração abordada nas dicas intermediárias abaixo.
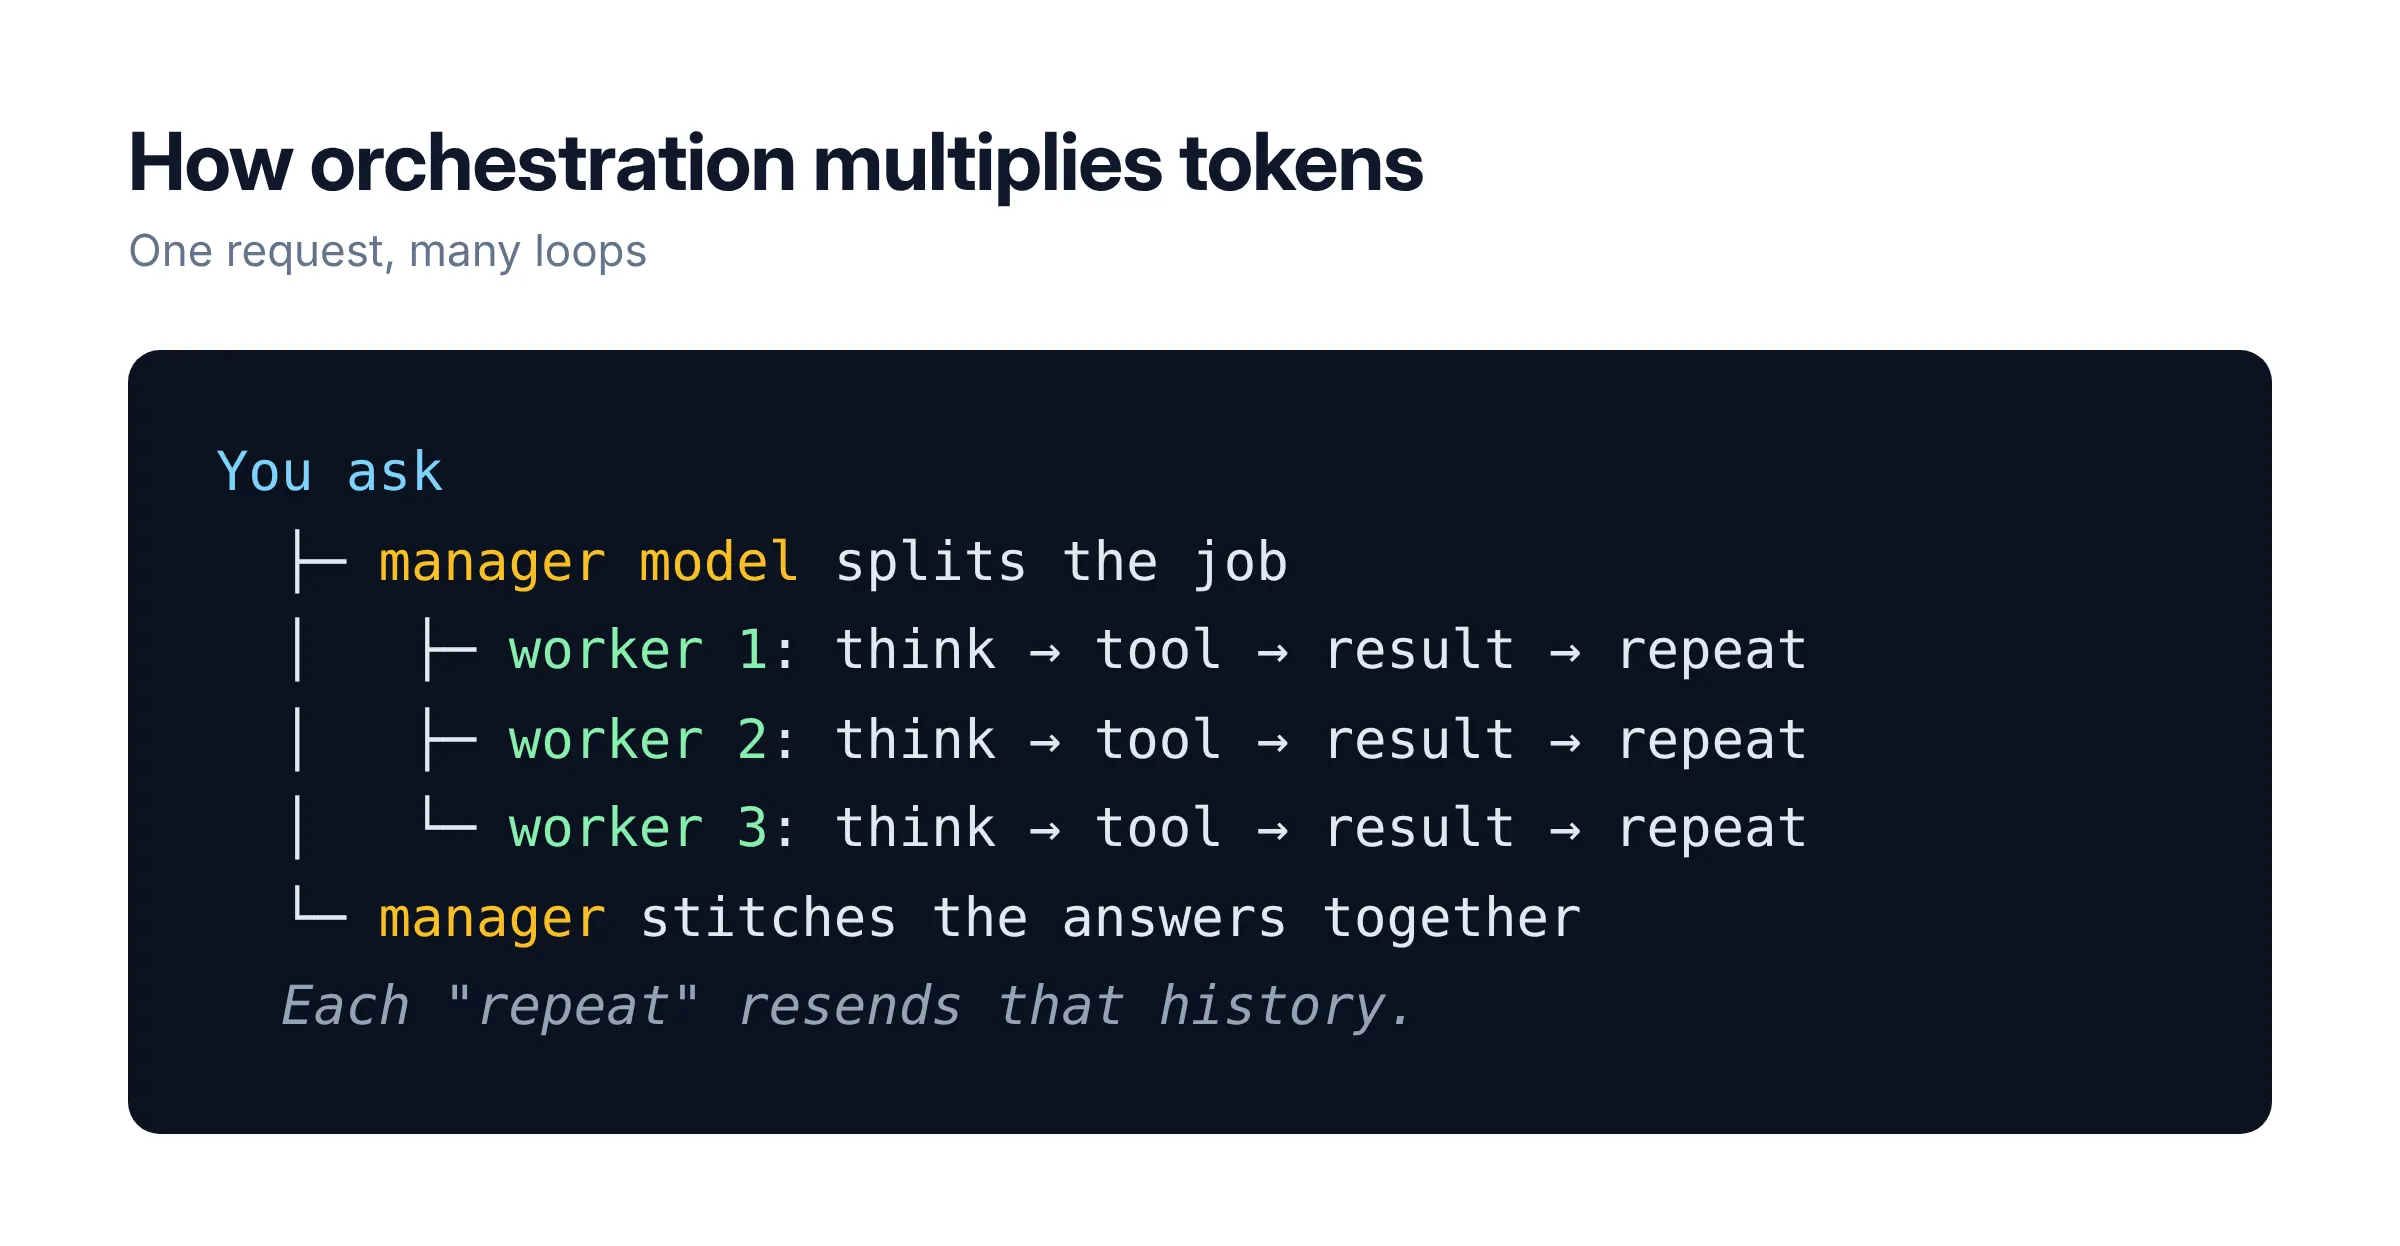
Grafos são como os desenvolvedores impedem que esses loops se desviem. Frameworks como o LangGraph permitem desenhar um fluxo de trabalho como um mapa de metrô, com estações (nós) fazendo o trabalho e trilhos (arestas) decidindo para onde ir em seguida, de modo que o modelo siga uma rota fixa em vez de ficar em loop até esgotar as ideias ou o orçamento.
Em outras palavras, os loops ajudam você a automatizar coisas e aumentar a qualidade, mas você também gastará muito dinheiro, então é extremamente importante ser eficiente. Aqui estão algumas dicas que podem ajudar você com isso
Iniciante: tarefas pequenas, modelos pequenos
1. Escolha o modelo para a tarefa
Se você está apenas começando, provavelmente está usando uma interface gráfica para executar sua IA.
Clique no nome do modelo no seu aplicativo de chat (no topo do chat no ChatGPT, ao lado do botão de enviar no Claude ou Hermes) e mude para uma opção menor e mais rápida para e-mails, resumos e reescritas. Mantenha o modelo principal para raciocínios difíceis e decisões em que um erro sutil custa dinheiro de verdade.
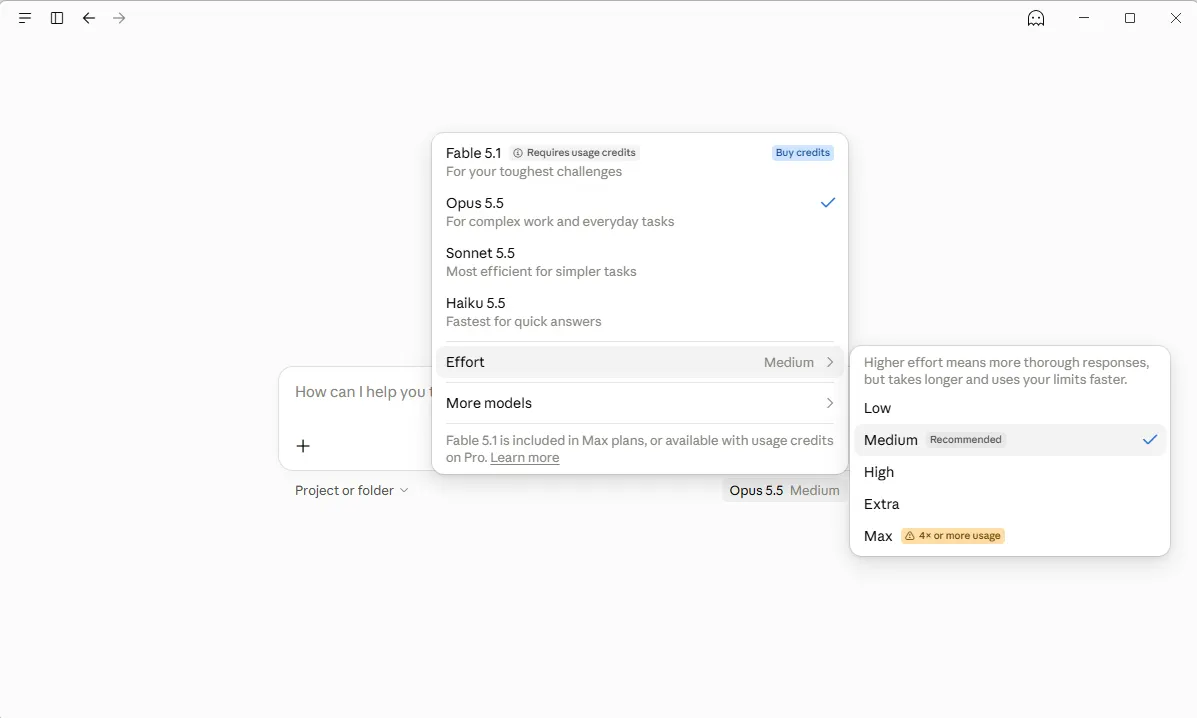
Execute cinco tarefas da semana passada em ambos os modelos lado a lado, e se o pequeno passar, mantenha-o. Em uma assinatura que estica seu limite de uso, e na API ele reduz a conta em até 99%.
2. Escreva um bom prompt em vez de cinco ruins
Três rodadas de "não, apenas o total" ou "deixe isso melhor e mais preciso" reenviam todo o chat a cada vez. Um prompt claro especifica a tarefa e a forma exata da resposta. Algo assim poderia funcionar:
Extraia o número da fatura, a data, o fornecedor e o total do texto abaixo. Mantenha cada valor exatamente como escrito. Retorne uma linha por campo, e escreva "ausente" se um campo não estiver lá.
Os próprios testes da OpenAI descobriram que prompts mais enxutos e claros obtiveram pontuações mais altas usando menos tokens.
3. Inicie um novo chat quando mudar de assunto
O modelo relê toda a conversa toda vez que você aperta enviar, então uma thread de 50 mensagens sobre suas férias torna sua pergunta sobre impostos mais cara e mais burra ao mesmo tempo.
A Anthropic chama essa degradação de "context rot".
Então, pelo amor de Deus, inicie um novo chat sempre que o assunto mudar.
4. Peça o tamanho que você precisa
Os tokens de saída custam cinco vezes mais que os de entrada nos principais modelos da Anthropic e da OpenAI. Termine seus prompts com algo como "três tópicos, menos de 100 palavras" ou "apenas as linhas alteradas", e o modelo terá menos espaço para encher linguiça.
Se o modelo tiver uma restrição em termos de comprimento de saída, ele economizará tokens, especialmente se a tarefa for criativa (como escrever ou pesquisar) e não determinística (como programar ou resolver matemática).
5. Experimente de graça antes de pagar
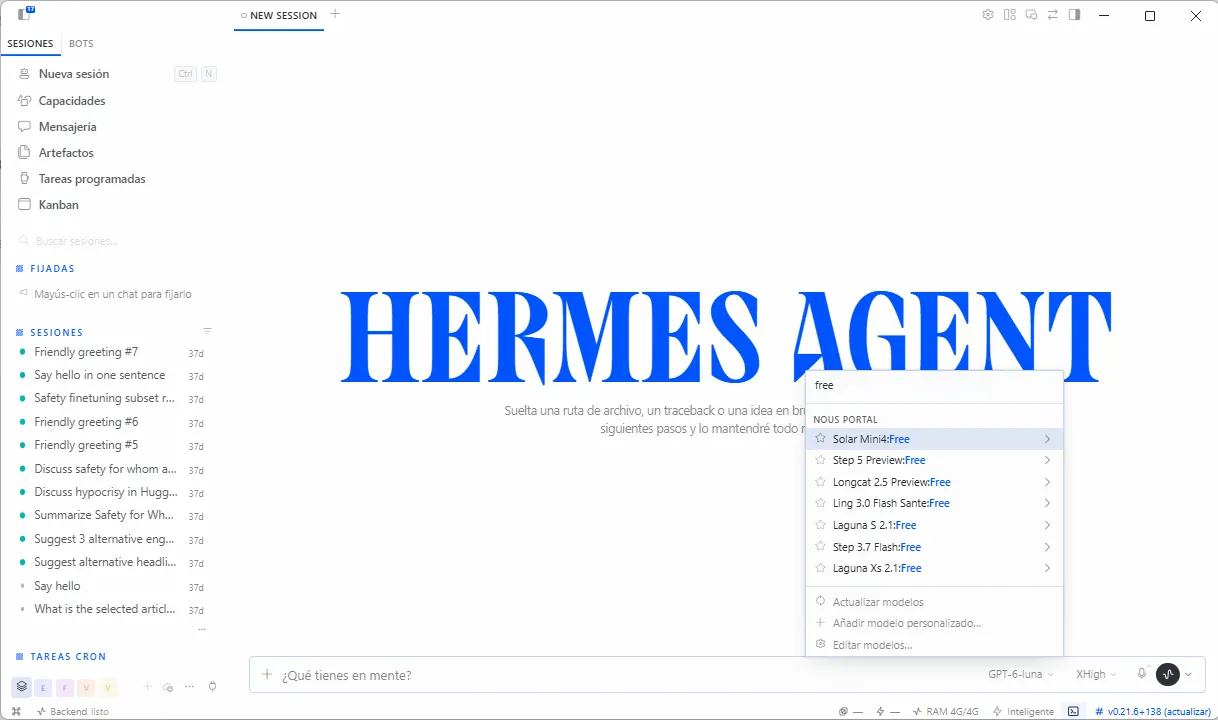
O OpenRouter, um site que se conecta a centenas de modelos de IA por meio de uma única conta, tem um roteador gratuito que envia sua solicitação para um dos cerca de 20 modelos sem custo. Você também pode executar modelos localmente com o LM Studio ou o Ollama em uma placa de vídeo com 8 GB de memória de vídeo ou em um Mac com chip da série M da Apple.
Os níveis gratuitos podem desaparecer da noite para o dia, então não construa nada importante em cima de um deles, e leia a política de dados antes de colar qualquer coisa sensível.
Dito isso, você pode maximizar suas iterações usando ofertas gratuitas. O Hermes tem uma boa seleção de modelos gratuitos que podem fazer o trabalho que você precisa, e a Nvidia também. É melhor ajustar um prompt com um modelo gratuito mais burro do que pagar por um modelo premium que fará a mesma coisa, mas mais rápido.
Dicas adicionais para iniciantes
Pule o raciocínio estendido para perguntas simples, ou reduza a configuração de esforço nos modelos Claude mais recentes, onde o raciocínio não pode ser desativado. A Anthropic cobra o processo de raciocínio completo como saída, incluindo a parte que você nunca vê.
Assinantes do Claude Pro e Max que ativam os créditos de uso podem definir um limite de gastos mensal em Configurações, depois Uso.
Intermediário: seu agente está lendo muito mais do que deveria
A partir daqui, os exemplos usam o Claude Code, o agente da Anthropic que roda no seu terminal e edita arquivos para você; os comandos vão direto na caixa de chat dele. Outros ambientes terão lógica semelhante.
Se você usa apenas os aplicativos de chat, a dica 8 também funciona em qualquer janela de chat.
6. Comece barato, escale em caso de falha
Digite /model para trocar de modelo, mantenha o Sonnet como padrão e mude para o Opus apenas quando o Sonnet falhar em algo específico, como um bug que ele não consegue corrigir após duas tentativas. Para tarefas simples de subagente, a documentação da Anthropic sugere definir model: haiku nas configurações do subagente.
7. Limpe entre tarefas
Digite /clear quando você mudar para uma tarefa não relacionada, o que não custa nada e descarta o histórico antigo. Use /compact com uma nota sobre o que manter, como /compact keep the database decisions, apenas quando você precisar do histórico, já que compactar é, por si só, uma requisição grande.
8. Deixe o código fazer a matemática chata
Colar uma planilha de 5.000 linhas em um chat faz o modelo ler cada linha, e ele ainda pode contar errado, porque um modelo de linguagem não é uma calculadora, não importa quanto você pague por ele.
Peça a ele uma fórmula ou um script curto, execute você mesmo e entregue ao modelo apenas o resultado.
9. Reduza suas ferramentas
Servidores MCP são plugins que conectam um modelo a aplicativos como GitHub ou Google Drive, e cada um adiciona nomes de ferramentas e instruções a cada sessão.
Digite /context para ver o que está consumindo espaço e /mcp para desativar servidores que o projeto não usa.
Dicas intermediárias adicionais
Digite /usage para ver para onde foram seus tokens. Mantenha seu CLAUDE.md (ou Soul.md), o arquivo de instruções que seu agente lê no início de cada sessão, com menos de 200 linhas.
Para mudanças maiores, pressione Shift+Tab para mudar para o modo de planejamento, no qual o agente propõe um plano para sua aprovação antes de tocar nos arquivos, e aperte Esc no momento em que ele seguir o caminho errado. Use /effort para reduzir o raciocínio em tarefas simples, como renomear uma variável.
A Anthropic mostrou o uso de tokens de um agente caindo de 150.000 tokens para 2.000 quando ele carregava apenas as definições de ferramentas de que precisava, então ferramentas de linha de comando como o gh do GitHub, que não custam nada até serem executadas, muitas vezes superam um plugin sempre ativo.
Avançado: incorpore as proteções ao sistema
Pegue um desenvolvedor que precisa processar 1.000 faturas de 2.000 tokens cada, com respostas de 200 tokens: a tarefa custa cerca de US$ 30 no Fable 5.1 e cerca de US$ 0,30 no Haiku 5.5, antes de qualquer um dos truques abaixo.
10. Faça cache das partes que nunca mudam
Coloque as instruções estáveis primeiro e as partes variáveis por último, e marque o bloco estável para cache. Na API da Anthropic, isso é um campo extra:
"system": [{
"type": "text",
"text": "Suas instruções de fatura...",
"cache_control": {"type": "ephemeral"}
}]
Ler do cache custa uma fração do preço normal de entrada, enquanto escrever no cache padrão de cinco minutos custa a mais. Verifique o campo cache_read_input_tokens em cada resposta; se ele ainda estiver zerado após a primeira chamada, o cache não está funcionando.
11. Agrupe em lote tudo o que puder esperar
Tanto a OpenAI quanto a Anthropic processam trabalhos em lote com 50% de desconto, com a OpenAI prometendo resultados em até 24 horas. Envie as 1.000 faturas como um único arquivo de lote em vez de fazer 1.000 chamadas ao vivo, e a conta cai drasticamente.
12. Mantenha os agentes na coleira
Defina um número máximo de etapas e um limite em dólares para cada execução de agente, e defina como é "concluído" antes de começar. O Claude Code aceita uma flag --max-budget-usd para execuções em script, e a Shopify usa disjuntores que podem cortar o acesso de um desenvolvedor imediatamente se seus gastos dispararem em um dia, criados para conter agentes descontrolados.
No momento, o normal a se fazer é realmente liberar esses agentes e deixá-los em loop até que o resultado seja considerado perfeito. Se você não tem o dinheiro, não deixe simplesmente que seus agentes decidam o que é ou não "perfeito".
Dicas avançadas adicionais
Coloque fatos críticos no início ou no fim de um prompt longo. Um estudo liderado por Stanford descobriu que os modelos usam melhor as informações nessas posições e pior quando elas estão enterradas no meio.
Pague por um segundo modelo para verificar o trabalho apenas quando um erro for caro, como uma cláusula de contrato ou um valor de pagamento. Na API da OpenAI, ative um limite rígido de gastos para cada projeto, já que seus alertas de gastos apenas notificam você e não interrompem o tráfego.
Comece com um teste
Faça do modelo mais barato que passa no seu teste de cinco tarefas da dica 1 o seu padrão por uma semana, e troque apenas quando ele falhar. Depois, compare sua página de uso com a da semana anterior; no trabalho da fatura, só o roteamento reduziu a conta de US$ 30 para US$ 3,90, mesmo depois de pagar o Opus 5.5 para refazer 300 falhas.
Tokens mais baratos não farão o trabalho sozinhos, porém: o preço de um único token caiu mais de 90% desde 2023, segundo o Token Expenditure Index da Silicon Data, mas os gastos com grandes modelos de linguagem dobraram desde o final de 2025.
Os economistas chamam isso de paradoxo de Jevons, quando um recurso fica tão barato que as pessoas acabam gastando mais com ele no total. Um resumo da Bain & Co. de junho encontrou o mesmo padrão, com os custos de tokens caindo pela metade entre dezembro de 2024 e 2025, enquanto o número de tokens consumidos cresceu 450%.
O lado positivo é que os mesmos preços em queda trabalham a seu favor no momento em que você para de queimar tokens por esporte: combine-os com os hábitos acima, e a IA fica mais barata e melhor ao mesmo tempo.