
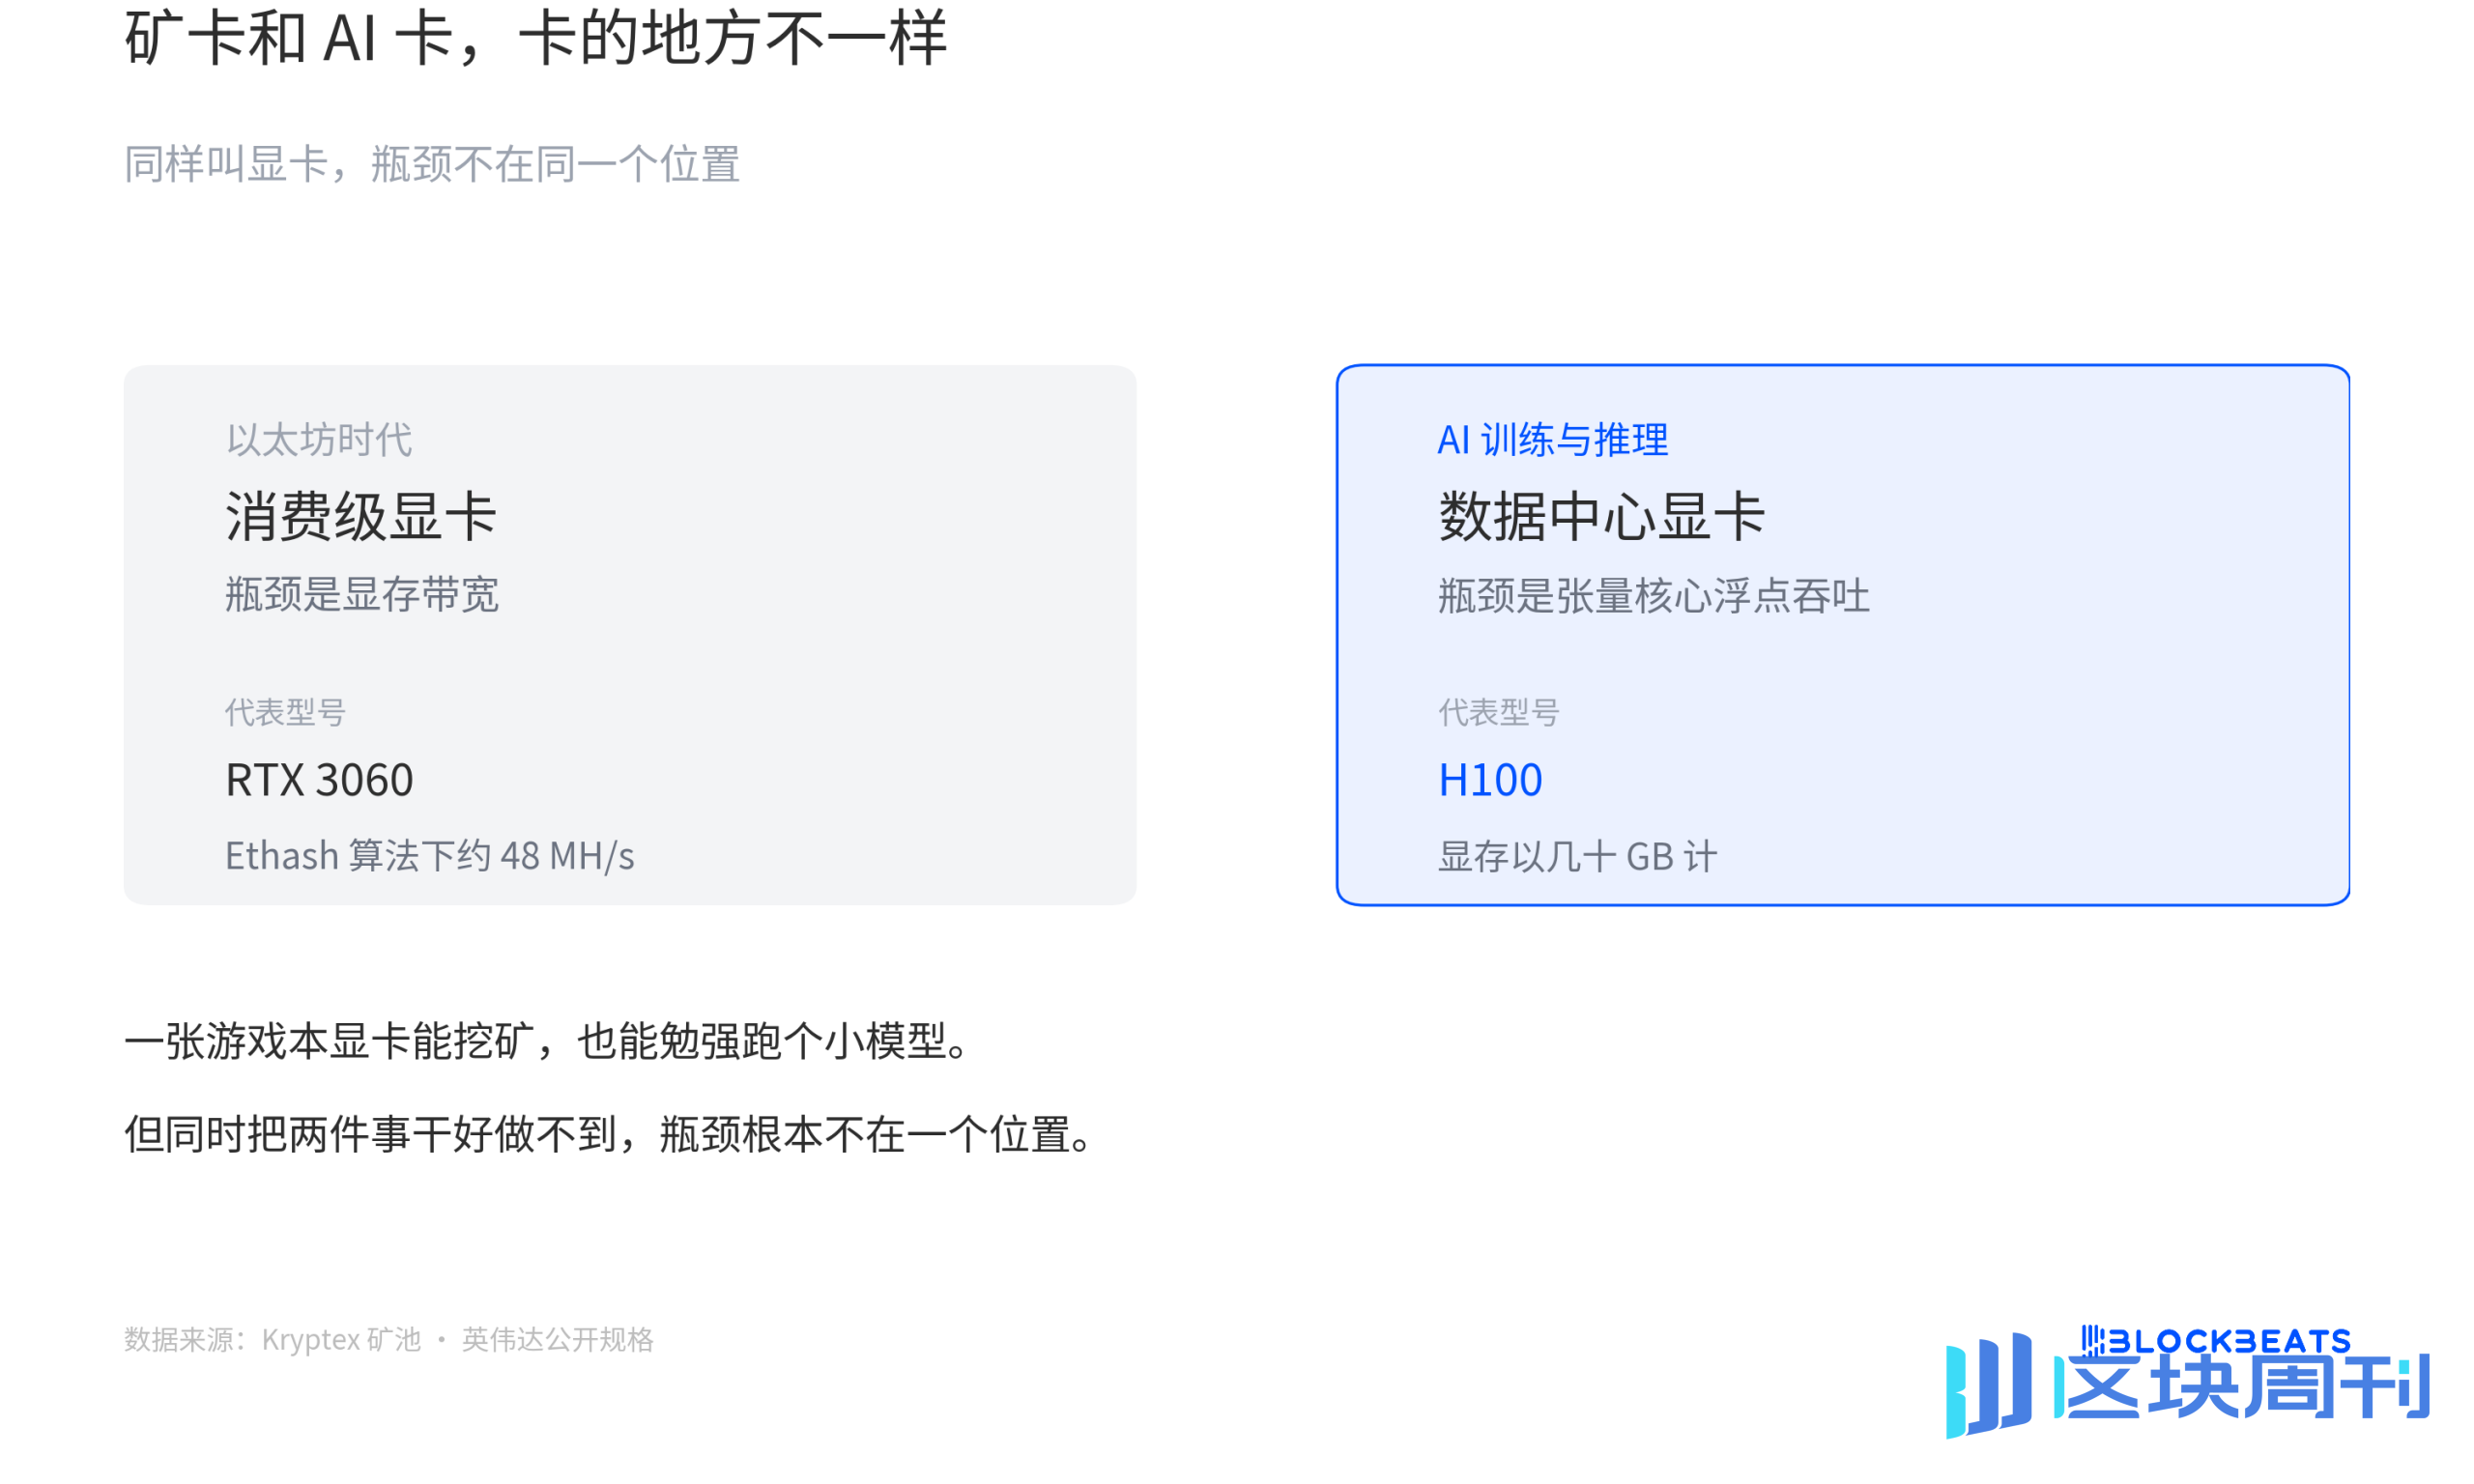
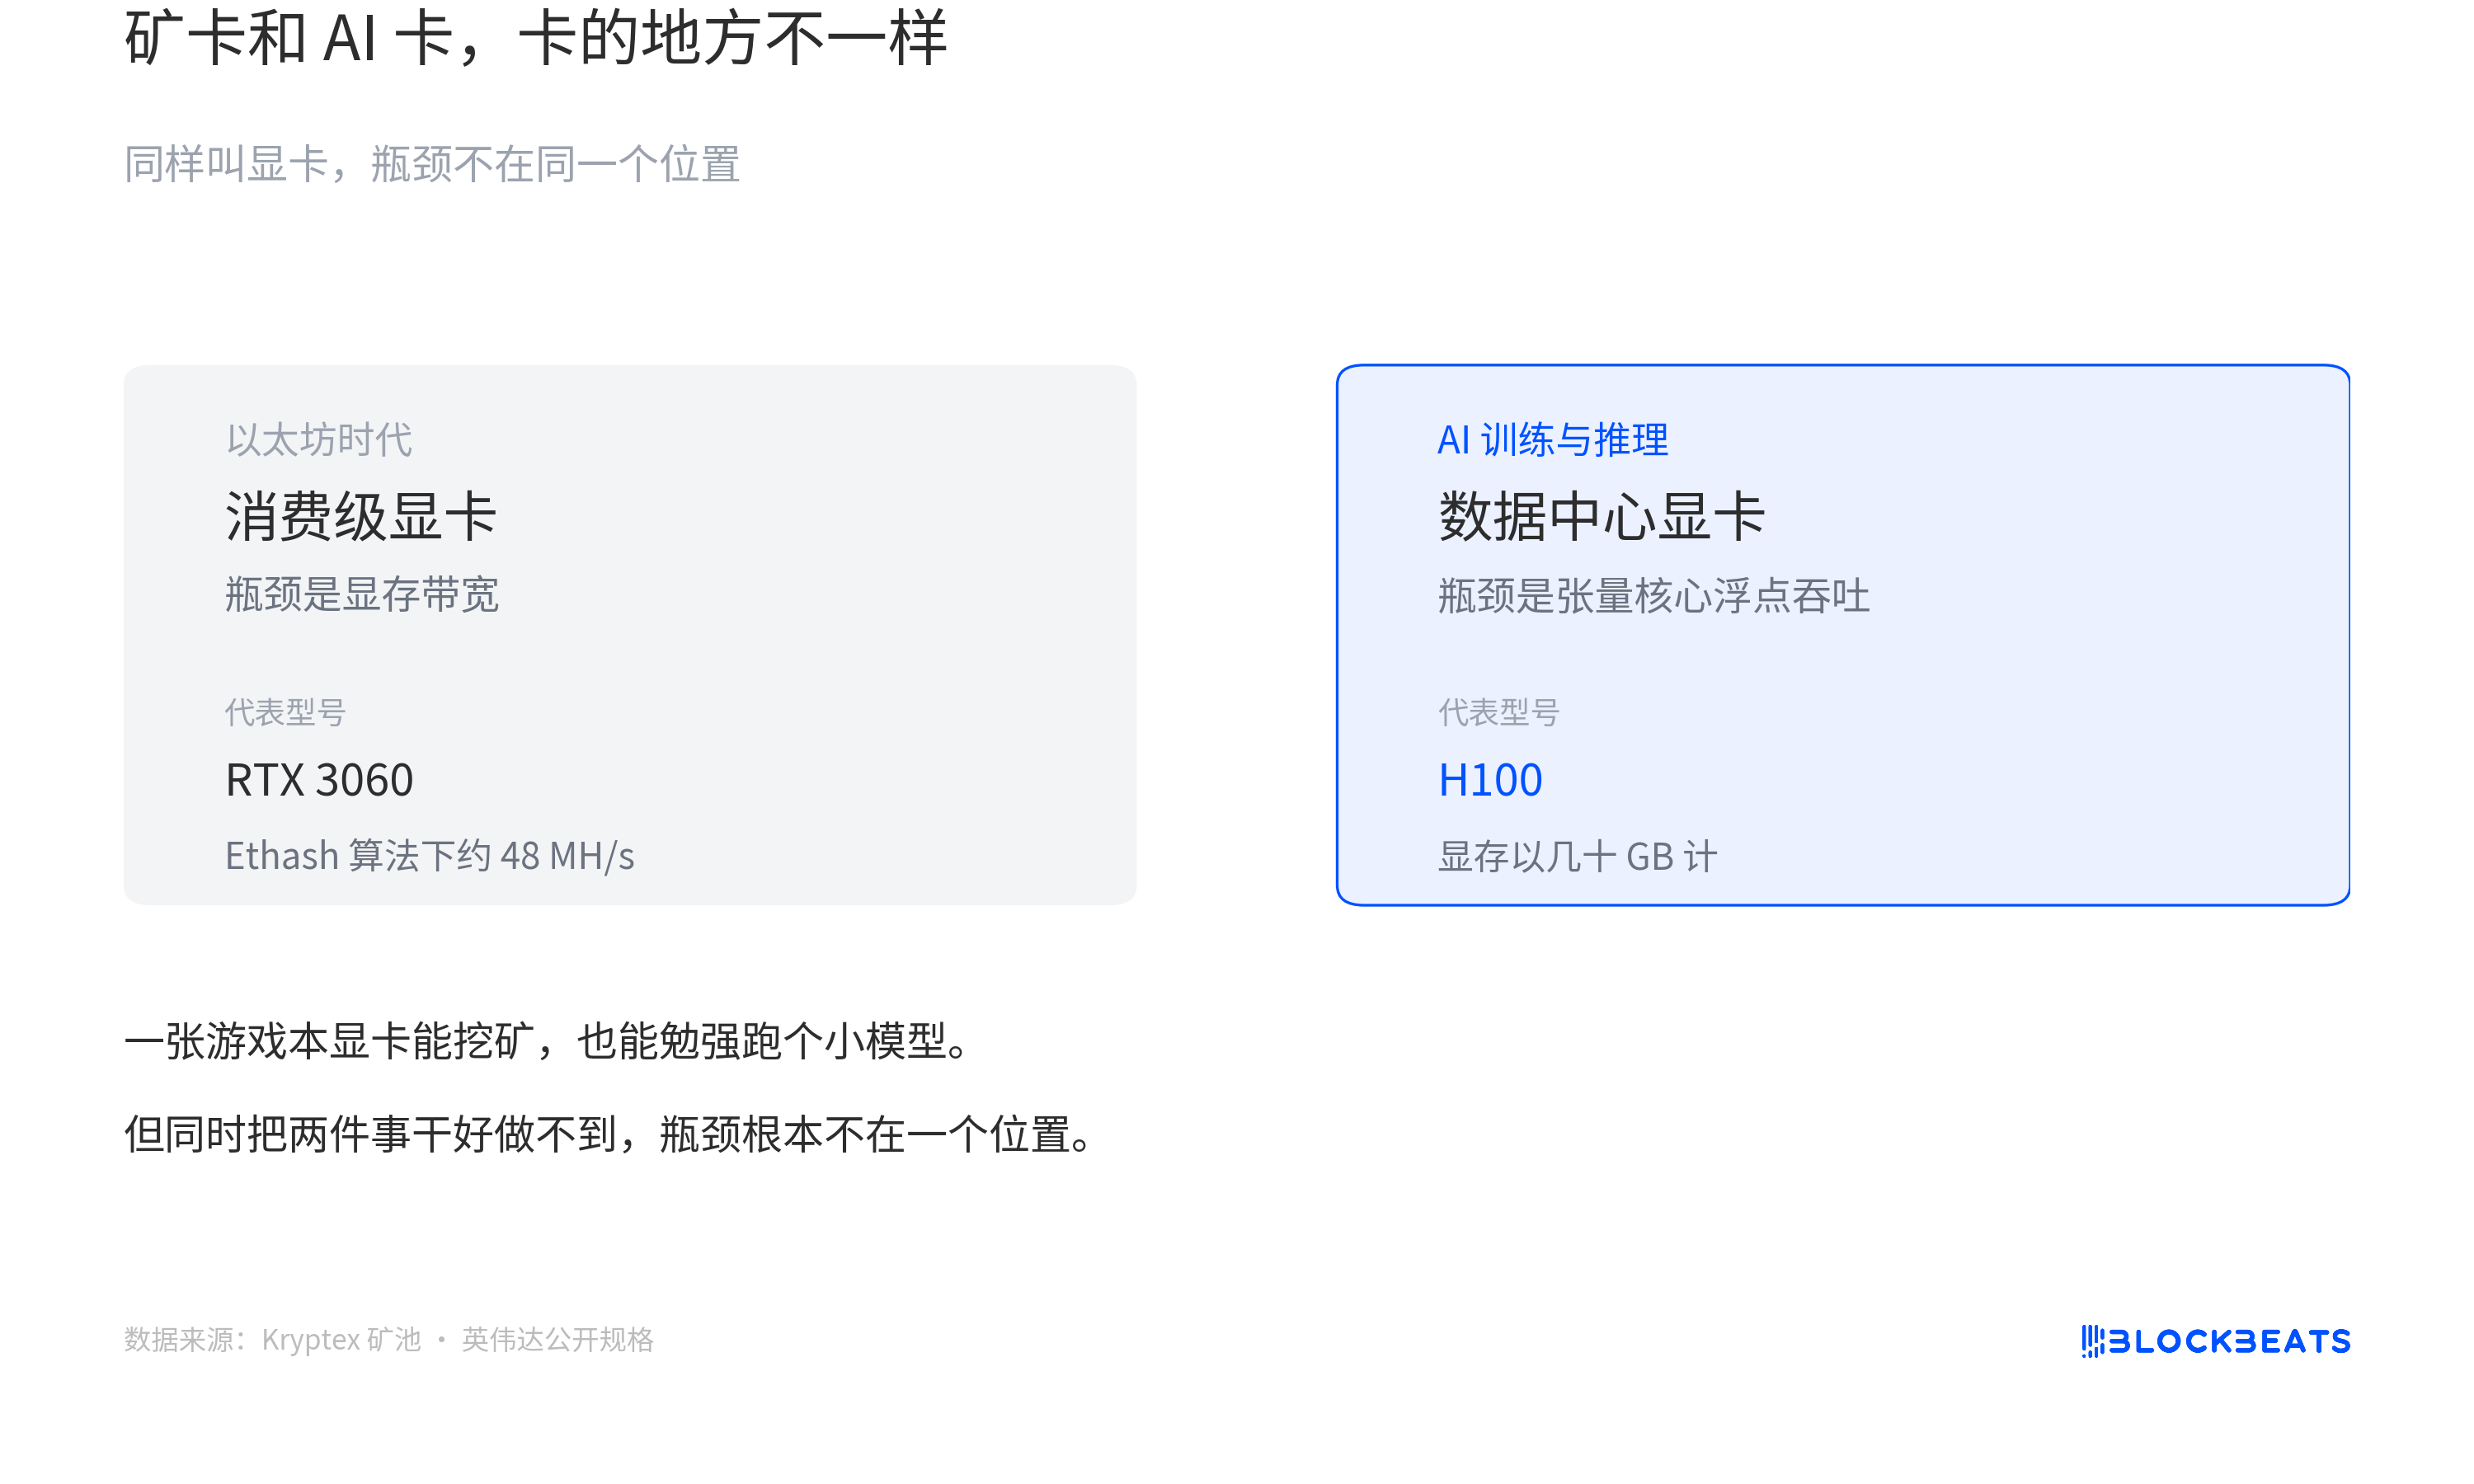
Durante os anos em que o Ethereum ainda era POW, os mineradores usavam placas de vídeo de consumidor, e o algoritmo era chamado de Ethash. Uma RTX 3060 faz cerca de 48 MH/s no Ethash. Na época, algumas pessoas pensaram que, como tanto a mineração quanto a IA dependem de placas de vídeo, a mesma placa poderia minerar e rodar modelos ao mesmo tempo.
Essa ideia não funcionou porque as duas coisas têm gargalos em lugares diferentes. O Ethash é limitado pela largura de banda de memória e calcula hashes de dificuldade fixa. A IA precisa de throughput de ponto flutuante dos tensor cores e de dezenas de GB de VRAM, com as principais cargas de trabalho sendo placas de data center como a H100. Uma placa de vídeo em um laptop gamer pode minerar e mal consegue rodar um modelo pequeno, mas não consegue fazer as duas coisas bem ao mesmo tempo.
Em 2019, Vitalik Buterin fez um julgamento sobre esse assunto. Suas palavras originais foram que, se algum tipo de computação útil e facilmente verificável pudesse ser encontrada, a mineração de criptomoedas se tornaria uma enorme riqueza para a sociedade, mas isso provavelmente é impossível.
A Pearl afirma que conseguiu. O julgamento de Vitalik de alguns anos atrás é exibido com destaque no site oficial da Pearl.
A Pearl é uma blockchain pública independente de prova de trabalho, e seu token é chamado de PRL. Os mineradores não calculam mais hashes repetidamente; em vez disso, fazem multiplicação de matrizes, que é o tipo de multiplicação e adição que cada camada de uma rede neural executa. Por design, a mesma computação de GPU tanto produz blocos e emite moedas, quanto produz computação de IA verificável.
A descrição oficial disso é "energia, dados e dinheiro em uma só operação". O Bitcoin une energia e dinheiro, a IA une energia e dados, e a monetização une dados e dinheiro. Essas três coisas costumavam se encontrar duas a duas; a Pearl quer que todas as três aconteçam simultaneamente em uma única multiplicação de matrizes.
A linha PoW está quieta há muito tempo. O último lote de novas blockchains públicas que conseguia fazer as pessoas sentarem e discutirem seriamente basicamente terminou anos atrás. Depois disso, a empolgação ficou com L2s, modularidade e restaking. Uma nova chain PoW por si só é rara. Agora a PRL, com um market cap circulante de 430 milhões de dólares, quer contar que tipo de história?
Que problema ela quer resolver
A prova de trabalho do Bitcoin tem uma característica: o que os mineradores calculam não tem nada a ver com o mundo real. O mesmo quilowatt-hora, se usado para rodar modelos, pode produzir tokens, gerar imagens e fazer trabalho. Muitas pessoas acham um pouco desperdício usá-lo para mineração.
A verdadeira dificuldade não é a "utilidade", mas a permissão livre. Permissão livre significa que qualquer um pode vir minerar, sem se registrar, e ninguém revisa qualificações. O modelo de segurança do Bitcoin é construído sobre isso: não importa o que você calcule, o custo é o mesmo. Uma vez que o trabalho é substituído por algo de valor real no mundo, os mineradores têm incentivo para cortar caminho ou escolher uma entrada barata. Então a questão não é se a mineração pode ser tornada útil, mas se pode ser tornada útil enquanto ninguém pode trapacear.
A própria alegação da Pearl é que ela substitui o hashing aleatório do Bitcoin por multiplicação de matrizes, permitindo que as GPUs tratem a prova de trabalho como um subproduto de cargas de trabalho de IA. O whitepaper usa diretamente o termo "2 por 1". Em termos simples, anteriormente um lote de GPUs tinha apenas dois destinos: ou minerar, queimando eletricidade enquanto emitia moedas, ou rodar modelos, queimando eletricidade enquanto produzia tokens. A Pearl quer fundir esses dois destinos em um.
Alguém calculou essa ideia em detalhes. O artigo do pesquisador de criptografia Rafael Pass, "The Economics of Proof-of-Useful-Work", divide o trabalho de uma máquina em três tipos: mineração pura, inferência pura e trabalho duplo que produz ambos simultaneamente. O trabalho duplo não é gratuito. O artigo dá um exemplo: uma unidade de poder computacional fazendo duas coisas ao mesmo tempo não obtém duas saídas, mas cerca de uma e meia. Se a sobrecarga for pequena o suficiente e a escala em que o token é aceito pelo mercado for grande o suficiente, a recompensa de bloco é equivalente a dar um rebate no preço de inferência, atraindo poder computacional de inferência que de outra forma não teria sido feito. Esse raciocínio é matematicamente impecável, mas o problema é que suas três variáveis — sobrecarga, preço do token e demanda de inferência — não são algo que a Pearl pode decidir sozinha. Uma nota de rodapé no artigo divulga que o autor completou este trabalho enquanto consultor da Pearl Research Labs.
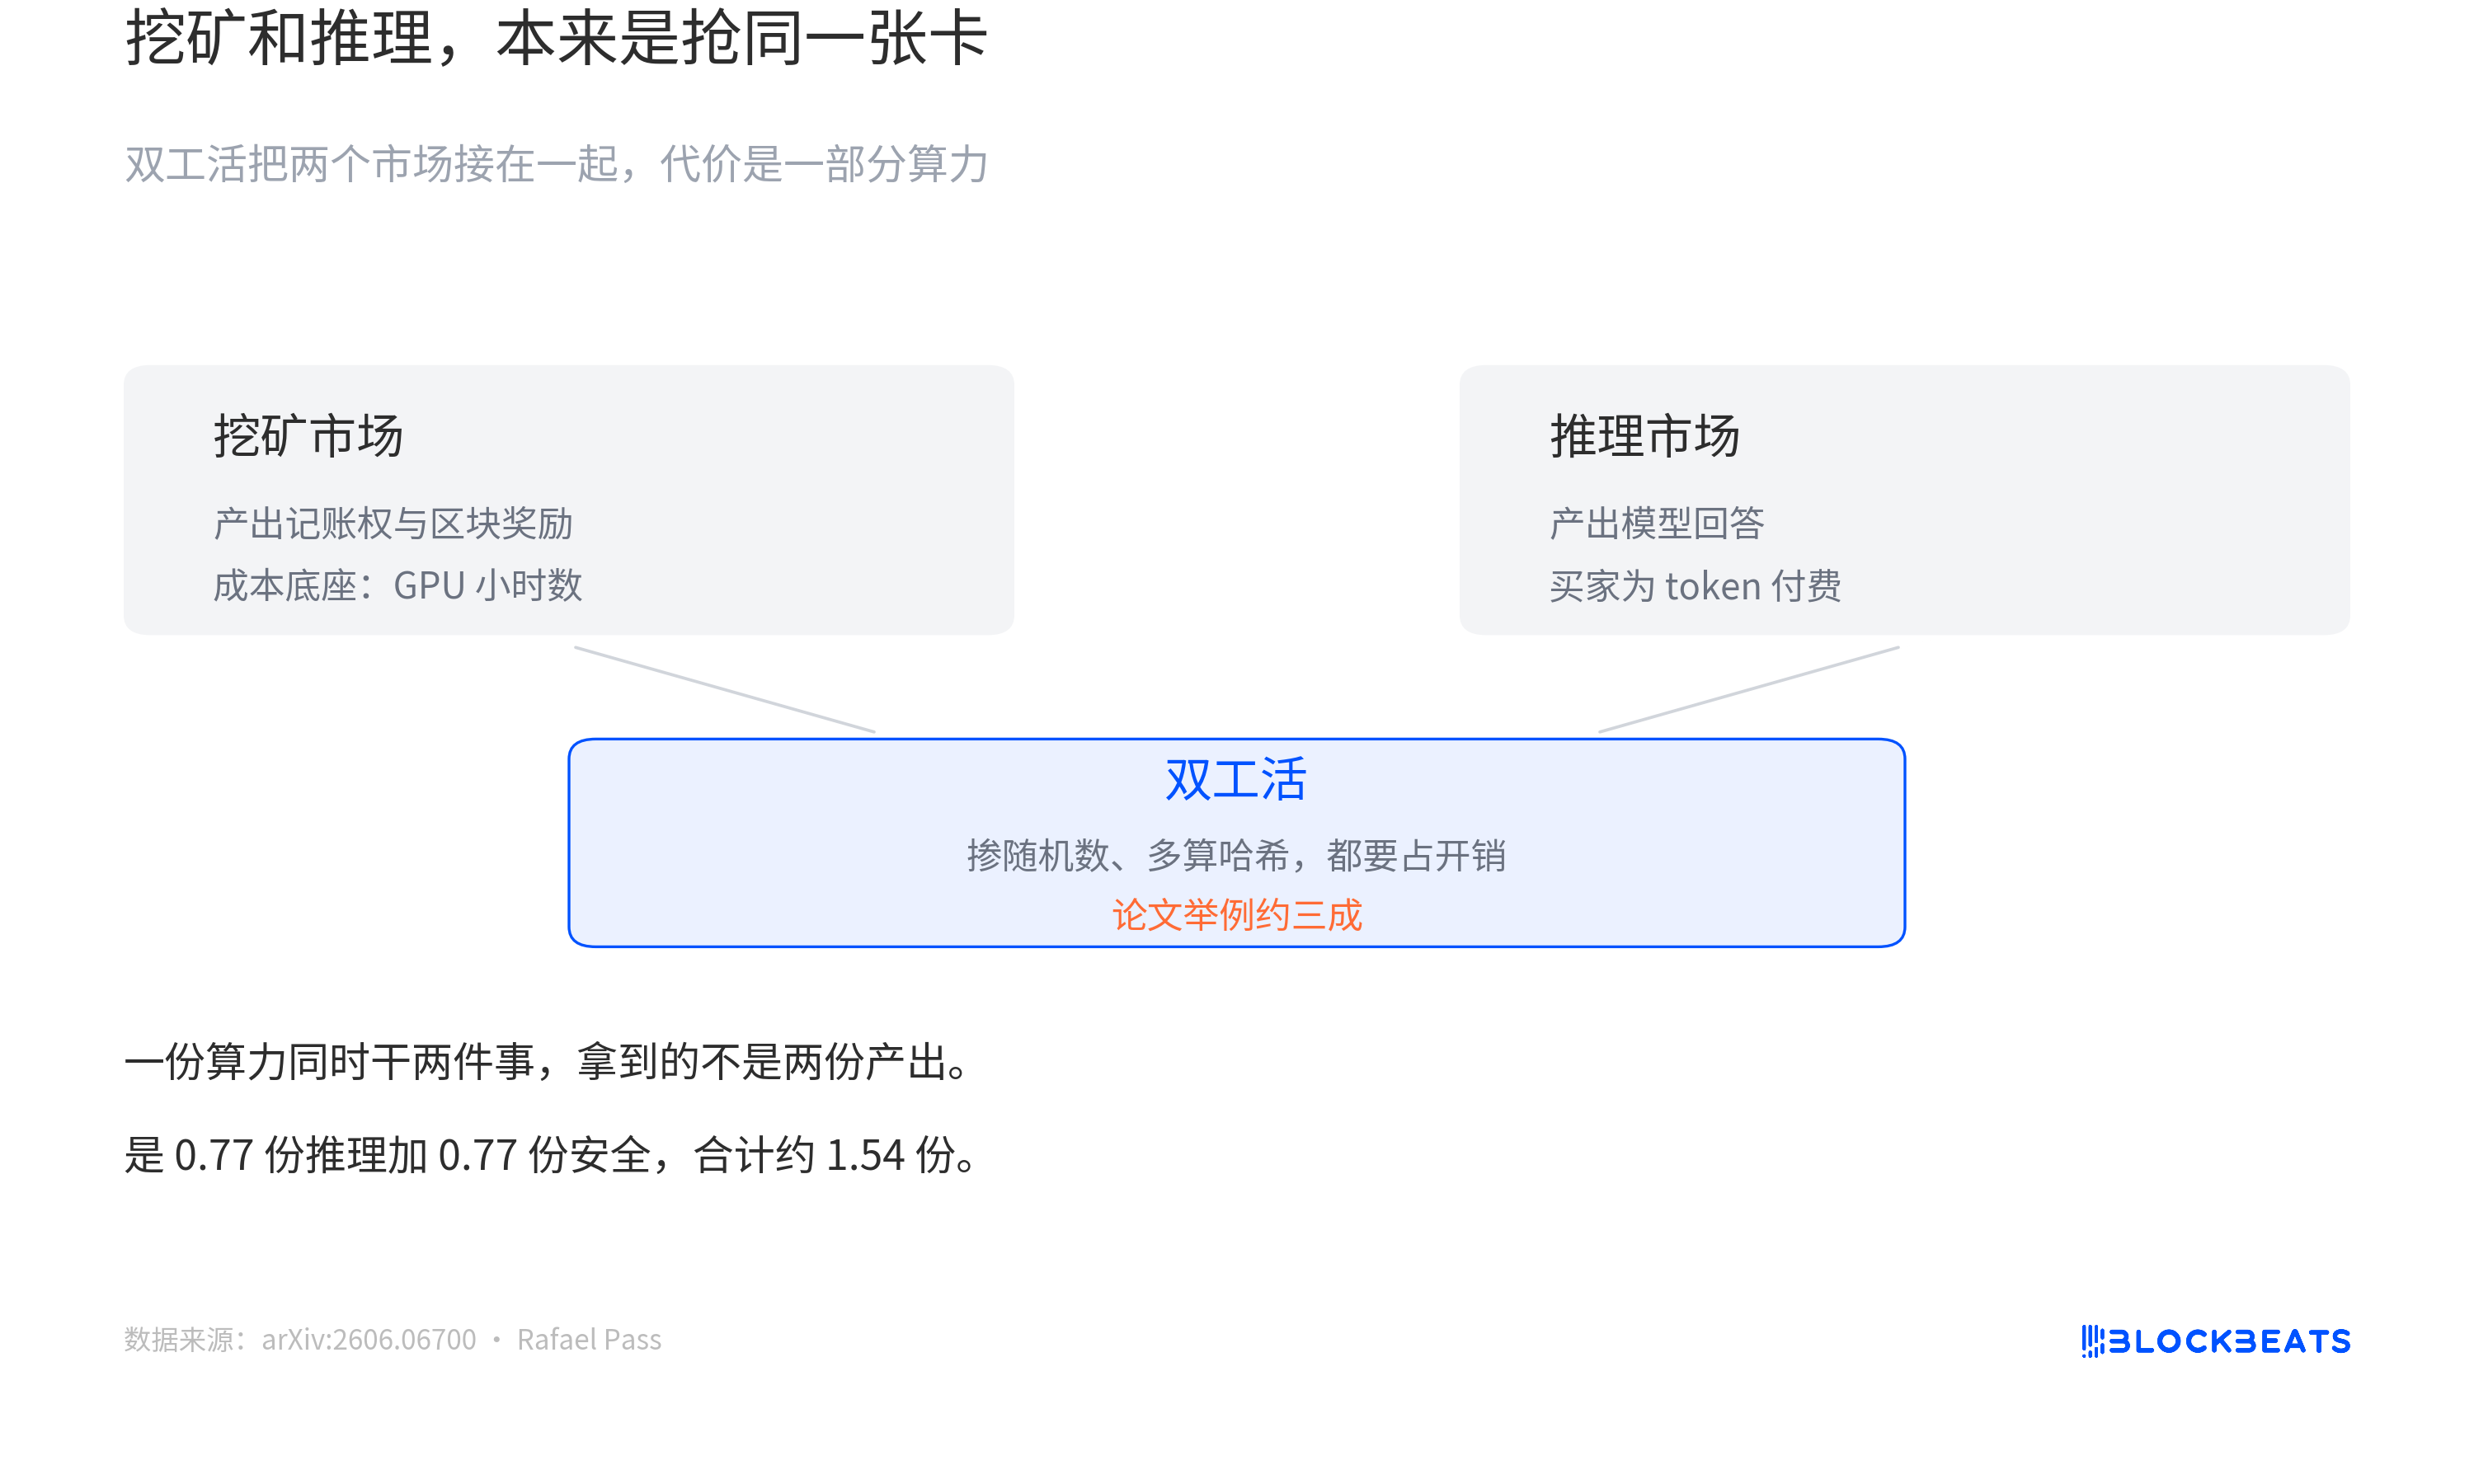
A lógica de funcionamento da Pearl
Para explicar como esse sistema funciona, primeiro precisamos destrinchar o termo multiplicação de matrizes. Ele não foi inventado pela Pearl; é uma operação muito antiga, e quase todas as camadas de uma rede neural a utilizam.
Uma matriz é uma tabela de números organizada em linhas e colunas. Duas tabelas podem ser multiplicadas se o número de colunas da primeira for igual ao número de linhas da segunda. Cada célula da tabela resultante é a soma dos produtos de uma linha da primeira tabela por uma coluna da segunda tabela, multiplicados um a um e depois todos somados. Vejamos o menor exemplo: a primeira linha de A é 1 e 2, a primeira coluna de B é 5 e 7, então o canto superior esquerdo da tabela resultante é 1 vezes 5 mais 2 vezes 7, o que dá 19. As células restantes são preenchidas uma a uma seguindo essa regra.
Em um modelo de IA, o cálculo de uma camada pode ser escrito como "entrada vezes pesos". A frase de um usuário é cortada em vetores, multiplicada pela tabela de pesos daquela camada para obter um resultado, depois passa por uma função não linear e é entregue à próxima camada. Quanto maior o modelo, maiores as tabelas, e o número de multiplicações e adições em uma única passagem pode chegar à casa dos trilhões. As GPUs são construídas para esse tipo de multiplicação e adição organizada, e é também por isso que placas de mineração e placas de IA são o mesmo tipo de chip.
Idealmente, as coisas funcionam assim. Alguém faz uma pergunta a um chatbot online, e a placa de vídeo no servidor começa a executar o modelo, fazendo multiplicação de matrizes camada por camada. Se essa máquina tiver o plugin da Pearl instalado e estiver executando seu modelo de código aberto certificado, então essas multiplicações, enquanto produzem uma resposta, também são usadas para tentar a sorte. Depois que cada pequeno bloco é computado, uma impressão digital é esfregada uma vez. Se a impressão digital for pequena o suficiente, um bilhete de loteria é ganho, e ganhar rende a recompensa do bloco. O usuário não vê diferença, ainda recebe a resposta, e o preço pode até ser um pouco mais barato. O mesmo lote de multiplicações e adições se transforma em tokens de um lado e em moedas do outro.

Para que esse sistema funcione, ele precisa primeiro resolver a trapaça. O minerador tem apenas duas tabelas em mãos, e ele deve primeiro esfregar as tabelas em uma impressão digital e submetê-la. A chamada esfregação de uma impressão digital significa pegar todos os números dessa tabela e calcular um hash em conjunto, comprimindo-o em um segmento muito curto. Somente depois que a cadeia tiver visto essa impressão digital é que ela lhe dirá quais números aleatórios misturar nas tabelas. A ordem está travada, e é tarde demais para ele mudar as tabelas. O termo oficial para essa ação é adicionar ruído. Em termos simples, significa misturar um monte de números aleatórios nas duas tabelas. Quanto é misturado e onde é determinado por essa impressão digital, e o minerador não pode escolhê-lo por conta própria.
Sem a mistura, existe um atalho. Entre A vezes B limpos e o produto após misturar números aleatórios, há apenas uma diferença de três termos de correção. Esses três termos não são pequenos em magnitude, mas são baratos de computar. O minerador já tem A e B limpos em mãos, então ele poderia perfeitamente primeiro computar a resposta limpa, depois adicionar esses termos de correção baratos para produzir a resposta com números aleatórios misturados, sem fazer aquela grande multiplicação de forma alguma. É como uma questão de prova que pede 3987 vezes 2913, mas o aluno já memorizou a resposta e junta alguns números pequenos para parecer que calculou seriamente.
Então o protocolo não exige que o minerador entregue o resultado computado, apenas as linhas de entrada que ele usou, mais uma prova. O verificador pega essa parte, mistura os mesmos números aleatórios, recomputa apenas esse pequeno bloco e verifica se a impressão digital está correta. Recomputar um pequeno bloco é barato e suficiente para confirmar que ele não trapaceou. Se essas tabelas envolverem pesos da empresa ou dados do usuário, uma camada adicional de prova de conhecimento zero pode ser adicionada para provar que o cálculo foi realmente feito, sem revelar quais duas tabelas foram usadas.

Até que passo chegou agora
Vá ao Hugging Face e veja; sob a organização pearl-ai há quatro modelos certificados: Llama 3.3 70B, Llama 3.1 8B, Qwen3 30B e Gemma 4 31B. Oficialmente são chamados de "variantes certificadas"; a abordagem não é retreinar, mas recomprimir o mesmo conjunto de pesos no formato de quantização da Pearl para que possam realizar inferência enquanto mineram dentro do plugin. A perda de precisão é muito pequena; o MMLU do Gemma 4 31B caiu de 90,93 para 90,56. Em 9 de outubro de 2026, os downloads desses quatro modelos nos últimos trinta dias variaram de 195 a 6.424, e suas curtidas foram 0, 3, 5 e 6, respectivamente.
Há também uma saída comercial. Em maio de 2026, a Pearl fez parceria com a Together AI para lançar uma interface que executa o modelo Gemma. De acordo com o anúncio da Together, o preço da chamada é 25% mais barato do que as interfaces comuns, com a diferença compensada pelo valor futuro dos tokens.
Os modelos são publicados, o código é aberto, e depois não há mais nada. Em junho de 2026, o pesquisador Abhinaba Basu, em "The Usefulness Gap in Proof-of-Useful-Work", testou isso. De acordo com o poder de computação da rede na época, de cerca de 24 EH/s, equivalente a cerca de 320.000 placas de nível RTX 3090, consumo de energia estimado em 112 megawatts, e a produção útil de computação de IA foi zero.
O autor amostrou 8.012 unidades de trabalho de mineradores; todo o hardware tinha capacidade de inferência, mas no software principal da máquina de mineração, havia 4.803 strings relacionadas à multiplicação de matrizes e 0 relacionadas a frameworks de aprendizado de máquina. Ele também escreveu um programa de mineração ele mesmo, preenchendo tabelas com números aleatórios, e o executou com sucesso em chips Nvidia, AMD, CPU e Apple, obtendo shares reconhecidos pelo pool de mineração, 44 no total. Uma pessoa fornecer dados e deixar o modelo calcular o resultado, e usar a mesma placa para minerar moedas, pode ser combinado no design, mas na operação real eles são separados.
Então o que está realmente rodando na rede. De acordo com a página do pool de mineração Kryptex, o poder de computação da rede subiu para 46,37 EH/s, dificuldade 2,26 TH, tempo de bloco cerca de 203 segundos, recompensa de bloco 2.271,03 PRL, produção diária cerca de 966.000 moedas, e preço da moeda cerca de US$ 1,30. Em seis meses, o poder de computação quase dobrou, e a grande maioria desse aumento ainda é preenchimento de números aleatórios. O que está sendo feito no mercado agora é principalmente apenas esta coisa: comprar placas, conectá-las, preencher números aleatórios, esperar a liquidação.
Quais problemas existem
Vamos imaginar que a cafeteria afixe um aviso: quem picar cem jin de legumes suficientes pode receber um salário. O ato de picar legumes em si é real; habilidade com a faca, força e tempo todos têm que ser gastos. Mas o aviso só verifica se você picou cem jin suficientes, não quais legumes você picou. Então alguém traz um carrinho de folhas de legumes podres, pica cem jin suficientes e pega o salário. Ele realmente picou legumes, e realmente gastou força, só que a cozinha não pode usar essa pilha de folhas.
A Pearl agora está presa aqui. O protocolo verifica se a impressão digital da tabela corresponde, se o resultado realmente é igual à multiplicação de duas tabelas, se a carga de trabalho é suficiente para a dificuldade; no design formal há também um portão estatístico especificamente para bloquear entradas que podem ser vistas à primeira vista como adulteradas. Ele verifica tudo isso. O que ele não verifica é de onde vieram essas duas tabelas. Então os mineradores podem completamente criar duas tabelas de números aleatórios eles mesmos; a multiplicação é igualmente difícil, a impressão digital atende ao padrão da mesma forma, e eles podem vencer da mesma forma, exceto que ninguém quer usar o resultado computado. O protocolo só reconhece a relação de multiplicação, não a semântica; "útil" aqui é uma questão comercial, não uma garantia criptográfica.
Isso não é suposição. De acordo com o relatório mencionado anteriormente, todas as máquinas amostradas podiam executar modelos, no entanto não havia uma única linha de código de inferência no software da máquina de mineração, e as tabelas que o autor preencheu com números aleatórios ele mesmo também obtiveram shares reconhecidos pelo pool de mineração. Atualmente, o poder de computação da rede está em torno de 45 EH/s, e a grande maioria ainda é preenchimento de números aleatórios.
A lacuna de escala também pode ser vista assim. O artigo deu um contrafactual: se este design realmente operasse como anunciado, então naquela época a rede de 24 EH/s deveria ter produzido cerca de 7,7 milhões de horas de GPU de poder de computação útil de IA por dia. O artigo também mencionou um indicador chamado taxa de destruição de valor; o valor medido da Pearl é 1,0, em pé de igualdade com o Bitcoin, enquanto o da Filecoin é cerca de 0,64.
Os mineradores não aceitam ordens de inferência, não porque não entendem, mas porque fizeram as contas. O artigo estima que acoplar o motor de inferência à mineração perderia cerca de 10% a 30% do poder de computação efetivo. Ou seja, aceitar inferência real não só exige mudar o software e acomodar o ritmo das requisições, mas também perder primeiro essa porção de poder de computação. Em anos em que o preço da moeda não está alto, essa conta é facilmente calculada como negativa.
Então como isso poderia ser resolvido. O artigo listou vários caminhos. Um é gerenciar a origem das tabelas, exigindo que os mineradores usem tabelas submetidas por clientes externos. O plugin e os modelos certificados que a Pearl oficialmente faz agora estão se movendo nessa direção: entregue o modelo e o plugin aos mineradores; você usa o modelo real para executar a inferência, e essa multiplicação convenientemente minera a moeda também. A dificuldade é que é voluntário; se aceitar ou não ainda depende dos mineradores calcularem sua própria conta econômica.
Outro é verificar se as tabelas parecem reais. Os pesos de modelos reais e números aleatórios preenchidos casualmente diferem em características estatísticas. Mas o próprio artigo rejeitou esse caminho: os mineradores só precisam ajustar a distribuição para enganar a verificação, a custo quase zero. Há também vários caminhos mais distantes que ainda não se concretizaram. Tornar a origem do modelo em uma assinatura verificável requer primeiro ter um sistema de chave pública para o lado do modelo. Usar hardware confiável para provar a proveniência dos dados requer confiar adicionalmente nos fabricantes de chips e também tornará as coisas mais lentas. Diferenciar recompensas, dando um pouco mais por usar dados reais, requer primeiro ter um grupo de clientes verdadeiramente dispostos a pagar.
O desenvolvedor da Pearl é o Pearl Research Labs. Omri Weinstein é cofundador e CEO; este título vem do anúncio de parceria com a Together AI. Ele é um pesquisador em teoria da complexidade, ocupa um cargo de professor na Universidade Hebraica e é um dos autores daquele artigo fundamental.
Outro autor, Ilan Komargodski, também está na lista de membros da organização Hugging Face; se sua identidade específica é funcionário ou consultor não pode ser comprovado por fontes públicas. Outro nome que pode ser correspondido é Erez Badash, primeiro autor do artigo Hawkeye sobre reprodução bit a bit em GPU.
Bittensor tem validadores que pontuam as saídas de modelos submetidas pelos mineradores, com a pontuação determinada por um consenso chamado Yuma. io aluga GPUs sob demanda para tarefas de aprendizado de máquina. Pearl aposta em uma suposição mais restrita: a multiplicação usada para a geração de blocos em si pode ser desejada por alguém.
Está apostando que a demanda por inferência crescerá o suficiente para consumir o poder de computação de geração de blocos. Nesse ponto, os próprios mineradores calcularão claramente que aceitar ordens reais é mais econômico do que preencher números aleatórios. Se não conseguir chegar a esse ponto, então é apenas uma cadeia de mineração de placa gráfica com matemática alterada; o que é computado é homólogo à IA e não relacionado às expectativas de qualquer usuário específico.