En bref
- Les meilleurs modèles d'Anthropic et d'OpenAI coûtent 100 fois plus cher par token que leurs plus petits, et pourtant de nombreux utilisateurs choisissent par défaut le modèle phare pour tout.
- Les classements d'utilisation chez Meta, Amazon et Uber ont fait grimper les factures d'IA, et Uber a épuisé son budget d'outils d'IA pour 2026 en environ quatre mois.
- Router les tâches vers le bon modèle, réduire le contexte, mettre en cache et regrouper les requêtes réduisent fortement les coûts, mais il existe d'autres techniques pour économiser de l'argent.
Plus tôt cette année, les employés de Meta ont consommé 60 billions de tokens d'IA en 30 jours, en quête de places sur un classement interne surnommé « Claudeonomics ». Le chroniqueur tech Gergely Orosz a estimé la facture à environ 900 millions de dollars aux prix catalogue d'Anthropic, bien que Meta paie probablement bien moins.
La consultante de Bain & Company Jue Wang observe partout une version plus discrète de ce gaspillage : « Tant d'entreprises, tant d'utilisateurs, choisissent par défaut d'utiliser Opus pour tout, y compris pour générer des e-mails », a-t-elle déclaré à l'Associated Press cet été, en référence aux modèles haut de gamme d'Anthropic. Si vous faites la même chose, vous engagez Albert Einstein pour calculer votre monnaie chez McDonald's.
Chaque mot que vous tapez dans ChatGPT ou Claude, et chaque mot qu'il vous renvoie, est mesuré en tokens, des blocs de texte qui représentent en moyenne environ trois quarts d'un mot. Sur un abonnement à 20 $, ce compteur détermine la vitesse à laquelle vous atteignez votre limite d'utilisation. Sur l'API, l'accès au paiement par token que les développeurs utilisent pour intégrer les modèles dans leurs propres applications, il détermine la facture.
Voici la grille tarifaire actuelle d'Anthropic, par million de tokens :
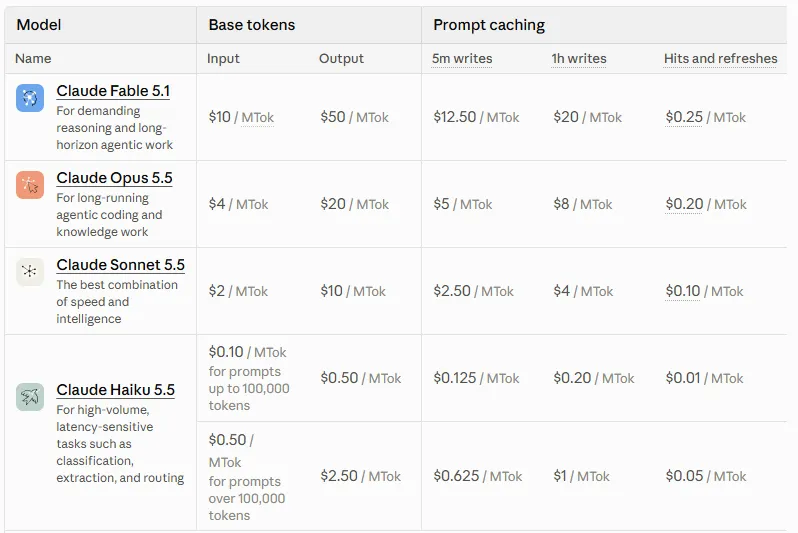
Le tarif de Haiku s'applique aux prompts de moins de 100 000 tokens ; les prompts plus longs coûtent cinq fois plus cher.
Le modèle le plus haut de gamme coûte 100 fois plus que le plus petit, et la propre gamme d'OpenAI présente le même écart, de 10 $ à 0,10 $ par million de tokens d'entrée. Ces prix par token s'accumulent vite pour les laboratoires — et pour vous : le taux de revenus annualisé d'Anthropic est passé d'environ 9 milliards de dollars fin 2025 à plus de 47 milliards de dollars en mai, tandis qu'OpenAI mène une guerre des prix pour suivre le rythme.
Quelques habitudes réduisent fortement ces dépenses, et les cinq premiers conseils ci-dessous ne nécessitent aucune programmation.
Ce que signifie le tokenmaxxing (et ce qu'il devrait signifier)
Le tokenmaxxing a commencé comme une fanfaronnade de la Silicon Valley, à l'image du Claudeonomics de Meta, avec Microsoft, Shopify et Amazon classant leurs employés sur des classements de tokens similaires. Le PDG de Nvidia, Jensen Huang, a jeté de l'huile sur le feu lorsqu'il a déclaré sur le podcast « All-In » en mars qu'il serait « profondément alarmé » si un ingénieur à 500 000 $ ne brûlait pas au moins 250 000 $ de tokens.
Et ils ont brûlé des tokens… pour des choses stupides et improductives.
Chez Amazon, des employés ont admis avoir gonflé leurs chiffres en exécutant l'outil d'IA interne sur des tâches non pertinentes, jusqu'à ce qu'un vice-président principal dise au personnel : « Veuillez ne pas utiliser l'IA juste pour le plaisir d'utiliser l'IA. »
Ce guide utilise le sens que les ingénieurs défendent aujourd'hui : maximiser la valeur de chaque token, et non le nombre que vous dépensez.
Trois concepts expliquent où vont les tokens, en commençant par la boucle de l'agent. Un agent est un modèle qui peut utiliser des outils, il réfléchit donc, recherche sur le web ou exécute du code, lit le résultat et recommence jusqu'à ce qu'il décide que c'est terminé, en renvoyant toute la conversation à chaque tour.
L'orchestration multiplie ce coût : un modèle agit comme un gestionnaire, découpant votre demande en morceaux, les confiant à des modèles travailleurs appelés sous-agents et recousant leurs réponses. Chaque travailleur exécute sa propre boucle avec sa propre mémoire, c'est pourquoi Anthropic affirme que les équipes d'agents dans Claude Code peuvent utiliser environ sept fois plus de tokens qu'une session standard lorsque les coéquipiers fonctionnent en mode plan, un paramètre couvert dans les conseils intermédiaires ci-dessous.
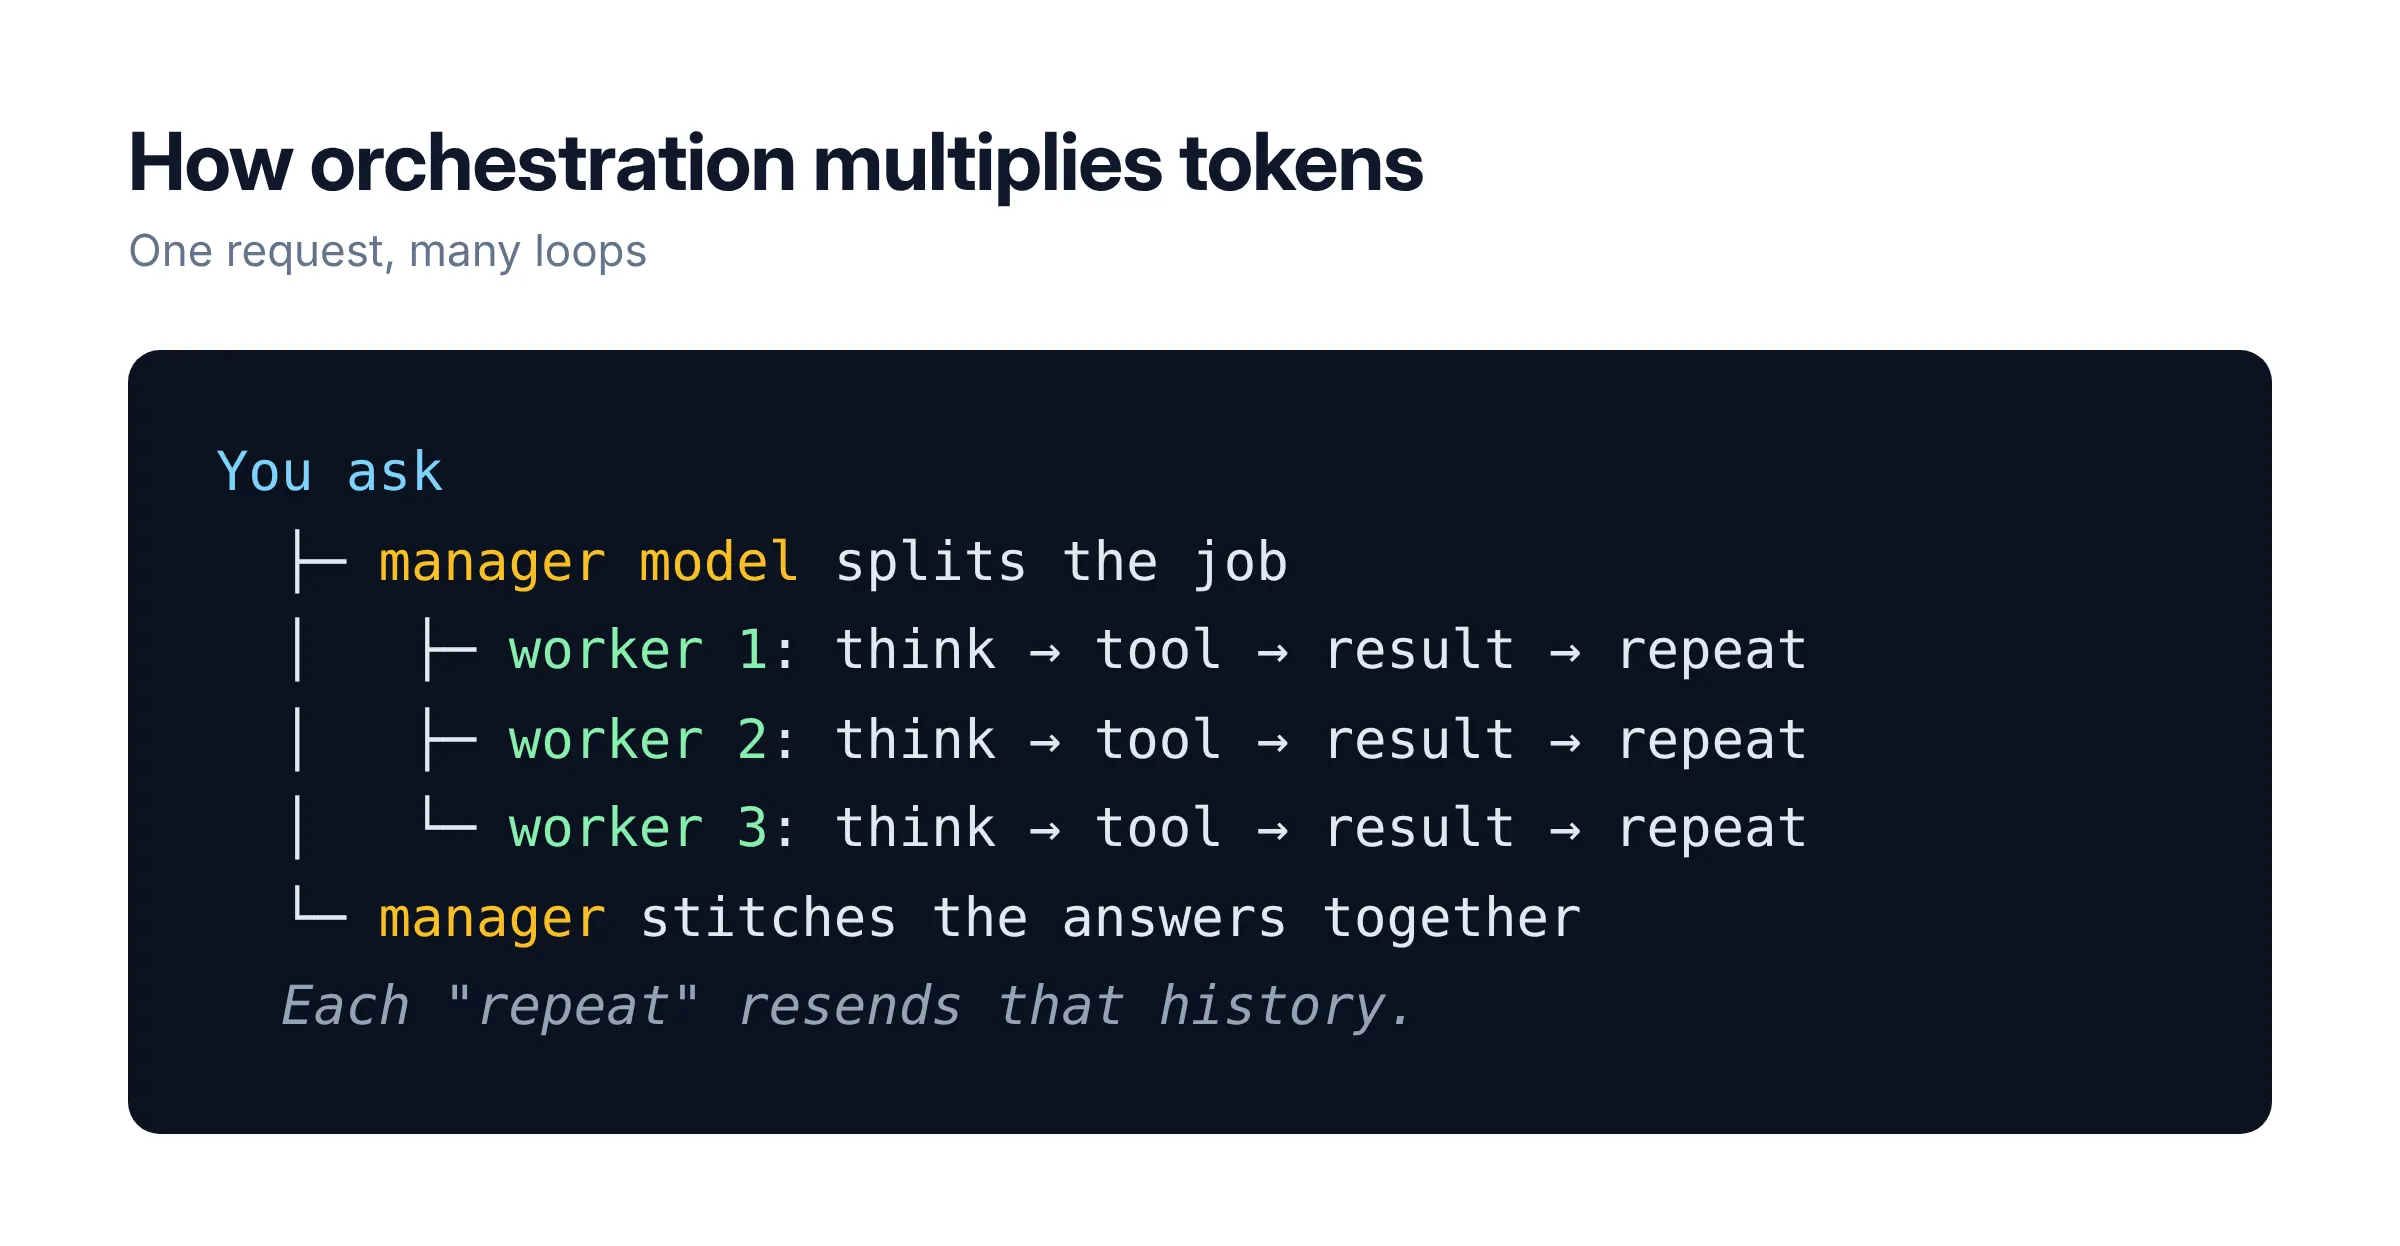
Les graphes sont la façon dont les développeurs empêchent ces boucles de s'égarer. Des frameworks comme LangGraph vous permettent de dessiner un flux de travail comme une carte de métro, avec des stations (nœuds) qui font le travail et des voies (arêtes) qui décident où aller ensuite, afin que le modèle suive un itinéraire fixe au lieu de boucler jusqu'à épuisement des idées ou du budget.
En d'autres termes, les boucles vous aident à automatiser les choses et à augmenter la qualité, mais vous dépenserez aussi beaucoup d'argent, il est donc extrêmement important d'être efficace. Voici quelques conseils qui pourraient vous y aider
Débutant : petites tâches, petits modèles
1. Choisissez le modèle adapté à la tâche
Si vous débutez, vous utilisez probablement une interface graphique pour faire tourner votre IA.
Cliquez sur le nom du modèle dans votre application de chat (en haut du chat dans ChatGPT, à côté du bouton d'envoi dans Claude ou Hermes) et passez à une option plus petite et plus rapide pour les e-mails, les résumés et les reformulations. Gardez le modèle le plus performant pour le raisonnement difficile et les décisions où une erreur subtile coûte de l'argent réel.
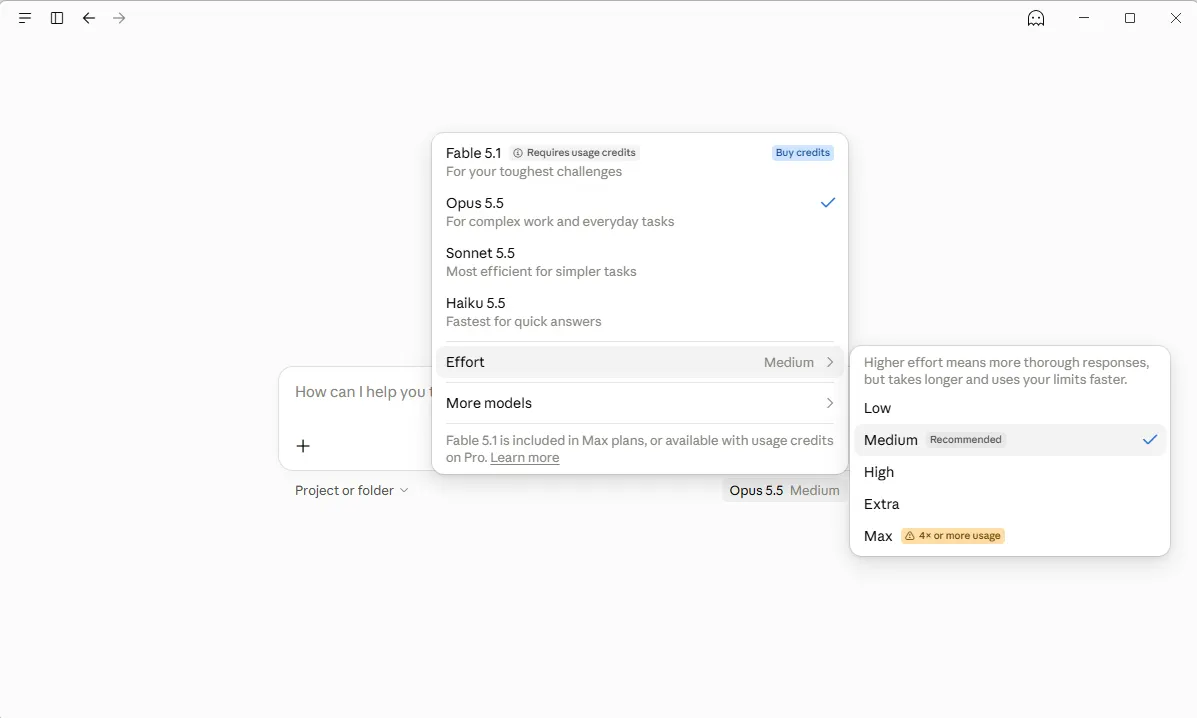
Exécutez cinq des tâches de la semaine dernière sur les deux modèles côte à côte, et si le petit réussit, gardez-le. Sur un abonnement qui étire votre limite d'utilisation, et sur l'API, cela réduit la facture jusqu'à 99 %.
2. Écrivez un bon prompt au lieu de cinq mauvais
Trois séries de « non, juste le total » ou « rends ceci meilleur et plus précis » renvoient tout le chat à chaque fois. Un prompt clair énonce la tâche et la forme exacte de la réponse. Quelque chose comme ceci pourrait fonctionner :
Extrais le numéro de facture, la date, le fournisseur et le total du texte ci-dessous. Conserve chaque valeur exactement telle qu'écrite. Retourne une ligne par champ, et écris « manquant » si un champ est absent.
Les propres tests d'OpenAI ont révélé que des invites plus concises et plus claires obtenaient de meilleurs scores tout en utilisant moins de tokens.
3. Démarrez une nouvelle conversation lorsque vous changez de sujet
Le modèle relit l'intégralité de la conversation chaque fois que vous appuyez sur envoyer, donc un fil de 50 messages sur vos vacances rend votre question fiscale à la fois plus coûteuse et plus stupide.
Anthropic appelle cette dégradation la « pourriture du contexte. »
Donc, pour l'amour de Dieu, démarrez une nouvelle conversation chaque fois que le sujet change.
4. Demandez la taille dont vous avez besoin
Les tokens de sortie coûtent cinq fois plus cher que les tokens d'entrée sur les meilleurs modèles d'Anthropic et d'OpenAI. Terminez vos invites par quelque chose comme « trois puces, moins de 100 mots » ou « uniquement les lignes modifiées », et le modèle aura moins de marge pour remplir.
Si le modèle a une contrainte en termes de longueur de sortie, il économisera des tokens, surtout si la tâche est créative (comme l'écriture ou la recherche) et non déterministe (comme le codage ou la résolution de mathématiques).
5. Essayez gratuitement avant de payer
OpenRouter, un site qui se connecte à des centaines de modèles d'IA via un seul compte, dispose d'un routeur gratuit qui envoie votre requête à l'un des quelque 20 modèles sans frais. Vous pouvez également exécuter des modèles localement avec LM Studio ou Ollama sur une carte graphique dotée de 8 Go de mémoire vidéo ou sur un Mac Apple de la série M.
Les niveaux gratuits peuvent disparaître du jour au lendemain, alors ne construisez rien d'important dessus, et lisez la politique de données avant de coller quoi que ce soit de sensible.
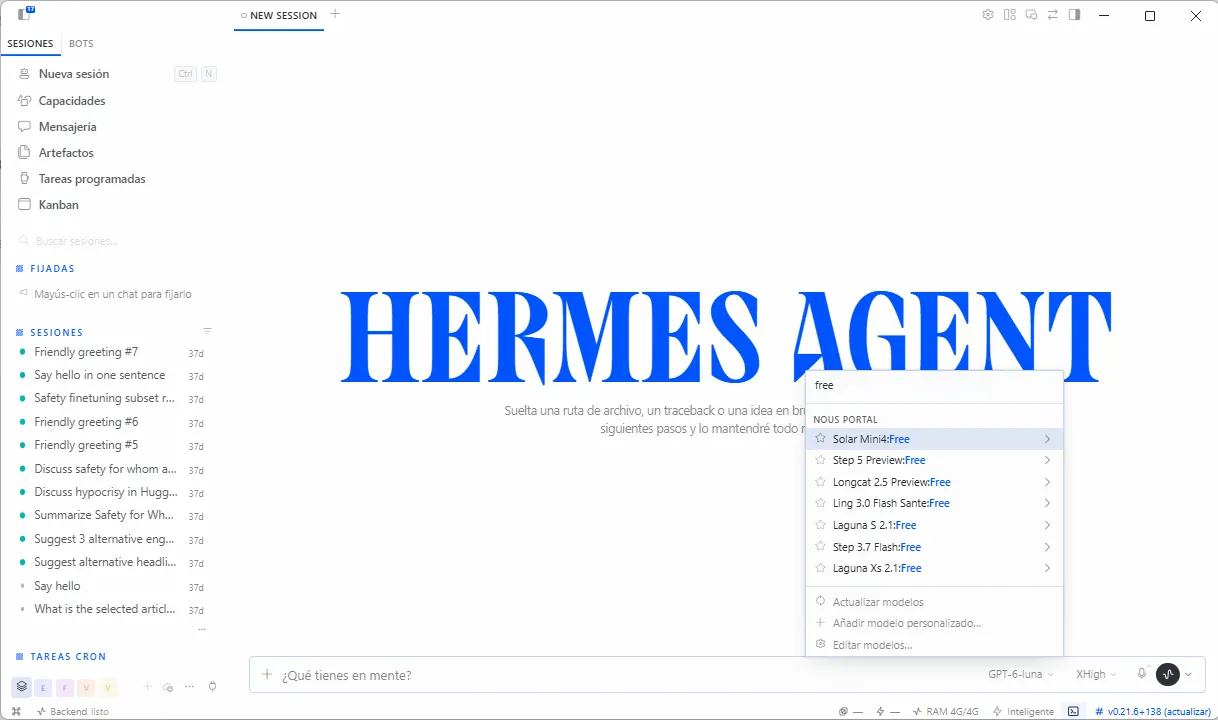
Cela dit, vous pouvez maximiser vos itérations en utilisant des offres gratuites. Hermes propose une bonne sélection de modèles gratuits qui peuvent faire le travail dont vous avez besoin, et Nvidia aussi. Il vaut mieux ajuster une invite avec un modèle gratuit plus stupide que de payer pour un modèle premium qui fera la même chose mais plus rapidement.
Conseils supplémentaires pour débutants
Évitez la réflexion étendue pour les questions simples, ou réduisez le niveau d'effort sur les modèles Claude plus récents où la réflexion ne peut pas être désactivée. Anthropic facture le processus de réflexion complet comme sortie, y compris la partie que vous ne voyez jamais.
Les abonnés Claude Pro et Max qui activent les crédits d'utilisation peuvent définir une limite de dépenses mensuelle dans Paramètres, puis Utilisation.
Intermédiaire : votre agent lit beaucoup trop
À partir de maintenant, les exemples utilisent Claude Code, l'agent d'Anthropic qui s'exécute dans votre terminal et modifie des fichiers pour vous ; les commandes vont directement dans sa zone de chat. D'autres environnements auront une logique similaire.
Si vous n'utilisez que les applications de chat, l'astuce 8 fonctionne aussi dans n'importe quelle fenêtre de chat.
6. Commencez par le moins cher, augmentez en cas d'échec
Tapez /model pour changer de modèle, gardez Sonnet comme modèle par défaut, et passez à Opus uniquement lorsque Sonnet échoue sur quelque chose de précis, comme un bug qu'il ne parvient pas à corriger après deux tentatives. Pour les tâches simples de sous-agents, la documentation d'Anthropic suggère de définir model: haiku dans les paramètres du sous-agent.
7. Nettoyez entre les tâches
Tapez /clear lorsque vous passez à une tâche sans rapport, ce qui ne coûte rien et abandonne l'ancien historique. Utilisez /compact avec une note sur ce qu'il faut conserver, comme /compact garde les décisions sur la base de données, uniquement lorsque vous avez besoin de l'historique, car la compaction est elle-même une requête volumineuse.
8. Laissez le code faire les calculs ennuyeux
Coller une feuille de calcul de 5 000 lignes dans un chat oblige le modèle à lire chaque ligne, et il peut encore se tromper dans le décompte, car un modèle de langage n'est pas une calculatrice, peu importe combien vous payez pour lui.
Demandez-lui plutôt une formule ou un court script, exécutez-le vous-même, et ne transmettez au modèle que le résultat.
9. Allégez vos outils
Les serveurs MCP sont des plugins qui connectent un modèle à des applications comme GitHub ou Google Drive, et chacun ajoute des noms d'outils et des instructions à chaque session.
Tapez /context pour voir ce qui consomme de l'espace et /mcp pour désactiver les serveurs que le projet n'utilise pas.
Conseils intermédiaires supplémentaires
Tapez /usage pour voir où vos tokens sont passés. Gardez votre CLAUDE.md (ou Soul.md), le fichier d'instructions que votre agent lit au début de chaque session, sous 200 lignes.
Pour des modifications plus importantes, appuyez sur Shift+Tab pour passer en mode plan, où l'agent propose un plan à votre approbation avant de toucher aux fichiers, et appuyez sur Esc dès qu'il part dans la mauvaise direction. Utilisez /effort pour réduire le raisonnement pour des tâches simples comme renommer une variable.
Anthropic a montré que l'utilisation de tokens par un agent passait de 150 000 tokens à 2 000 lorsqu'il ne chargeait que les définitions d'outils dont il avait besoin, de sorte que les outils en ligne de commande comme gh de GitHub, qui ne coûtent rien tant qu'ils ne s'exécutent pas, surpassent souvent un plugin toujours actif.
Avancé : intégrez les garde-fous dans le système
Prenez un développeur qui doit traiter 1 000 factures de 2 000 tokens chacune, avec des réponses de 200 tokens : la tâche coûte environ 30 $ sur Fable 5.1 et environ 0,30 $ sur Haiku 5.5, avant même l'une des astuces ci-dessous.
10. Mettez en cache les parties qui ne changent jamais
Placez les instructions stables en premier et les parties changeantes en dernier, et marquez le bloc stable pour la mise en cache. Dans l'API d'Anthropic, cela correspond à un champ supplémentaire :
"system": [{
"type": "text",
"text": "Vos instructions de facturation...",
"cache_control": {"type": "ephemeral"}
}]
La lecture depuis le cache coûte une fraction du prix d'entrée normal, tandis que l'écriture dans le cache par défaut de cinq minutes coûte un supplément. Vérifiez le champ cache_read_input_tokens dans chaque réponse ; s'il indique toujours zéro après le premier appel, le cache ne fonctionne pas.
11. Regroupez en lots tout ce qui peut attendre
OpenAI et Anthropic traitent tous deux les tâches par lots avec une réduction de 50 %, OpenAI promettant des résultats sous 24 heures. Téléversez les 1 000 factures sous forme d'un seul fichier de lot au lieu d'effectuer 1 000 appels en direct, et la facture chute fortement.
12. Mettez les agents en laisse
Fixez un nombre maximal d'étapes et un plafond en dollars pour chaque exécution d'agent, et définissez à quoi ressemble « terminé » avant qu'il ne commence. Claude Code accepte un indicateur --max-budget-usd pour les exécutions scriptées, et Shopify utilise des disjoncteurs qui peuvent couper immédiatement l'accès d'un développeur si ses dépenses explosent en une journée, conçus pour intercepter les agents emballés.
Aujourd'hui, la chose normale à faire est de réellement libérer ces agents et de les faire boucler jusqu'à ce que le résultat soit jugé parfait. Si vous n'avez pas les moyens, ne laissez pas simplement vos agents décider de ce qui est ou n'est pas « parfait ».
Conseils avancés supplémentaires
Placez les faits critiques au début ou à la fin d'un long prompt. Une étude menée par Stanford a constaté que les modèles utilisent le mieux les informations à ces positions et le moins bien lorsqu'elles sont enfouies au milieu.
Payez un second modèle pour vérifier le travail uniquement lorsqu'une erreur coûte cher, comme une clause contractuelle ou un montant de paiement. Sur l'API d'OpenAI, activez une limite de dépenses stricte pour chaque projet, car ses alertes de dépenses ne font que vous notifier et n'arrêtent pas le trafic.
Commencez par un test
Faites du modèle le moins cher qui réussit votre test de cinq tâches de l'astuce 1 votre modèle par défaut pendant une semaine, et ne changez que lorsqu'il échoue. Comparez ensuite votre page d'utilisation avec celle de la semaine précédente ; sur le travail de facturation, le routage seul a réduit la facture de 30 $ à 3,90 $, même après avoir payé Opus 5.5 pour refaire 300 échecs.
Des jetons moins chers ne suffiront pas à eux seuls, cependant : le prix d'un seul jeton a chuté de plus de 90 % depuis 2023, selon l'indice des dépenses en jetons de Silicon Data, et pourtant les dépenses consacrées aux grands modèles de langage ont doublé depuis la fin de 2025.
Les économistes appellent cela le paradoxe de Jevons, lorsque une ressource devient si bon marché que les gens finissent par y consacrer davantage au total. Une note de Bain & Co. de juin a constaté le même schéma, avec des coûts par jeton divisés par deux entre décembre 2024 et 2025 tandis que le nombre de jetons consommés augmentait de 450 %.
Le bon côté, c'est que la même baisse des prix joue en votre faveur dès que vous cessez de brûler des jetons pour le plaisir : associez-les aux habitudes ci-dessus, et l'IA devient moins chère et meilleure en même temps.