Les Agents actuels savent déjà appeler des outils, modifier des fichiers et exécuter des tests avec proficiency, mais face à un grand système logiciel qui a évolué sur le long terme, peuvent-ils partir d'une nouvelle exigence et livrer une fonctionnalité complète ?
Lorsqu'un chef de produit propose une nouvelle exigence, ce que les développeurs reçoivent n'est souvent pas une liste de fichiers ou des signatures de fonctions. Ils doivent d'abord comprendre les contraintes, tracer les dépendances entre modules, puis déterminer où modifier, comment modifier et comment prouver que les modifications sont correctes. Ces analyses influencent la livraison ultérieure.
L'Université Fudan, la City University of Hong Kong, The Chinese University of Hong Kong et d'autres institutions proposent LoLBench, qui place les Agents dans des systèmes logiciels totalisant en moyenne environ 2,4 millions de lignes de code source, évalue le processus complet de la proposition de fonctionnalité à la livraison du module, et teste la capacité de perception à ancrer les exigences dans le système, ainsi que la capacité de mise en œuvre à réaliser des modifications inter-modules.
Lien de l'article : https://arxiv.org/abs/2609.37143
Jeu de données : https://huggingface.co/datasets/lolbench26/LoLBench
Les expériences révèlent un point de rupture clé : un Agent peut effectuer une modification locale correcte mais manquer des modifications dans d'autres modules qui doivent être synchronisées. Même avec des indications de mise en œuvre supplémentaires, la plupart des tâches restent non résolues, et il reste encore une longue distance entre la compréhension des exigences et l'achèvement de la livraison.
Redéfinir les tâches de code à long horizon
Quel type de tâche de code à long horizon a une valeur d'ingénierie réelle ?
« Long horizon » ne peut pas être jugé uniquement par le temps consommé, le nombre de tours ou la consommation de Tokens. Par exemple, demander à un Agent de produire un nombre par minute, en comptant de 1 à 1000, prend beaucoup de temps mais ne nécessite qu'une simple boucle. Les tâches de correction de bugs locaux de style SWE-bench ne peuvent pas non plus couvrir le défi de l'analyse des exigences à la livraison du module.
Les tâches de code à long horizon sur lesquelles LoLBench se concentre sont le développement de modules pour des systèmes complexes. Après avoir reçu une nouvelle exigence, les développeurs analysent de manière répétée : quels comportements doivent être mis en œuvre ? L'architecture existante peut-elle les supporter ? Quelles dépendances seront affectées ? Comment vérifier ? LoLBench intègre également cette analyse cachée dans l'esprit des développeurs dans l'évaluation, laissant l'Agent dériver lui-même le plan de mise en œuvre à partir de l'intention de l'utilisateur.
De telles tâches présentent simultanément une complexité de perception et une complexité de mise en œuvre : la première est la difficulté de comprendre la proposition, d'identifier les contraintes implicites et les dépendances inter-modules, et de dériver la portée des modifications et la spécification de mise en œuvre ; la seconde est la difficulté de convertir la spécification en modifications correctes entre fichiers et, par des tests et des réparations, d'empêcher la rupture des fonctionnalités existantes.
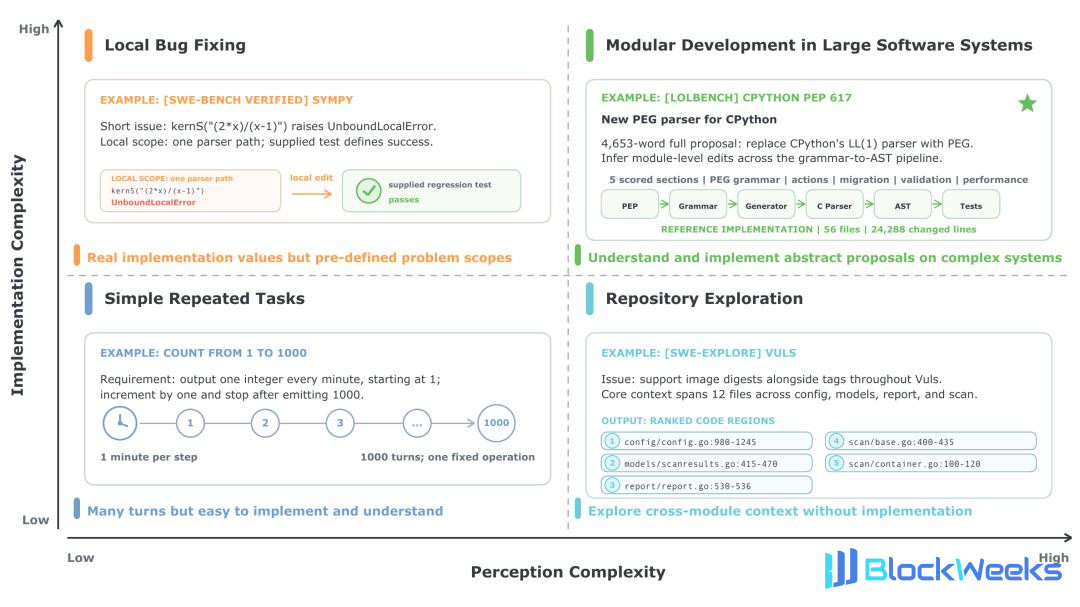
Figure 1 Comparaison de la complexité de perception et de la complexité de mise en œuvre.
Comment LoLBench évalue simultanément les deux types de complexité
Dériver les spécifications de mise en œuvre à partir des propositions de fonctionnalités
LoLBench sélectionne 100 tâches parmi les propositions d'amélioration de la communauté et leurs PR fusionnées correspondantes, couvrant 29 systèmes, 8 langages et 5 domaines.
L'Agent ne reçoit que la proposition et le dépôt de code avant la mise en œuvre ; la proposition fait en moyenne environ 5 000 mots anglais. L'évaluation est effectuée dans un environnement Docker hors ligne pour empêcher l'Agent de récupérer les implémentations en amont.
Par exemple, la PEP 617 [1] propose de remplacer le parseur LL(1) de CPython par PEG, et l'implémentation nécessite de relier les définitions de grammaire, la génération de parseurs, les arbres de syntaxe abstraite et le signalement d'erreurs. L'Agent doit identifier toute la chaîne d'implémentation.
En termes de complexité de perception, le taux de mention moyen dans la proposition des noms de classes cibles dans l'implémentation de référence de LoLBench n'est que de 7,3 %, soit moins de la moitié de SWE-bench Verified (15,9 %) et moins d'un cinquième de FeatureBench (38,7 %). L'Agent doit déduire lui-même le lien entre les exigences et le code.
Transformer les spécifications en livraison d'ingénierie
En termes de complexité d'implémentation, les dépôts LoLBench comptent en moyenne environ 2,4 millions de lignes de code source, soit environ 9,4 fois celles de SWE-bench Verified et 4,9 fois celles de FeatureBench ; les implémentations modifient en moyenne 5 499 lignes, contre 38 lignes et 2 050 lignes pour ces deux derniers. Chaque tâche modifie en moyenne 64,9 fichiers, 40,1 classes et 195,9 fonctions ; le nombre de fichiers est respectivement 25 fois et 4,2 fois celui des deux autres. La coordination et la vérification inter-modules sont plus difficiles.

Tableau 1 Comparaison de LoLBench avec les ensembles d'évaluation de tâches de code existants.
LoLBench vérifie la justesse de la livraison au moyen de deux types de tests : les tests de nouvelles fonctionnalités (F2P) exigent un échec avant l'implémentation et une réussite après l'implémentation ; F2P vérifie le comportement via des interfaces publiques et autorise différentes implémentations internes. Les tests de régression (P2P) exigent une réussite avant et après.
En plus des tests originaux du projet, l'équipe de recherche construit des implémentations erronées telles que des fonctionnalités manquantes et des exigences altérées en tant que mutants, complète les cas de test pour identifier les erreurs manquées et améliore la couverture de test des correctifs de référence.
Après amélioration, le taux de détection de 1 688 mutants passe d'environ 61 % à 96 %, et la couverture de lignes moyenne par tâche de F2P passe d'environ 60 % à 79 %.
Performance et goulots d'étranglement de 28 combinaisons d'Agents
En changeant de modèle ou de squelette, le taux de résolution le plus élevé d'un Agent n'est que de 14 %
L'équipe de recherche évalue 28 combinaisons disponibles de 6 modèles de pointe et 5 squelettes, avec une limite de temps de 6 heures par tâche. Opus 5 associé à Claude Code ou à mini-SWE-agent obtient à égalité le taux de résolution le plus élevé, à 14 %, et la médiane sur l'ensemble des combinaisons n'est que de 2 %.

Tableau 2 Principaux résultats expérimentaux de l'article
En utilisant également Opus 5, mini-SWE-agent et Claude Code ont atteint le même taux de résolution, mais le premier a pris 3,2 fois plus de temps que le second et a généré 5 fois plus de tokens ; une consommation plus élevée n'a pas apporté un taux de résolution plus élevé.
Une grande quantité d'interactions et de tokens est consacrée à la localisation du code
En termes de consommation de tokens, en moyenne sur les agents, l'étape de localisation représentait 52,4 % des tokens d'entrée non mis en cache et 45,4 % des tokens générés. En termes de nombre de tours d'interaction de l'agent, l'étape de localisation présentait également nettement plus de tours d'interaction que les autres étapes.

Figure 2 Nombre moyen de tours d'interaction à chaque étape.
Pour les fichiers et fonctions existants modifiés par rapport à l'implémentation de référence, sur l'ensemble des 28 groupes d'agents, la précision de modification des fichiers variait de 38,0 % à 80,4 %, et le rappel de 30,3 % à 65,0 % ; la précision de modification des fonctions variait de 54,2 % à 65,6 %, et le rappel de 20,8 % à 53,4 %. La précision de localisation du code est faible, et la couverture reste incomplète.
Même après avoir complété les indications de modification, les agents peinent encore à livrer complètement
L'équipe de recherche a conservé la proposition de fonctionnalité d'origine et a en outre fourni une arborescence des fichiers de modification exportée depuis l'implémentation de référence ainsi que des spécifications d'implémentation d'API pour aider les agents à déterminer l'étendue des modifications. Le taux de résolution d'Opus 5+Claude Code est passé de 14 % à 34 %, GPT-5.6 Sol+Codex de 3 % à 25 %,
DeepSeek
V4 Flash+OpenCode de 1 % à 17 %.

Tableau 3 Résultats expérimentaux après ajout de l'arborescence des fichiers de modification et des spécifications d'implémentation d'API
L'ajout d'indications de modification peut alléger la charge de perception, mais la meilleure combinaison présentait encore 66 % de tâches non résolues. Les agents doivent encore coordonner les modules, implémenter les interfaces et passer la validation, ce qui suggère que la complexité d'implémentation des grands systèmes est également très élevée.
De la génération de code vers l'évolution des grands systèmes logiciels
Ces résultats fournissent des directions testables pour la recherche et le développement d'agents : si la recherche dans le dépôt peut couvrir les dépendances clés, si les spécifications d'implémentation avant le codage sont complètes, et si la validation peut détecter rapidement les omissions inter-modules.
La valeur du génie logiciel réside dans la capacité à satisfaire de manière fiable les exigences des utilisateurs. Les agents doivent comprendre pourquoi les changements surviennent, comment ils affectent le système, et mettre pleinement en œuvre les changements. LoLBench espère promouvoir l'évaluation des capacités des agents, de la génération de code vers le soutien de l'évolution continue des logiciels, en faisant des résultats de livraison le critère pour tester les capacités des agents.
Référence : PEP 617 : https://peps.python.org/pep-0617/
Cet article provient du compte public WeChat « Xinzhiyuan », auteur : Xinzhiyuan ; éditeur : LRST