Camaradas, Anthropic vuelve a bajar los precios. Esta vez le toca al modelo más barato de la familia Claude, Haiku.
El 7 de octubre, Anthropic lanzó oficialmente Claude Haiku 5.5, afirmando que es su modelo pequeño más rápido, más capaz y de menor precio hasta la fecha.
Lo más escandaloso es el precio, tan bajo como $0.1 por millón de tokens de entrada, una reducción directa del 90% en comparación con la generación anterior.
El rendimiento tampoco se ha quedado atrás. Según los resultados de las pruebas publicados por Anthropic, Haiku 5.5 supera a GPT-6 Luna de OpenAI en múltiples benchmarks, incluyendo operación de computadoras, trabajo de conocimiento y programación de Agentes, con algunas puntuaciones que incluso muestran una brecha considerable.
Además, Haiku 5.5 también introduce intensidad de razonamiento ajustable, soportando una ventana de contexto de 1 millón de tokens y una salida de hasta 128,000 tokens.
En este punto, Anthropic ha completado la actualización de toda la familia Claude 5.5 en solo 15 días: Opus 5.5 llegó el 22 de septiembre, Sonnet 5.5 se lanzó el 28 de septiembre, y ahora Haiku 5.5 se ha unido oficialmente.
Esta vez, Anthropic se ha centrado en aquellas tareas de IA con volúmenes de llamadas masivos y extrema sensibilidad al precio.
Múltiples puntuaciones superan a GPT-6 Luna, tasa de éxito en operación de computadoras del 72.4%
Según las puntuaciones de Benchmark publicadas por Anthropic, Haiku 5.5 ha logrado mejoras significativas sobre la generación anterior, y en algunas pruebas incluso ha alcanzado mejores resultados que GPT-6 Luna.
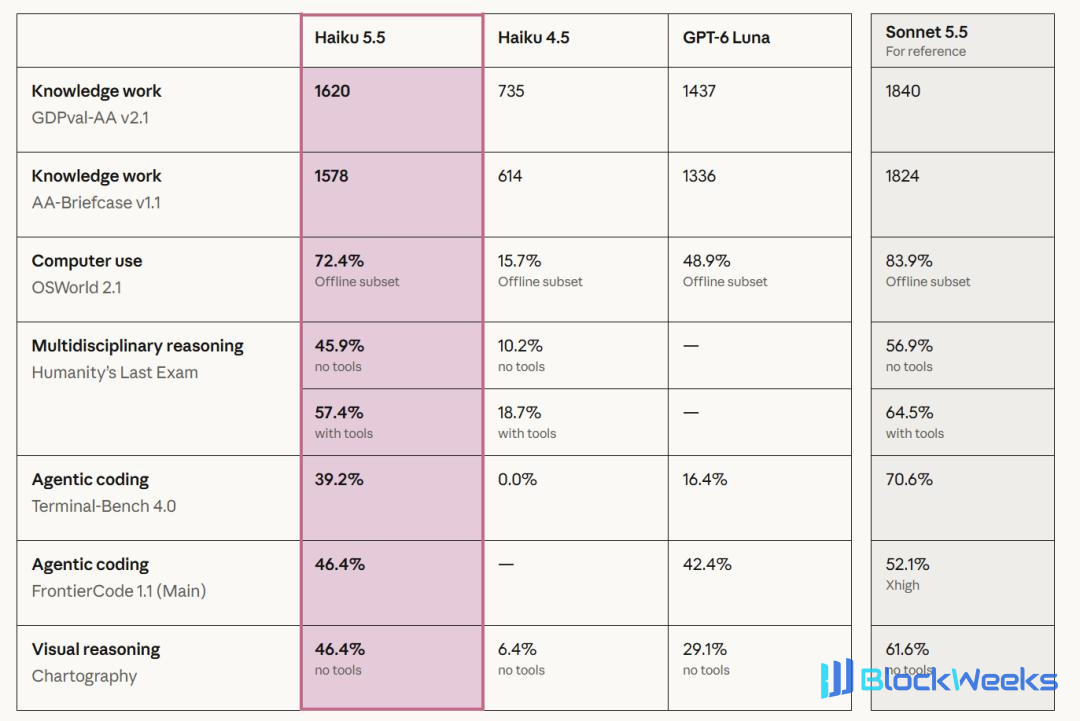
El resultado más notable proviene de OSWorld. Esta es una prueba que mide la capacidad de un Agente de IA para operar una computadora real, requiriendo que el modelo complete tareas de operación multi-paso y entre aplicaciones.
En el subconjunto de tareas offline de OSWorld 2.1, Haiku 5.5 logró una tasa de éxito del 72.4%, mientras que la generación anterior Haiku 4.5 solo tenía 15.7%, y GPT-6 Luna tenía 48.9%.
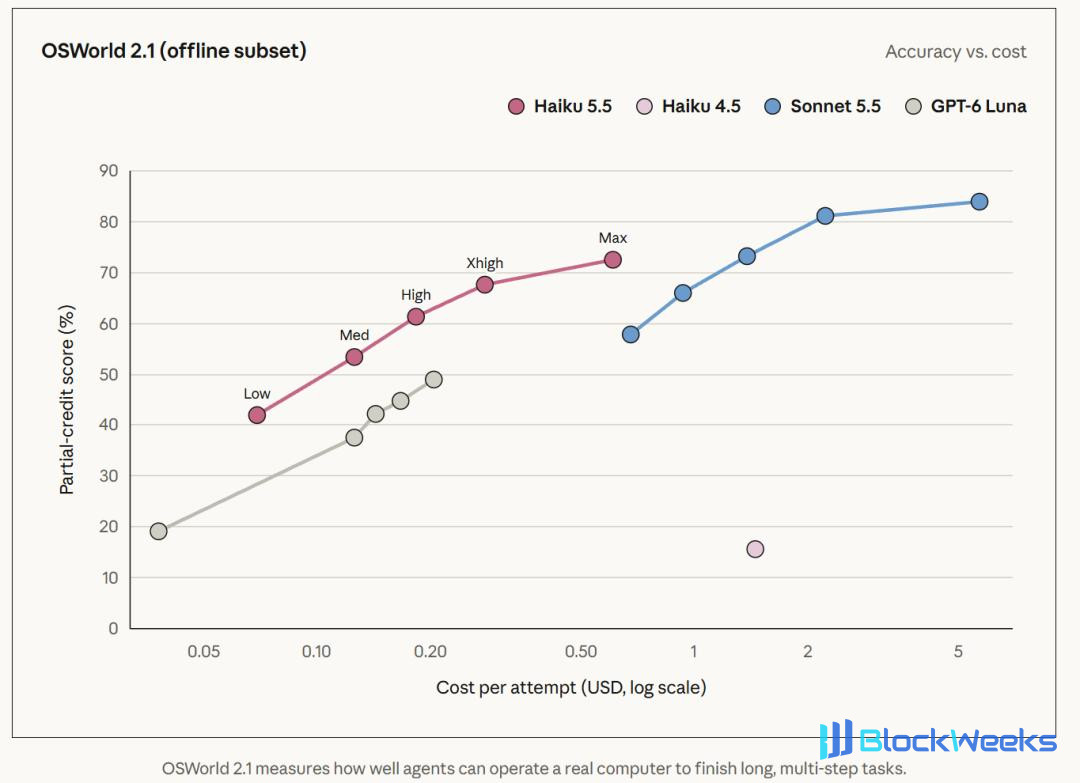
En términos de trabajo de conocimiento, Haiku 5.5 obtuvo 1620 en GDPval-AA v2.1, superando los 1437 de GPT-6 Luna. En la prueba de programación de Agentes Terminal-Bench 4.0, ambos obtuvieron 39.2% y 16.4% respectivamente.
Sin embargo, hay un detalle importante en estos datos. Las puntuaciones más altas de Benchmark de Haiku 5.5 a menudo requieren más cómputo de razonamiento.
Haiku 5.5 introduce por primera vez en la serie Haiku la intensidad de razonamiento ajustable, permitiendo a los desarrolladores controlar cuántos recursos computacionales invierte el modelo a través del parámetro effort.
El medio VentureBeat notó que en la prueba Terminal-Bench publicada por Anthropic, la puntuación del 39.2% corresponde a la máxima intensidad de razonamiento. Después de cambiar a intensidad de razonamiento media, la puntuación cae a alrededor del 20%, y la intensidad media es exactamente la configuración predeterminada para Haiku 5.5.
La agencia de evaluación externa Artificial Analysis también observó un fenómeno similar. En su evaluación del Índice de Inteligencia, Haiku 5.5 obtuvo 43 puntos con máxima intensidad de razonamiento y 34 puntos con intensidad de razonamiento media. Bajo la misma evaluación, el costo promedio por tarea fue de aproximadamente $0.21 y $0.05 respectivamente.
En otras palabras, el modelo puede intercambiar un mayor presupuesto de razonamiento por un mejor rendimiento en la tarea, pero el costo real también puede aumentar significativamente.
En su propia prueba Terminal-Bench 4.0, Artificial Analysis midió puntuaciones del 33% con máxima intensidad de razonamiento y del 15% con intensidad media. Debido a diferentes configuraciones de evaluación, estas cifras difieren de los resultados oficiales de Anthropic.
Esto también explica por qué, al analizar el rendimiento de modelos pequeños, se debe considerar simultáneamente la intensidad de razonamiento, la tasa de finalización de tareas y el costo real.
En tareas de programación de Agentes más complejas, Sonnet 5.5 todavía tiene una ventaja clara: su puntuación en Terminal-Bench 4.0 alcanza el 70.6%.
Anthropic también declaró claramente que Sonnet y Opus siguen siendo más adecuados para tareas complejas de programación de Agentes, mientras que las ventajas de Haiku se concentran en trabajos de alta frecuencia y alcance claramente definido.
Precio reducido directamente a una décima parte, compitiendo cara a cara con GPT-6 Luna
Si las mejoras de rendimiento hacen competitivo a Haiku 5.5, entonces el precio puede ser el aspecto más destacado de este lanzamiento. Anthropic diseñó dos niveles de precios de API para el nuevo modelo.

Para solicitudes con una longitud de prompt que no supere los 100,000 tokens, los precios unitarios de entrada y salida de Haiku 5.5 son ambos un 90% más bajos que los de la generación anterior. Por encima de este umbral, el precio sigue siendo un 50% más bajo que el de Haiku 4.5.
Anthropic declaró que aproximadamente el 90% de las solicitudes a la generación anterior de Haiku estaban dentro de los 100,000 tokens. Combinando diferentes longitudes de solicitud y cambios en el consumo de tokens, la compañía estima que Haiku 5.5 completa el costo promedio de tareas similares disminuye alrededor del 75%.
También hay un detalle que se pasa por alto fácilmente aquí — Haiku 5.5 cambió a un nuevo Tokenizer. Según la documentación oficial para desarrolladores, el mismo fragmento de texto puede generar aproximadamente un 30% más de tokens en el nuevo modelo que en Haiku 4.5, con el aumento específico dependiendo del contenido. Por lo tanto, una caída del 90% en el precio unitario de la API no significa que la factura de cada tarea pueda reducirse en un 90%.
Otro rival que vale la pena observar es GPT-6 Luna. El precio base de OpenAI para Luna también es de $0.1 por millón de tokens de entrada y $0.5 por salida, y el precio de lectura de caché también es consistente con el nivel de precio bajo de Haiku 5.5.
Sin embargo, existe una diferencia clara entre los umbrales de facturación de contexto largo de ambas compañías.
Haiku 5.5 entra en un nivel de precio más alto después de que los prompts superan los 100,000 tokens; GPT-6 Luna solo activa recargos por contexto largo después de que la entrada supera los 272,000 tokens. Esto significa que para solicitudes entre 100,000 y 272,000 tokens, Luna tiene una ventaja en el precio unitario por token.
En cuanto a qué modelo es en última instancia más rentable para completar una tarea, todavía debe juzgarse en función del uso real de tokens, el presupuesto de inferencia y la tasa de éxito de la tarea.
Mirando todo el mercado, Anthropic también está presionando a otros modelos de bajo precio.
Los precios de API del mismo período enumerados por VentureBeat muestran que Google Gemini 3.5 Flash-Lite cuesta $0.3 por millón de tokens de entrada y $2.5 por salida; Gemini 3.8 Flash cuesta $0.75 y $3.75 respectivamente.
Por supuesto, diferentes modelos tienen diferentes posicionamientos de capacidad, estrategias de caché y rendimiento en tareas. Estas cifras reflejan primero la competencia en precios de API.
La guerra de precios entre modelos pequeños se está intensificando aún más.
8 millones de llamadas por semana, las empresas comienzan a hacer que los modelos pequeños trabajen para los grandes
¿Para qué es exactamente adecuado Haiku 5.5?
Los escenarios dados por Anthropic incluyen resumen de documentos, clasificación de información, consultas a bases de datos, compresión de contexto y servir como Subagente en flujos de trabajo complejos de Agentes.
Detrás de esto hay un problema muy realista: los Agentes actuales son cada vez más complejos, y una tarea a menudo requiere múltiples llamadas a modelos. Si cada paso se entrega a un modelo grande, los costos se acumularán rápidamente.
La empresa de IA financiera Rogo ofrece un ejemplo. En su flujo de trabajo, un modelo grande más capaz se encarga de crear presentaciones financieras. Al procesar una diapositiva determinada, el Subagente Haiku 5.5 accede al informe anual 10-K de la empresa, encuentra los datos de ingresos comerciales requeridos y luego entrega el resultado al modelo principal.
Para este tipo de tarea, el modelo necesita completar la búsqueda y extracción de información de forma rápida y precisa. Rogo considera que Haiku 5.5 logra un equilibrio adecuado para llamadas repetidas a gran escala entre precisión, velocidad y precio.
La plataforma de gestión de contenido empresarial Box también proporcionó resultados de pruebas tempranas. En comparación con Haiku 4.5, la puntuación de evaluación interna de Haiku 5.5 aumentó 11 puntos y la latencia se redujo aproximadamente un 50%.
Box declaró que esto hace que el nuevo modelo sea adecuado para trabajos de análisis que necesitan ejecutarse a escala, como informes de costos, resúmenes financieros y revisiones periódicas. Sin embargo, Box no divulgó los criterios de evaluación completos.
Las pruebas de Asana cubrieron tareas de Agente como clasificación de errores, creación de proyectos y búsqueda en grandes carteras de proyectos. Según los resultados que divulgó, en comparación con el modelo que utiliza actualmente, Haiku 5.5 redujo la latencia de finalización de tareas en más del 30% y aumentó la velocidad de inferencia del Agente en una sola ronda hasta 2,5 veces.
Otro ejemplo que demuestra mejor el valor de costo proviene de AlphaSense. La función Ask in Document de esta empresa necesita gestionar alrededor de 8 millones de llamadas por semana, principalmente para responder preguntas específicas sobre uno o varios documentos.
Entre 400 consultas de prueba, la puntuación de evaluación interna de Haiku 5.5 alcanzó 0,84, mientras que la de Haiku 4.5 fue 0,76.
Si se llama a un modelo millones de veces por semana, incluso si solo ahorra una pequeña cantidad de dinero cada vez, el cambio de costo acumulado a largo plazo puede ser considerable.
Estos datos provienen de comentarios tempranos de clientes divulgados por Anthropic. Las cargas de trabajo específicas, los modelos de comparación y los estándares de evaluación no son completamente consistentes, y todavía se necesitan más pruebas independientes.
Sonnet también reduce precios, y la familia Claude 5.5 comienza a competir en costo
Además de Haiku 5.5, Anthropic también ajustó al mismo tiempo el precio de Sonnet 5.5. A partir del 7 de octubre, la tarifa de lectura de caché de Sonnet 5.5 se reducirá en un 50%, de $0,2 por millón de tokens a $0,1.
Anthropic estima que este ajuste puede reducir aún más el costo de la mayoría de las cargas de trabajo de Agente en aproximadamente un 20%, con la reducción real dependiendo del grado en que las aplicaciones reutilicen el contexto en caché.
Para los Agentes que necesitan leer repetidamente historiales de conversación largos, descripciones de herramientas y contexto de tareas, los costos de caché afectan directamente los gastos operativos a largo plazo del sistema.
Anthropic también lanzó créditos mensuales de API para suscriptores de Claude Max y Team: $100 para usuarios de Max 5x, $200 para usuarios de Max 20x y hasta $500 compartidos por usuarios de Team.
Estos créditos pueden usarse para llamadas de modelos en la plataforma Claude, lo que anima a más suscriptores a intentar construir sus propios Agentes y aplicaciones.
Del lado de los desarrolladores, Haiku 5.5 ya está disponible a través de plataformas como la API de Anthropic, Amazon Bedrock, Google Cloud y Microsoft Azure, con el ID de modelo de API claude-haiku-5-5.
Anthropic también actualizó los SDK de Python y TypeScript, añadiendo soporte en fase Beta para operación de navegador y operación de computadora.
En este punto, la división de trabajo de productos en la serie Claude 5.5 ya es bastante clara.
Opus 5.5 se encarga de tareas de razonamiento complejo y alta dificultad, Sonnet 5.5 cubre el trabajo complejo diario y la programación, y Haiku 5.5 se centra en tareas con alto volumen de llamadas, sensibilidad al costo y requisitos de respuesta rápida.
Del 22 de septiembre al 7 de octubre, Anthropic tardó 15 días en completar esta ronda de actualizaciones de productos, con los tres modelos enfatizando el rendimiento y la eficiencia de costos.
El lanzamiento de Haiku 5.5 también hace que una tendencia sea más obvia. A medida que los Agentes pasan gradualmente de las demostraciones a las aplicaciones prácticas, los desarrolladores deben considerar los costos de llamada de todo el sistema. Qué pasos de una tarea requieren un modelo más fuerte, cuáles pueden entregarse a un modelo pequeño y cómo se distribuye el trabajo entre diferentes modelos afectarán la viabilidad comercial final.
Para Anthropic, quizá la parte más atractiva de Haiku 5.5 esté aquí: hace que más tareas que originalmente eran difíciles de escalar debido a costos de llamada excesivamente altos comiencen a volverse económicamente viables.
La competencia entre modelos pequeños ya ha comenzado a penetrar cada eslabón de ejecución del sistema de Agentes.
Materiales de referencia
https://www.anthropic.com/claude-haiku-5-5
https://venturebeat.com/technology/anthropic-launches-claude-haiku-5-5-with-90-api-price-reduction-matching-gpt-6-luna
https://x.com/claudeai/status/2107894042235166750
Este artículo proviene de la cuenta pública de WeChat "Machine Heart" (ID: almosthuman2014), editor: Spoon-billed Sandpiper