Genossen, Anthropic senkt erneut die Preise. Diesmal ist es das günstigste Modell der Claude-Familie, Haiku.
Am 7. Oktober veröffentlichte Anthropic offiziell Claude Haiku 5.5 und behauptet, es sei sein bisher schnellstes, leistungsfähigstes und preisgünstigstes kleines Modell.
Der absurdeste Teil ist der Preis, so niedrig wie 0,1 $ pro Million Eingabe-Token, eine direkte Preissenkung um 90 % im Vergleich zur vorherigen Generation.
Auch die Leistung ist nicht zurückgefallen. Laut den von Anthropic veröffentlichten Testergebnissen übertrifft Haiku 5.5 OpenAIs GPT-6 Luna in mehreren Benchmarks, darunter Computerbedienung, Wissensarbeit und Agent-Programmierung, wobei einige Ergebnisse sogar einen beträchtlichen Abstand aufweisen.
Darüber hinaus führt Haiku 5.5 auch eine einstellbare Argumentationsintensität ein und unterstützt ein Kontextfenster von 1 Million Token sowie eine Ausgabe von bis zu 128.000 Token.
Zu diesem Zeitpunkt hat Anthropic die Aktualisierung der gesamten Claude 5.5-Familie in nur 15 Tagen abgeschlossen: Opus 5.5 kam am 22. September, Sonnet 5.5 wurde am 28. September veröffentlicht, und jetzt ist Haiku 5.5 offiziell beigetreten.
Diesmal hat sich Anthropic auf diejenigen KI-Aufgaben mit massiven Aufrufvolumina und extremer Preissensibilität konzentriert.
Mehrere Ergebnisse übertreffen GPT-6 Luna, Erfolgsquote bei Computerbedienung 72,4 %
Laut den von Anthropic veröffentlichten Benchmark-Ergebnissen hat Haiku 5.5 im Vergleich zur vorherigen Generation erhebliche Verbesserungen erzielt und in einigen Tests sogar bessere Ergebnisse als GPT-6 Luna erreicht.
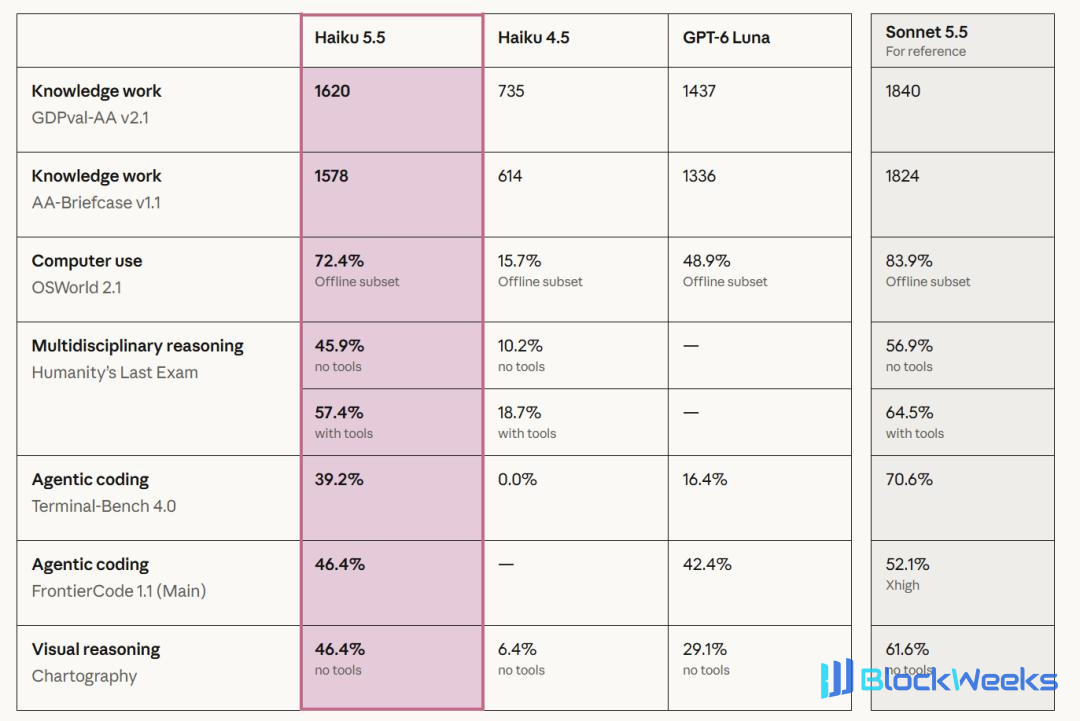
Das bemerkenswerteste Ergebnis stammt von OSWorld. Dies ist ein Test, der die Fähigkeit eines KI-Agenten misst, einen echten Computer zu bedienen, wobei das Modell anwendungsübergreifende, mehrstufige Bedienaufgaben abschließen muss.
Auf dem Offline-Aufgaben-Teilset von OSWorld 2.1 erreichte Haiku 5.5 eine Erfolgsquote von 72,4 %, während die vorherige Generation Haiku 4.5 nur 15,7 % erreichte und GPT-6 Luna 48,9 %.
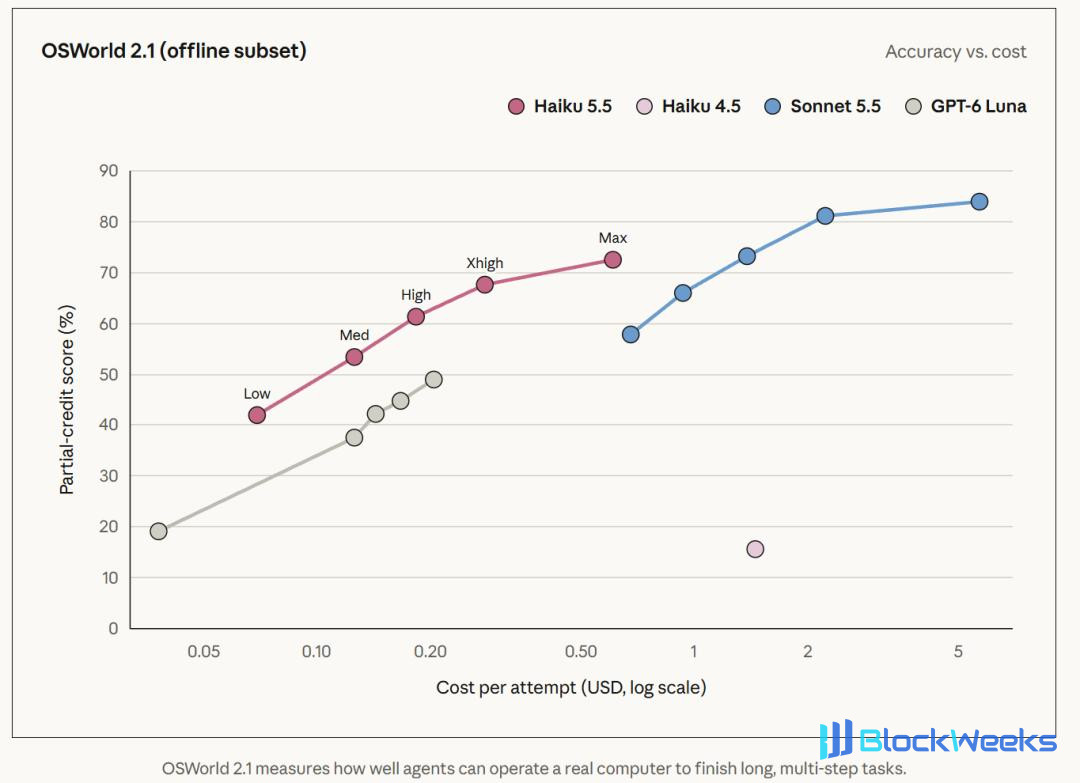
Im Bereich Wissensarbeit erzielte Haiku 5.5 im GDPval-AA v2.1 1620 Punkte und übertraf damit GPT-6 Lunas 1437. Im Agent-Programmierungstest Terminal-Bench 4.0 erzielten die beiden 39,2 % bzw. 16,4 %.
Es gibt jedoch ein wichtiges Detail in diesen Daten. Die höchsten Benchmark-Ergebnisse von Haiku 5.5 erfordern oft mehr Argumentationsrechenleistung.
Haiku 5.5 führt zum ersten Mal in der Haiku-Serie eine einstellbare Argumentationsintensität ein, die es Entwicklern ermöglicht, über den Effort-Parameter zu steuern, wie viele Rechenressourcen das Modell investiert.
Das Medienunternehmen VentureBeat bemerkte, dass im von Anthropic veröffentlichten Terminal-Bench-Test die 39,2 % der maximalen Argumentationsintensität entsprechen. Nach Umschalten auf mittlere Argumentationsintensität sinkt die Punktzahl auf etwa 20 %, und mittlere Intensität ist genau die Standardeinstellung für Haiku 5.5.
Die unabhängige Bewertungsagentur Artificial Analysis beobachtete ein ähnliches Phänomen. In ihrer Intelligence-Index-Bewertung erzielte Haiku 5.5 bei maximaler Argumentationsintensität 43 Punkte und bei mittlerer Argumentationsintensität 34 Punkte. Unter derselben Bewertung betrugen die durchschnittlichen Kosten pro Aufgabe etwa 0,21 $ bzw. 0,05 $.
Mit anderen Worten: Das Modell kann ein erhöhtes Reasoning-Budget gegen eine bessere Aufgabenleistung eintauschen, aber die tatsächlichen Kosten können ebenfalls deutlich steigen.
In seinem eigenen Terminal-Bench 4.0-Test hat Artificial Analysis Werte von 33 % bei maximaler Reasoning-Intensität und 15 % bei mittlerer Intensität gemessen. Aufgrund unterschiedlicher Evaluierungseinstellungen weichen diese Zahlen von den offiziellen Ergebnissen von Anthropic ab.
Das ist auch der Grund, warum man bei der Betrachtung der Leistung kleiner Modelle gleichzeitig die Reasoning-Intensität, die Aufgabenabschlussrate und die tatsächlichen Kosten berücksichtigen muss.
Bei komplexeren Agent-Programmieraufgaben hat Sonnet 5.5 noch einen klaren Vorteil: Seine Terminal-Bench 4.0-Punktzahl erreicht 70,6 %.
Anthropic hat auch klar erklärt, dass Sonnet und Opus weiterhin besser für komplexe Agent-Programmieraufgaben geeignet sind, während die Vorteile von Haiku auf hochfrequente, klar abgegrenzte Arbeiten konzentriert sind.
Preis direkt auf ein Zehntel gesenkt, direkter Wettbewerb mit GPT-6 Luna
Wenn Leistungsverbesserungen Haiku 5.5 wettbewerbsfähig machen, dann ist der Preis möglicherweise das wichtigste Highlight dieser Veröffentlichung. Anthropic hat zwei Stufen der API-Preisgestaltung für das neue Modell entworfen.

Für Anfragen mit einer Prompt-Länge von nicht mehr als 100.000 Token sind die Eingabe- und Ausgabepreise pro Einheit von Haiku 5.5 beide 90 % niedriger als bei der vorherigen Generation. Oberhalb dieser Schwelle ist der Preis immer noch 50 % niedriger als bei Haiku 4.5.
Anthropic gab an, dass etwa 90 % der Anfragen an die vorherige Generation von Haiku innerhalb von 100.000 Token lagen. Unter Berücksichtigung verschiedener Anfragelängen und Änderungen des Token-Verbrauchs schätzt das Unternehmen, dass Haiku 5.5 die durchschnittlichen Kosten für ähnliche Aufgaben um etwa 75 % senkt.
Hier gibt es auch ein leicht zu übersehendes Detail – Haiku 5.5 hat auf einen neuen Tokenizer umgestellt. Laut der offiziellen Entwicklerdokumentation kann derselbe Text im neuen Modell etwa 30 % mehr Token erzeugen als in Haiku 4.5, wobei der genaue Anstieg vom Inhalt abhängt. Daher bedeutet ein Rückgang des API-Einheitspreises um 90 % nicht, dass die Rechnung für jede Aufgabe um 90 % gesenkt werden kann.
Ein weiterer erwähnenswerter Konkurrent ist GPT-6 Luna. Der Basispreis von OpenAI für Luna beträgt ebenfalls 0,1 $ pro Million Eingabe-Token und 0,5 $ für die Ausgabe, und der Cache-Lesepreis stimmt auch mit der Niedrigpreisstufe von Haiku 5.5 überein.
Es gibt jedoch einen klaren Unterschied zwischen den Abrechnungsschwellen für langen Kontext der beiden Unternehmen.
Haiku 5.5 tritt in eine höhere Preisstufe ein, nachdem Prompts 100.000 Token überschreiten; GPT-6 Luna löst erst dann Langkontext-Zuschläge aus, wenn die Eingabe 272.000 Token überschreitet. Das bedeutet, dass Luna bei Anfragen zwischen 100.000 und 272.000 Token einen Vorteil beim Preis pro Token-Einheit hat.
Welches Modell letztendlich für die Erledigung einer Aufgabe kosteneffizienter ist, muss noch anhand des tatsächlichen Token-Verbrauchs, des Inferenzbudgets und der Erfolgsrate der Aufgabe beurteilt werden.
Betrachtet man den gesamten Markt, setzt Anthropic auch andere Niedrigpreismodelle unter Druck.
Die von VentureBeat aufgeführten API-Preise für denselben Zeitraum zeigen, dass Google Gemini 3.5 Flash-Lite 0,3 $ pro Million Eingabe-Token und 2,5 $ für die Ausgabe kostet; Gemini 3.8 Flash kostet 0,75 $ bzw. 3,75 $.
Natürlich haben verschiedene Modelle unterschiedliche Fähigkeitspositionierungen, Caching-Strategien und Aufgabenleistungen. Diese Zahlen spiegeln zunächst den Wettbewerb bei den API-Preisen wider.
Der Preiskampf unter den kleinen Modellen eskaliert weiter.
8 Millionen Aufrufe pro Woche, Unternehmen beginnen, kleine Modelle für große Modelle arbeiten zu lassen
Wofür genau ist Haiku 5.5 geeignet?
Die von Anthropic genannten Szenarien umfassen Dokumentenzusammenfassung, Informationsklassifizierung, Datenbankabfragen, Kontextkomprimierung und die Funktion als Subagent in komplexen Agent-Workflows.
Dahinter steht ein sehr realistisches Problem: Die heutigen Agents werden immer komplexer, und eine Aufgabe erfordert oft mehrere Modellaufrufe. Wenn jeder Schritt an ein großes Modell übergeben wird, summieren sich die Kosten schnell.
Das Finanz-KI-Unternehmen Rogo liefert ein Beispiel. In seinem Workflow ist ein leistungsfähigeres großes Modell dafür verantwortlich, Finanzpräsentationsdecks zu erstellen. Bei der Verarbeitung einer bestimmten Folie tritt der Haiku 5.5 Subagent in den 10-K-Jahresbericht des Unternehmens ein, findet die erforderlichen Geschäftsumsatzdaten und übergibt das Ergebnis dann an das Hauptmodell.
Für diese Art von Aufgabe muss das Modell die Informationssuche und -extraktion schnell und präzise abschließen. Rogo ist der Ansicht, dass Haiku 5.5 ein Gleichgewicht erreicht, das für groß angelegte wiederholte Aufrufe geeignet ist, und zwar zwischen Genauigkeit, Geschwindigkeit und Preis.
Die Enterprise-Content-Management-Plattform Box lieferte ebenfalls frühe Testergebnisse. Im Vergleich zu Haiku 4.5 stieg die interne Bewertung von Haiku 5.5 um 11 Punkte, und die Latenz sank um etwa 50 %.
Box erklärte, dass dies das neue Modell für Analysearbeiten geeignet mache, die im großen Maßstab ausgeführt werden müssen, wie Kostenberichte, Finanzzusammenfassungen und regelmäßige Überprüfungen. Box gab jedoch die vollständigen Bewertungskriterien nicht bekannt.
Die Tests von Asana deckten Agent-Aufgaben wie Fehlerklassifizierung, Projekterstellung und die Suche in großen Projektportfolios ab. Den veröffentlichten Ergebnissen zufolge reduzierte Haiku 5.5 im Vergleich zum derzeit verwendeten Modell die Latenz bei der Aufgabenfertigstellung um mehr als 30 % und erhöhte die Inferenzgeschwindigkeit des Agenten pro Runde um bis zu das 2,5-Fache.
Ein weiteres Beispiel, das den Kostenwert besser veranschaulicht, stammt von AlphaSense. Die Funktion „Ask in Document“ dieses Unternehmens muss etwa 8 Millionen Aufrufe pro Woche verarbeiten und beantwortet hauptsächlich spezifische Fragen zu einem oder mehreren Dokumenten.
Unter 400 Testabfragen erreichte die interne Bewertung von Haiku 5.5 0,84, während Haiku 4.5 bei 0,76 lag.
Wenn ein Modell Millionen Male pro Woche aufgerufen wird, kann selbst dann, wenn es jedes Mal nur ein wenig Geld spart, die langfristig angesammelte Kostenveränderung beträchtlich sein.
Diese Daten stammen aus frühem Kundenfeedback, das Anthropic veröffentlicht hat. Die konkreten Arbeitslasten, Vergleichsmodelle und Bewertungsstandards sind nicht vollständig konsistent, und weitere unabhängige Tests sind noch erforderlich.
Sonnet senkt ebenfalls die Preise, und die Claude 5.5-Familie beginnt, über Kosten zu konkurrieren
Neben Haiku 5.5 hat Anthropic gleichzeitig auch die Preisgestaltung von Sonnet 5.5 angepasst. Ab dem 7. Oktober wird die Cache-Lesegebühr von Sonnet 5.5 um 50 % gesenkt, von 0,2 US-Dollar pro Million Tokens auf 0,1 US-Dollar.
Anthropic schätzt, dass diese Anpassung die Kosten der meisten Agent-Arbeitslasten um etwa 20 % weiter senken kann, wobei die tatsächliche Reduzierung davon abhängt, in welchem Umfang Anwendungen zwischengespeicherten Kontext wiederverwenden.
Für Agenten, die wiederholt lange Gesprächsverläufe, Tool-Beschreibungen und Aufgabenkontext lesen müssen, wirken sich Cache-Kosten direkt auf die langfristigen Betriebsausgaben des Systems aus.
Anthropic führte außerdem monatliche API-Guthaben für Claude Max- und Team-Abonnenten ein: 100 US-Dollar für Max 5x-Nutzer, 200 US-Dollar für Max 20x-Nutzer und bis zu 500 US-Dollar, die von Team-Nutzern gemeinsam genutzt werden.
Diese Guthaben können für Modellaufrufe auf der Claude-Plattform verwendet werden und ermutigen mehr Abonnenten, den Aufbau eigener Agenten und Anwendungen auszuprobieren.
Auf der Entwicklerseite ist Haiku 5.5 bereits über Plattformen wie die Anthropic API, Amazon Bedrock, Google Cloud und Microsoft Azure verfügbar, mit der API-Modell-ID claude-haiku-5-5.
Anthropic aktualisierte außerdem die Python- und TypeScript-SDKs und fügte Unterstützung für Browser-Bedienung und Computer-Bedienung in der Beta-Phase hinzu.
Zu diesem Zeitpunkt ist die Produktaufgabenteilung in der Claude 5.5-Serie bereits recht klar.
Opus 5.5 übernimmt hochschwierige, komplexe Reasoning-Aufgaben, Sonnet 5.5 deckt tägliche komplexe Arbeit und Programmierung ab, und Haiku 5.5 konzentriert sich auf Aufgaben mit hohem Aufrufvolumen, Kostenempfindlichkeit und Anforderungen an schnelle Reaktion.
Vom 22. September bis zum 7. Oktober benötigte Anthropic 15 Tage, um diese Runde von Produktaktualisierungen abzuschließen, wobei alle drei Modelle Leistung und Kosteneffizienz betonen.
Die Veröffentlichung von Haiku 5.5 macht außerdem einen Trend deutlicher. Während Agenten allmählich von Demonstrationen zu praktischen Anwendungen übergehen, müssen Entwickler die Aufrufkosten des gesamten Systems berücksichtigen. Welche Schritte in einer Aufgabe ein stärkeres Modell erfordern, welche an ein kleines Modell übergeben werden können und wie die Arbeit unter verschiedenen Modellen aufgeteilt wird, all das beeinflusst die endgültige kommerzielle Tragfähigkeit.
Für Anthropic ist vielleicht der attraktivste Teil von Haiku 5.5 genau hier: Es macht mehr Aufgaben, die ursprünglich aufgrund übermäßig hoher Aufrufkosten schwer zu skalieren waren, allmählich wirtschaftlich tragfähig.
Der Wettbewerb unter kleinen Modellen hat bereits begonnen, in jedes Ausführungsglied des Agent-Systems einzudringen.
Referenzmaterialien
https://www.anthropic.com/claude-haiku-5-5
https://venturebeat.com/technology/anthropic-launches-claude-haiku-5-5-with-90-api-price-reduction-matching-gpt-6-luna
https://x.com/claudeai/status/2107894042235166750
Dieser Artikel stammt vom WeChat-öffentlichen Account „Machine Heart“ (ID: almosthuman2014), Redakteur: Löffelschnepfe